Zusammenfassung:
DeepSeek hat sich ebenfalls dem Parameterwettbewerb angeschlossen. Laut The Information trainiert DeepSeek derzeit ein neues Modell mit etwa 2 Billionen Parametern; Liang Wenfeng erklärte kürzlich bei einem Investorentreffen auch, dass der nächste Schritt des Unternehmens darin bestehe, das Modell weiter auf 8 Billionen Parameter zu bringen. Vor einem Jahr waren 8 Billionen noch eine unvorstellbare Zahl.
Aber jetzt hat Kimi K3 2,8 Billionen Parameter erreicht; Byte trainiert vorab ein neues Modell, das bis zu 10 Billionen Parameter erreichen kann; Alibaba hat außerdem öffentlich erklärt, dass das Modell der nächsten Generation auf 5 bis 10 Billionen Parameter zusteuern wird. Anthropic gibt keine Modellparameter bekannt, aber FT hat zuvor Branchenschätzungen zitiert, denen zufolge sein neuestes Flaggschiff Mythos 5 etwa 8 Billionen Parameter aufweist.
Das große Model drehte sich im Kreis und begann erneut zu konkurrieren, um zu sehen, wer größer war.
Nur dieses Mal sind die Parameter, die jeder einführt, nicht mehr dieselben Parameter wie in der vorherigen Skalierungsrunde.
Als DeepSeek im April dieses Jahres V4-Pro veröffentlichte, betrug der offiziell veröffentlichte Umfang 1,6 Billionen Gesamtparameter und 49 Milliarden Aktivierungsparameter.
Der Folgeplan beläuft sich auf 8 Billionen RMB, was dem Fünffachen von V4-Pro entspricht.
Das ist eigentlich ziemlich ungewöhnlich, wenn es um DeepSeek geht. Schließlich hat DeepSeek letztes Jahr den tiefsten Eindruck in der gesamten KI-Branche hinterlassen, nicht in Bezug auf die Parameter.
Es hat einmal dazu geführt, dass die KI-Branche erneut darüber diskutiert hat, dass hochmoderne Modelle die GPU vielleicht nicht unendlich belasten müssen.
Wenn V3 Ende 2024 veröffentlicht wird, legt DeepSeek die Trainingsrechnung bewusst auf den Tisch: 671 Milliarden Gesamtparameter, 37 Milliarden aktivierte Parameter pro Token und das vollständige Training verbraucht 2,788 Millionen H800-GPU-Stunden. Berechnet auf 2 US-Dollar pro GPU-Stunde betragen die offiziellen Schulungskosten nur 5,576 Millionen US-Dollar.
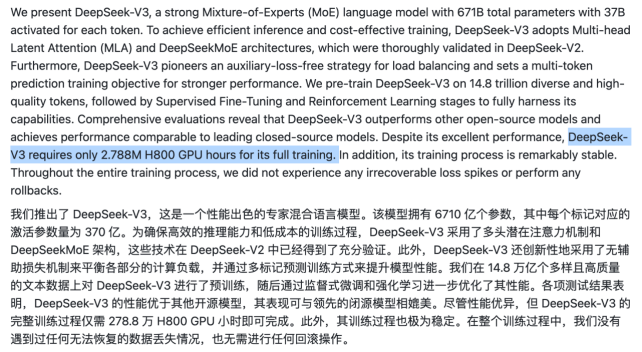
Diese Zahl und die Effizienz dahinter wurden später zu einem der wichtigsten Labels für DeepSeek.
DeepSeek verfügt nicht über ein reichhaltiges Angebot an fortschrittlichen GPUs wie OpenAI und Anthropic; Das Unternehmen verlässt sich bei der Quantifizierung seiner Selbsttransfusion seit langem auf Huanfang von Liang Wenfeng und akzeptiert keine externe Finanzierung. Seine Bedingungen bestimmen seinen Weg – da Geld und Rechenleistung begrenzt sind, sollte die Leistung aus Architektur, Training und Inferenzeffizienz maximiert werden.
Aber jetzt haben sich die Bedingungen geändert.
DeepSeek hat gerade seine erste externe Finanzierungsrunde seit seiner Gründung im Juni dieses Jahres abgeschlossen und dabei rund 7,4 Milliarden US-Dollar eingesammelt. Derzeit befindet sich die zweite Finanzierungsrunde über rund 50 Milliarden RMB (ca. 7,5 Milliarden US-Dollar) in der Abschlussphase, was einer Bewertung von rund 500 Milliarden RMB entspricht. Wenn diese Finanzierung erfolgreich abgeschlossen wird, wird sich die kumulierte externe Finanzierung von DeepSeek innerhalb weniger Monate auf knapp 15 Milliarden US-Dollar und etwa 100 Milliarden Yuan belaufen.
Gleichzeitig hat DeepSeek CITIC Securities beauftragt, den Börsengang des Science and Technology Innovation Board vorzubereiten, und das neue Kapital wird eindeutig für Computerinfrastruktur, Modellentwicklung und Talentinvestitionen verwendet; Am 21. September trat Yan Wentao, ein ehemaliger Partner von Hillhouse Venture Partners, offiziell DeepSeek bei und fungierte als CFO und beendete damit die Stelle als CFO in den drei Jahren seit der Gründung des Unternehmens.
In der Vergangenheit hat DeepSeek nur begrenzte Mittel und Rechenleistung eingesetzt, um das Modell so gut wie möglich zu machen. nun werden Finanzierung und Listung vorangetrieben. Mit mehr Geld lässt sich auch die Rechenleistung steigern.
Sobald die Bedingungen erfüllt sind, beginnt DeepSeek auch mit der mutigen Einführung von Parametern.
Dies steht nicht im Widerspruch zum Streben nach Effizienz. Bei hoher Effizienz kann die Skala mit dem gleichen Geld erweitert werden.
In den letzten zwei Monaten ist die Gesamtparameterskala modernster Modelle deutlich gestiegen.
Dieser Wettbewerb rückt durch The Dark Side of the Moon wieder ins Rampenlicht. Im Juli dieses Jahres erreichte Kimi K3 2,8 Billionen Gesamtparameter und 104 Milliarden Aktivierungsparameter. K3 ist immer noch das offene Gewichtsmodell mit der größten Parameterskala, das offiziell veröffentlicht wurde.
Es ist nicht nur groß. In der offiziellen Bewertung erreichte K3s GPQA Diamond 93,5 und Terminal-Bench 2.1 88,3, was im gleichen Zeitraum sehr nahe an GPT-5.6 Sol und Claude Fable 5 liegt. Die Skala hat Billionen erreicht und die Leistung hat die erste Stufe erreicht.
Im August wurde bekannt, dass Byte plant, größer zu werden.
Am 6. August gab „LatePost“ erstmals bekannt, dass Byte unter der Leitung von Xiang Liang, Leiter der Seed Foundation, über das Training eines neuen Modells mit mehr als 5 Billionen Parametern diskutiert. Berichten zufolge scheint Byte intern davon überzeugt zu sein, dass es besser ist, die Parameterskala um ein Vielfaches höher zu treiben als die seiner Mitbewerber, anstatt die bestehende Größe weiter einzuholen.
Einen Tag später, am 7. August, berichtete FT unter Berufung auf mit der Angelegenheit vertraute Personen, dass der Umfang des neuen Modells, das von Byte vorab trainiert wird, bis zu 10 Billionen Parameter erreichen könnte; Als Reuters nachfragte, verglich es es auch mit Anthropics hochmodernem Mythos – obwohl letzterer die Parameterskala nie offengelegt hat, liegen Branchenschätzungen bei etwa 8 Billionen. Wenn das neue Modell von Byte 10T erreicht, wird es die derzeit von Mythos verbreitete Größenordnung überschreiten.
Mittlerweile tauchen immer wieder extrem große Parametergrößen von mehr als 5T in der Diskussion modernster Modelle auf.
Heute gab Wu Yongming, CEO von Alibaba, öffentlich bekannt, dass das Modell der nächsten Generation 5 bis 10 Billionen Parameter erreichen soll; DeepSeek trainiert ein 2T-Modell und setzt das Folgeziel auf 8T. Es ist verständlich, dass das Hauptlabor erneut eine größere Gesamtparameterskala als einen wichtigen Weg zur Beeinflussung der Obergrenze der Fähigkeiten angesehen hat.
Selbst amerikanische Closed-Source-Modelle, die keine Parameter offenlegen, können sich einer externen Prüfung nicht entziehen. Anthropics Mythos wird von Außenstehenden auf 8T geschätzt; OpenAI hat den Modellmaßstab seit der GPT-4-Ära nicht mehr offengelegt, aber es gibt in der Community das Gerücht, dass Astra ein 10T MoE erreicht hat.
Die Anzahl der Parameter hat nie an Reiz verloren, genau wie der Wert der Kampfkraft auf dem Spielfeld – die Leute wissen, dass sie nicht alles darstellen können, aber es wird immer die intuitivste und bedrückendste Zahl sein.
Tatsächlich redet die große Modellbranche schon seit einiger Zeit nicht mehr so gerne über Parameter.
In den letzten zwei Jahren wechselten sich Destillation, kleine Modelle, MoE, Reinforcement Learning und Inferenzzeitberechnungen ab. Anstatt damit anzugeben, dass sie über Hunderte Milliarden oder Billionen Parameter verfügen, sind Modellhersteller eher bereit, über Leistung, Kosten und Effizienz zu sprechen. Wenn Sie das Modell einfach vergrößern, sieht es schnell so aus, als hätten Sie zwar Geld, aber keinen Platz, wo Sie es ausgeben können.
Heute wurden die Parametermengen erneut erhöht und sind wieder zur „Vorderseite“ modernster Modelle geworden.
Die heutigen 5T, 8T und 10T sind jedoch nicht mehr dasselbe wie „je mehr Parameter, desto größer das Modell“ in der vorherigen Skalierungsrunde.
Der direkteste Grund, warum Parametermengen wieder auf den Tisch gebracht werden können, ist, dass sich die Mainstream-Architektur ultragroßer Modelle geändert hat.
In der Vergangenheit war der Mainstream großer Modelle die dichte Architektur, bei der Parameterskala und Berechnungsumfang grundsätzlich miteinander verknüpft waren. Vereinfacht ausgedrückt bedeutet dies, wie viele Parameter es im Modell gibt und diese grundsätzlich bei jeder Berechnung zusammen eingegeben werden müssen. Je mehr Parameter vorhanden sind, desto höher ist tendenziell die Obergrenze der Fähigkeiten, aber auch die Kosten für Training und Schlussfolgerung steigen.
Heutzutage nutzen immer mehr große Modelle MoE, Mixture of Experts und Mixed-Expert-Architektur.
Es ist eher ein Unternehmen mit vielen Experten. Das Modell kann Hunderte oder Tausende von Experten haben, aber nur ein kleiner Teil von ihnen wird für die Arbeit an jeder Aufgabe ausgewählt. Kimi K3 hat beispielsweise insgesamt 2,8T Parameter, aber jeder Token aktiviert nur 104B, etwa 3,7%; DeepSeek V4-Pro hat insgesamt 1,6T Parameter und jeder Token aktiviert nur 49B, etwa 3 %.
Wenn ein Modell heute also 5T-, 8T- oder sogar 10T-Parameter hat, bedeutet das nicht, dass es diese 10T-Parameter jedes Mal durchlaufen muss, wenn es einen Token generiert.
Wie viel das Modell aufnehmen kann und wie viel jedes Mal berechnet werden muss, sind zu zwei unterschiedlichen Zahlen geworden.
Parameter können als der Raum verstanden werden, den das Modell nutzt, um Wissen, Muster und Fähigkeiten zu transportieren. Je größer die Gesamtparameter sind, desto mehr Platz hat das Modell theoretisch, um immer komplexere Verteilungen zu lernen; MoE ermöglicht es, einige davon nur bei Bedarf aufzurufen.
Dadurch kann das Modell die Gesamtparameterkapazität weiter erhöhen, ohne dass jede Berechnung von Jahr zu Jahr aufwändiger wird.
Nehmen wir immer noch K3 als Beispiel: Es hat einen Gesamtparameter von 2,8T, was etwa dem Dreifachen des Maßstabs von K2.5 entspricht, aber unter 896 Experten sind nur 16 von jedem Token aktiviert. Dark Side of the Moon sagte, dass dank des geringeren MoE und einer Reihe von Architekturoptimierungen die Gesamtskalierungseffizienz von K3 im Vergleich zu K2 um etwa das 2,5-fache verbessert wurde.
Die Agenten-Ära hat diese „Fähigkeit“ gerade wieder in den Mittelpunkt des Wettbewerbs gerückt.
In der Vergangenheit wurde die Fähigkeit eines Chatbots oft einzeln gemessen. In der Mathematik geht es um Mathematik, bei Code um Code und bei Fragen und Antworten um Wissen. Wenn das Modell bei mehreren wichtigen Benchmarks höhere Spitzenwerte erreicht, genügt das als Beweis dafür, dass es sehr stark ist.
Aber der Agent reiht diese Funktionen in dieselbe Aufgabenkette ein. Eine wirklich lange Aufgabe kann damit beginnen, nach Informationen zu suchen, dann Webseiten zu lesen, Bilder anzusehen, Code zu schreiben, das Terminal anzurufen und dann auf Fehler zu stoßen, den Plan zu ändern, andere Tools aufzurufen und sogar Unteraufgaben anderen Agenten zuzuweisen.
Als OpenAI im September dieses Jahres die Agenten-API veröffentlichte, listete es direkt die langfristige Ausführung, Kontextverwaltung, Tool-Nutzung und Subagenten-Koordination als Kerninfrastruktur des Agenten auf und betonte, dass der Agent stunden- oder sogar tagelang zuverlässig laufen muss.
Wenn in einer Frage-und-Antwort-Runde gelegentlich eine bestimmte Fähigkeit fehlschlägt, geht möglicherweise nur eine Frage verloren. In einer Agentenaufgabe, die Dutzende oder Hunderte von Schritten umfasst, kann jedes schwache Glied die gesamte Verbindung unterbrechen. Je länger die Aufgabe dauert, desto höher sind die Anforderungen an die Fähigkeitsabdeckung und Stabilität. Infolgedessen hat der Grenzwettbewerb begonnen, einen offensichtlichen „Fasseffekt“ zu entfalten.
METR verwendet jetzt sogar direkt die „Aufgabenzeitspanne“, um die Agentenfähigkeiten zu messen, denn je länger die Aufgabe, desto höher ist die Anforderung an das Modell, kontinuierlich eine Reihe verschiedener Vorgänge abzuschließen.
In der Chatbot-Ära ist es einfacher, den Höhepunkt der Fähigkeiten zu erkennen, während in der Agenten-Ära die Fähigkeitsabdeckung immer wichtiger wird.
Zu diesem Zeitpunkt hat eine größere Parameterkapazität einen neuen Wert. Je länger die Aufgabe dauert, desto weniger voreingenommen muss das Modell sein. Je mehr Dinge der Agent tun kann, desto breiter sind die Fähigkeiten, die die Basis abdecken muss.
MoE eröffnet Raum für eine weitere Kapazitätserweiterung und Agent steigert den Wert der Kapazität weiter. Daher versuchen die Modellhersteller ihr Bestes, um die Effizienz zu verbessern und gleichzeitig die Parameter wieder auf 5T, 8T und 10T zu erhöhen.
Die eingesparte Rechenleistung ließ Scaling nicht verschwinden, sondern schuf neuen Raum für Scaling.
Kommentare