
Zusammenfassung:
Apples Forschungsteam enthüllt Fortschritte in der Forschung zum „Gehirn“ von Robotern. Am 4. November Ortszeit reichte das Apple-Forschungsteam den Artikel „Perceptive Humanoid Motion from Simulation“ auf der Preprint-Plattform arXiv ein und enthüllte das autonome Steuerungssystem für humanoide Roboter HALO. Das Forschungsteam setzte das System zur Verifizierung auf dem humanoiden G1-Roboter von Yushu Technology ein, sodass der Roboter die in der Simulationsumgebung erlernten Aktionen ausführen und sie in einem unbekannten realen Raum ausführen konnte.
Das Forschungsteam hat außerdem den Datengenerierungs-, Modellschulungs- und Bereitstellungscode offengelegt, der Aktionsgenerierung, Aktionsverfolgung, Aufgabenorchestrierung, Simulation und realen Roboterbetrieb abdeckt.
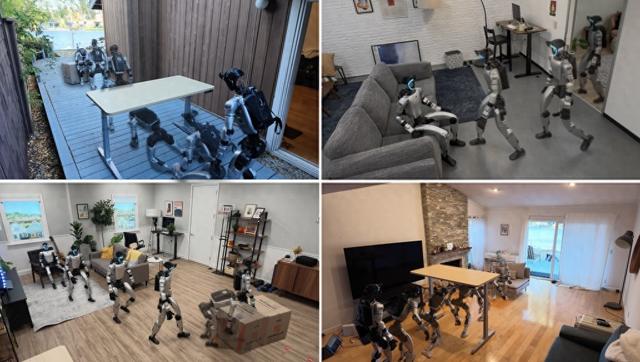
Der Yushu G1-Roboter ist ausgestattet mit dem HALO-System demonstriert Aufgaben wie das Kriechen unter den Tisch, das Sitzen auf dem Sofa und das Schieben von Kisten in verschiedenen realen Umgebungen. Bildquelle: HALO-Forschungsteam
Auf der Projektseite ist zu sehen, wie der Roboter Anweisungen befolgt, Kisten zu schieben, Menschen zu folgen, auf Stühlen zu sitzen, seitwärts durch eine halboffene Tür zu gehen, sich zu bücken oder unter einen Tisch zu kriechen usw. Für diese Aufgaben muss der Roboter seine Umgebung verstehen und seine Körperhaltung den räumlichen Gegebenheiten anpassen.
Bei der Ausführung von Aufgaben wird HALO durch drei Ebenen kollaborativ gesteuert. Die oberste Ebene ist das Aufgabenorchestrierungsmodul basierend auf dem visuellen Sprachmodell (VLM). Standardmäßig wird Qianwen Qwen3.6-35B-A3B verwendet. Es läuft lokal auf dem Mac mini, mit dem der Roboter ausgestattet ist. Es teilt sich die Modellservice-Engine mit dem Aktionsgenerator und kann ohne Internetverbindung arbeiten. Das System kann sich auch dafür entscheiden, das Cloud-Modell über die API aufzurufen, um stärkere Argumentations- und Planungsfähigkeiten zu erhalten.
Diese Ebene muss die unscharfen Informationen in den Anweisungen verarbeiten und Aktionen entsprechend der Umgebung anordnen. „Hinsetzen“ hat beispielsweise kein klar definiertes Ziel und erfordert, dass der Roboter anhand der Szene vor ihm bestimmt, wo er sitzen soll; „Auf einem Stuhl sitzen“ kann direkt ausgeführt werden, wenn der Weg frei ist. Wenn jedoch ein Tisch den Weg versperrt, muss die Aufgabe in kontinuierliche Teilaufgaben unterteilt werden, z. B. sich vorbeugen, sich dem Stuhl nähern und sich hinsetzen. Das Aufgabenorchestrierungsmodul beobachtet kontinuierlich die Umgebung durch das Video aus der Perspektive des Roboters, stellt fest, ob die aktuelle Aktion erfolgreich ist, treibt den Plan voran oder versucht es entsprechend erneut, wobei es jedes Mal eine klare Unteraufgabe an den Aktionsgenerator sendet.
Die Aktionsgenerierungsschicht in der Mitte verwendet ein anderes Qianwen-Modell Qwen3.5-2B. Das Forschungsteam nutzt es als Encoder zum Einfrieren von Parametern und arbeitet mit dem DiT-Decoder zusammen, der für die Generierung von Aktionen zur Planung der gesamten Körperbewegungen für etwa fünf Sekunden in der Zukunft verantwortlich ist, basierend auf den vom Roboter gesehenen Bildern und der aktuellen Unteraufgabe. Diese Ebene wird etwa dreimal pro Sekunde neu geplant, sodass der Aktionsplan kontinuierlich aktualisiert werden kann, wenn sich die Umgebung ändert.
Die unterste Ebene ist ein Aktions-Tracker, der durch verstärkendes Lernen, Richtliniendestillation und andere Schritte trainiert wird. Es läuft mit einer Frequenz von 50 Mal pro Sekunde, kombiniert Tiefenbilder und den eigenen Status des Roboters und wandelt Aktionspläne in gemeinsame Steueranweisungen um.
Die drei Ebenen sind jeweils für die Aufgabenanordnung, die Aktionsplanung und die Körperkontrolle verantwortlich und vervollständigen gemeinsam den Prozess vom Verstehen von Anweisungen bis zur Ausführung von Aktionen.
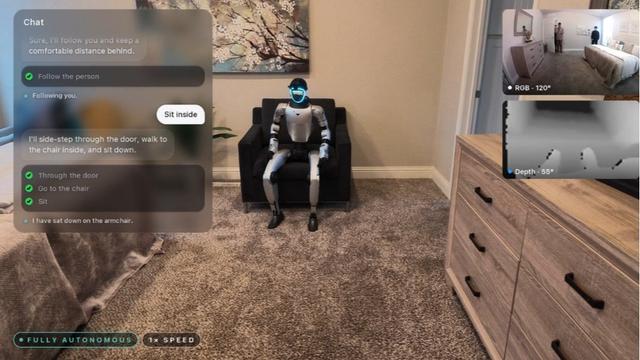
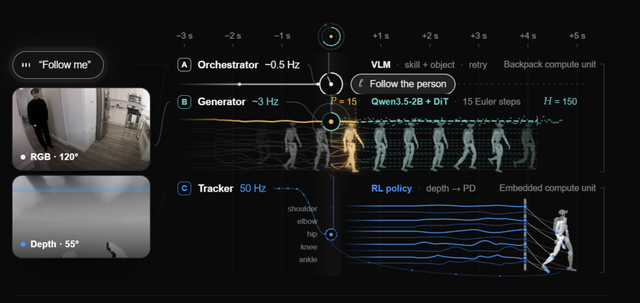
Die dreischichtige Steuerungsarchitektur von HALO: Das visuelle Sprachmodell ist für die Aufgabenorchestrierung verantwortlich, das Generierungsmodul plant die gesamten Körperbewegungen und der durch Verstärkungslernen trainierte Aktionstracker führt die gemeinsame Steuerung durch. Bildquelle: Mosaik aus Screenshots von der HALO-Projektseite
Dem Papier zufolge führte das Forschungsteam 360 Einzelaufgabentests in 6 realen Umgebungen ohne Vorscan oder Kartierung durch, mit einer durchschnittlichen Erfolgsquote von 91 %. In einer anderen realen Umgebung wurden 10 Tests zu drei kombinierten Aufgaben durchgeführt, und die durchschnittliche Erfolgsquote betrug 70 %. Unter ihnen beträgt die Erfolgsquote der Kombination „über das Hindernis beugen – auf das Ziel zugehen – die Kiste schieben“ 50 %.
Wie Roboter die für die Ausführung dieser Aufgaben erforderlichen Daten erhalten, steht im Mittelpunkt dieser Forschung. Das Forschungsteam synthetisierte etwa 300 Stunden primäre Trainingsdaten in 1.000 programmgenerierten simulierten häuslichen Umgebungen, um abzugleichen, „was der Roboter sah“, „welche Anweisungen er erhielt“ und „wie er sich bewegte“.
Konkret generiert das System zunächst Aktionen, platziert die Aktionen dann im virtuellen Raum und generiert schließlich Bilder aus der Perspektive des Roboters. Die Projektseite nimmt als Beispiel „Auf einem Sessel sitzen“ und unterteilt es in Segmente wie Vorwärtsgehen, Umdrehen und Hinsetzen. Das Aktionsgenerierungsmodell generiert Aktionssequenzen basierend auf Textaufforderungen, Wegpunkten und Schlüsselhaltungen. Die Aktionen werden dann durch geometrische Kontrollen überprüft, um Probleme wie das Abrutschen des Fußes und das Eindringen des Körpers in den Boden zu reduzieren.
Dann ordnet das System die Aktionen im programmgenerierten Raum an, überprüft die Positionsbeziehung zwischen dem Roboter und den Möbeln, sucht nach einem kollisionsfreien Platzierungsplan und verwendet dann Simulationstools, um zu rendern, was der Roboter sieht, wenn er die Aktion ausführt. Während des Trainings werden auch Bedingungen wie Beleuchtung, Farbton und Bildunschärfe geändert, um den visuellen Input vielfältiger zu gestalten. Auf diese Weise kann derselbe Prozess unterstützende Daten generieren, einschließlich Anweisungen, visuelle Bilder und Ganzkörperbewegungen.
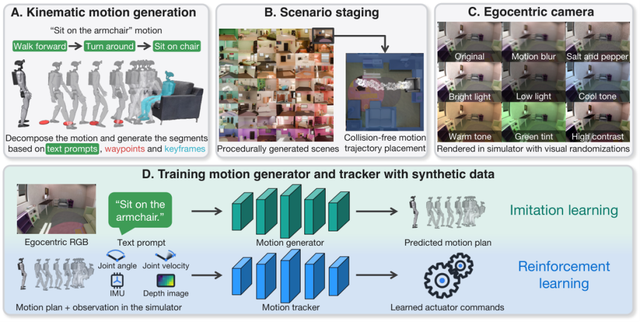
HALOs synthetischer Datengenerierungs- und Trainingsprozess: Erzeugen Sie zunächst eine Aktionsbahn, fügen Sie sie in die virtuelle Szene ein und rendern Sie dann das Bild aus der Perspektive des Roboters, um unterstützende Trainingsdaten für das Training des Aktionsgenerators und des Aktionstrackers zu erstellen. Bildquelle: HALO-Papier
Berichten zufolge nutzte das Forschungsteam 250 NVIDIA H100-GPUs und benötigte etwa 48 Stunden, um die wichtigsten Trainingsdaten zu synthetisieren. Der Aktionsgenerator wird durch Nachahmungslernen mit 64 B200 trainiert; Der Action-Tracker wird durch verstärkendes Lernen, Richtliniendestillation und andere Schritte unter Verwendung von 4 H100 trainiert.
Es sollte darauf hingewiesen werden, dass die durch die Simulation generierten Daten die menschliche Beteiligung nicht vollständig beseitigen. Das Team gab an, dass die neuen physischen Aufgaben immer noch das manuelle Schreiben von Aufforderungswörtern und die Gestaltung von Aktionsschlüsselbildern erfordern und dass bei einigen Aktionen auch menschliche Video- oder Motion-Capture-Materialien zum Einsatz kommen.
Das Forschungsteam wies auch darauf hin, dass Roboter derzeit hauptsächlich auf die visuelle Wahrnehmung angewiesen sind und es schwierig ist, Kontaktsituationen direkt wahrzunehmen; Wenn Objekte das Sichtfeld der Kamera verlassen oder verdeckt werden, nimmt die Leistung von Aufgaben mit mehr Kontakten ab. Die Erweiterung der taktilen Wahrnehmung ist eine der Richtungen für spätere Verbesserungen.
Kommentare