Zusammenfassung:
Ein von einem Entwickler durchgeführtes Experiment zeigt, dass die Verbindung des iPhone 17 Pro Max mit einem MacBook Pro, das mit einem M4 Pro-Chip ausgestattet ist, über eine angepasste Software die Betriebseffizienz des lokalen großen Sprachmodells erheblich verbessern kann. Beim Betrieb des Modells Qwen3.8-27B wird die Vorfüllleistung des Systems um bis zu 44 % verbessert.
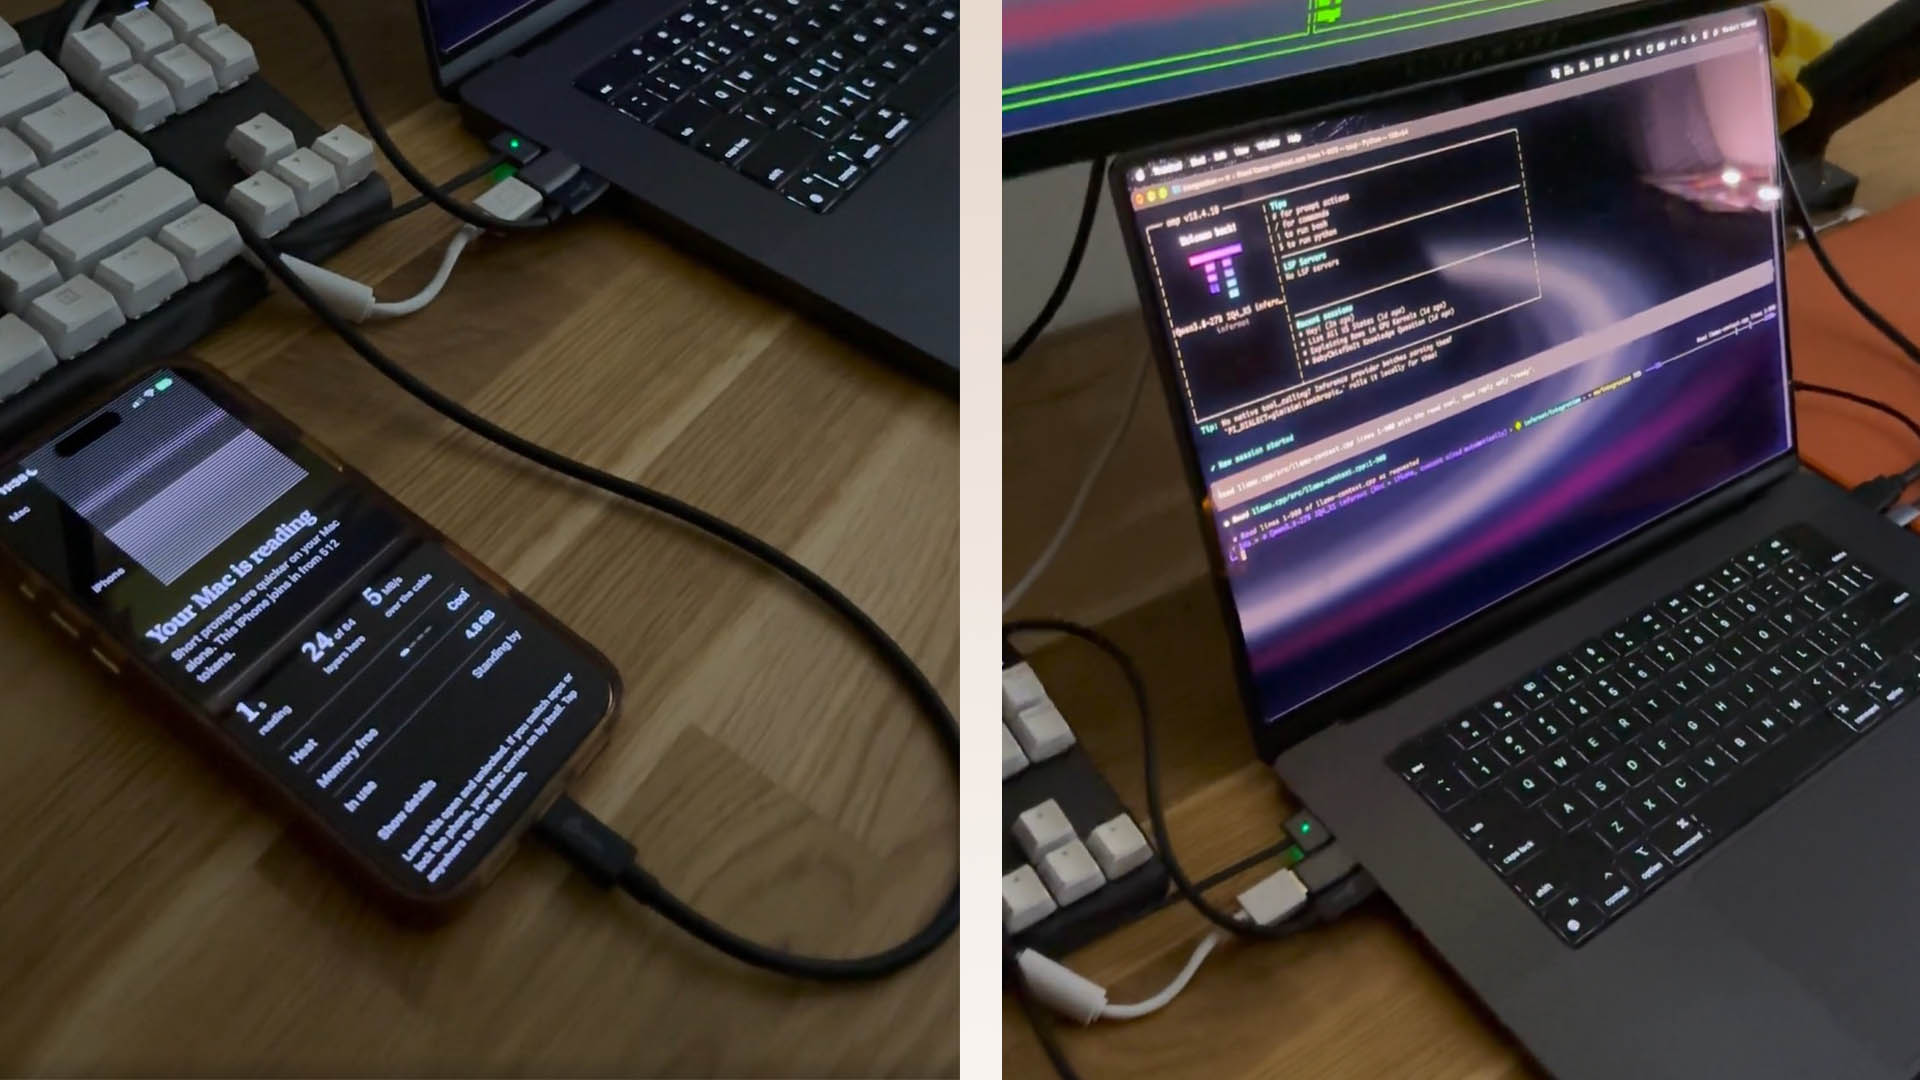
Der Hintergrund dieses Experiments ist, dass große Sprachmodelle extrem hohe Anforderungen an den Videospeicher und die Systemspeicherkapazität stellen. Obwohl das mit dem M4 Pro-Chip ausgestattete MacBook Pro über 24 GB einheitlichen Speicher verfügt, ist es bei der Ausführung eines großen Modells mit 27 Milliarden Parameterebenen immer noch durch die Speicherkapazität und die Kontextfenstergröße begrenzt. Entwickler versuchten daher, das iPhone 17 Pro Max als zusätzlichen Rechenknoten zu nutzen, um Modelle in Verbindung mit MacBook Pro über die USB-C-Schnittstelle zu betreiben.
Laut dem vom Entwickler angekündigten Plan ist das MacBook Pro für die Verarbeitung der Rechenaufgaben von Schicht 1 bis Schicht 40 in jedem 256-Token-Batch verantwortlich und überträgt die Zwischenaktivierungsdaten in Echtzeit an das iPhone. Anschließend nutzt das iPhone 17 Pro Max die GPU im A19 Pro-Chip, um weiterhin Layer-41- bis Layer-64-Vorgänge auszuführen, während der Mac gleichzeitig mit der Verarbeitung des nächsten Datenstapels beginnt. Durch diese Pipeline-Arbeitsteilung können zwei Geräte gleichzeitig am Modellinferenzprozess teilnehmen.
Experimentelle Ergebnisse zeigen, dass die Vorfüllgeschwindigkeit nach der Einführung des iPhone deutlich verbessert wurde, verglichen mit der Ausführung des Modells nur auf dem MacBook Pro. Im 8K-Kontextfenster erhöht sich die Verarbeitungsgeschwindigkeit von 132 Token pro Sekunde auf 177 Token, was einer Steigerung von 35 % entspricht; Im 16K-Kontextfenster steigt die Leistung von 109 Token pro Sekunde auf 157 Token, was einer Steigerung von 44 % entspricht; Im 32K-Kontextfensterszenario erhöht sich die Verarbeitungsgeschwindigkeit von 101 Token pro Sekunde auf 130 Token, was einer Steigerung von etwa 29 % entspricht.
Zusätzlich zum kollaborativen GPU-Computing ist auch die neuronale Netzwerk-Engine im A19 Pro-Chip an einigen Aufgaben beteiligt. Die Entwickler gaben an, dass jeder 16K historische Kontext zur Verarbeitung in ein dediziertes neuronales Netzwerkmodell umgewandelt wird. Bei der Kontextskala von 140.000 Token verkürzt sich die Schreibzeit eines einzelnen Tokens von 279 Millisekunden, wenn man sich nur auf die GPU verlässt, auf 176 Millisekunden, was die Betriebseffizienz in Szenarien mit langen Kontexten weiter verbessert.
Diese Lösung ist jedoch nicht ohne Einschränkungen. Die Entwickler wiesen darauf hin, dass das iPhone hauptsächlich dazu beiträgt, die Leistung der Vorabfüllphase zu verbessern, während bei Textgenerierungsaufgaben unter 64 KB der Großteil der eigentlichen Argumentationsarbeit immer noch hauptsächlich vom Mac erledigt wird. Darüber hinaus erfordert diese Lösung speziell entwickelte Softwareunterstützung und ist derzeit nicht für den direkten Einsatz durch normale Benutzer geeignet.
Dennoch zeigt dieses Experiment das Potenzial von Apple-Geräten für Endverbraucher für lokales KI-Computing. Da sich die Leistung mobiler Chips weiter verbessert, könnte in Zukunft ein flexibleres kollaboratives Computersystem zwischen Smartphones, Tablets und Personalcomputern entstehen, wodurch die Abhängigkeit von einer einzelnen Gerätehardwarekonfiguration zum Ausführen großer Modelle künstlicher Intelligenz verringert wird.
Kommentare