Zusammenfassung:
Google hat am 28. Oktober Ortszeit offiziell Gemini 4 Carbon veröffentlicht, eine neue Generation hochmoderner Modelle für künstliche Intelligenz, die sich auf die Verbesserung der Softwareprogrammierung, der Fähigkeit von Agenten zur Ausführung komplexer Aufgaben und der Fähigkeiten zur Netzwerksicherheitsverteidigung konzentrieren. Google sagte, dass das neue Modell erhebliche Fortschritte bei der Entdeckung von Software-Schwachstellen, der Überprüfung der Ausnutzbarkeit von Schwachstellen und der Behebung von Sicherheitslücken gemacht habe und in mehreren Benchmark-Tests den Flaggschiffmodellen von OpenAI und Anthropic voraus sei. Angesichts der potenziellen Risiken, die seine leistungsstarken Netzwerksicherheitsfunktionen mit sich bringen können, steht Google jedoch derzeit nur einigen ausgewählten Netzwerksicherheitsverteidigungsbehörden offen und wird nicht sofort allen Entwicklern und normalen Benutzern zur Verfügung stehen.
Gemini 4 Carbon ist ein weiteres hochmodernes Modell, nachdem Google diesen Monat Gemini 4 Argon auf den Markt gebracht hat. Google sagte, dass das neue Modell die Codegenerierung, den Agenten-Workflow und die langfristigen Fähigkeiten zur Verarbeitung komplexer Aufgaben auf der Basis von Argon weiter stärkt und insbesondere für den Bereich der Netzwerksicherheit optimiert ist. Das Unternehmen hofft, durch die Verbesserung der Fähigkeit der künstlichen Intelligenz, Softwareschwachstellen zu erkennen und zu beheben, Unternehmen dabei zu helfen, ihre Systeme effektiver zu schützen und gleichzeitig das Risiko zu verringern, dass neuer Code Sicherheitslücken verursacht.
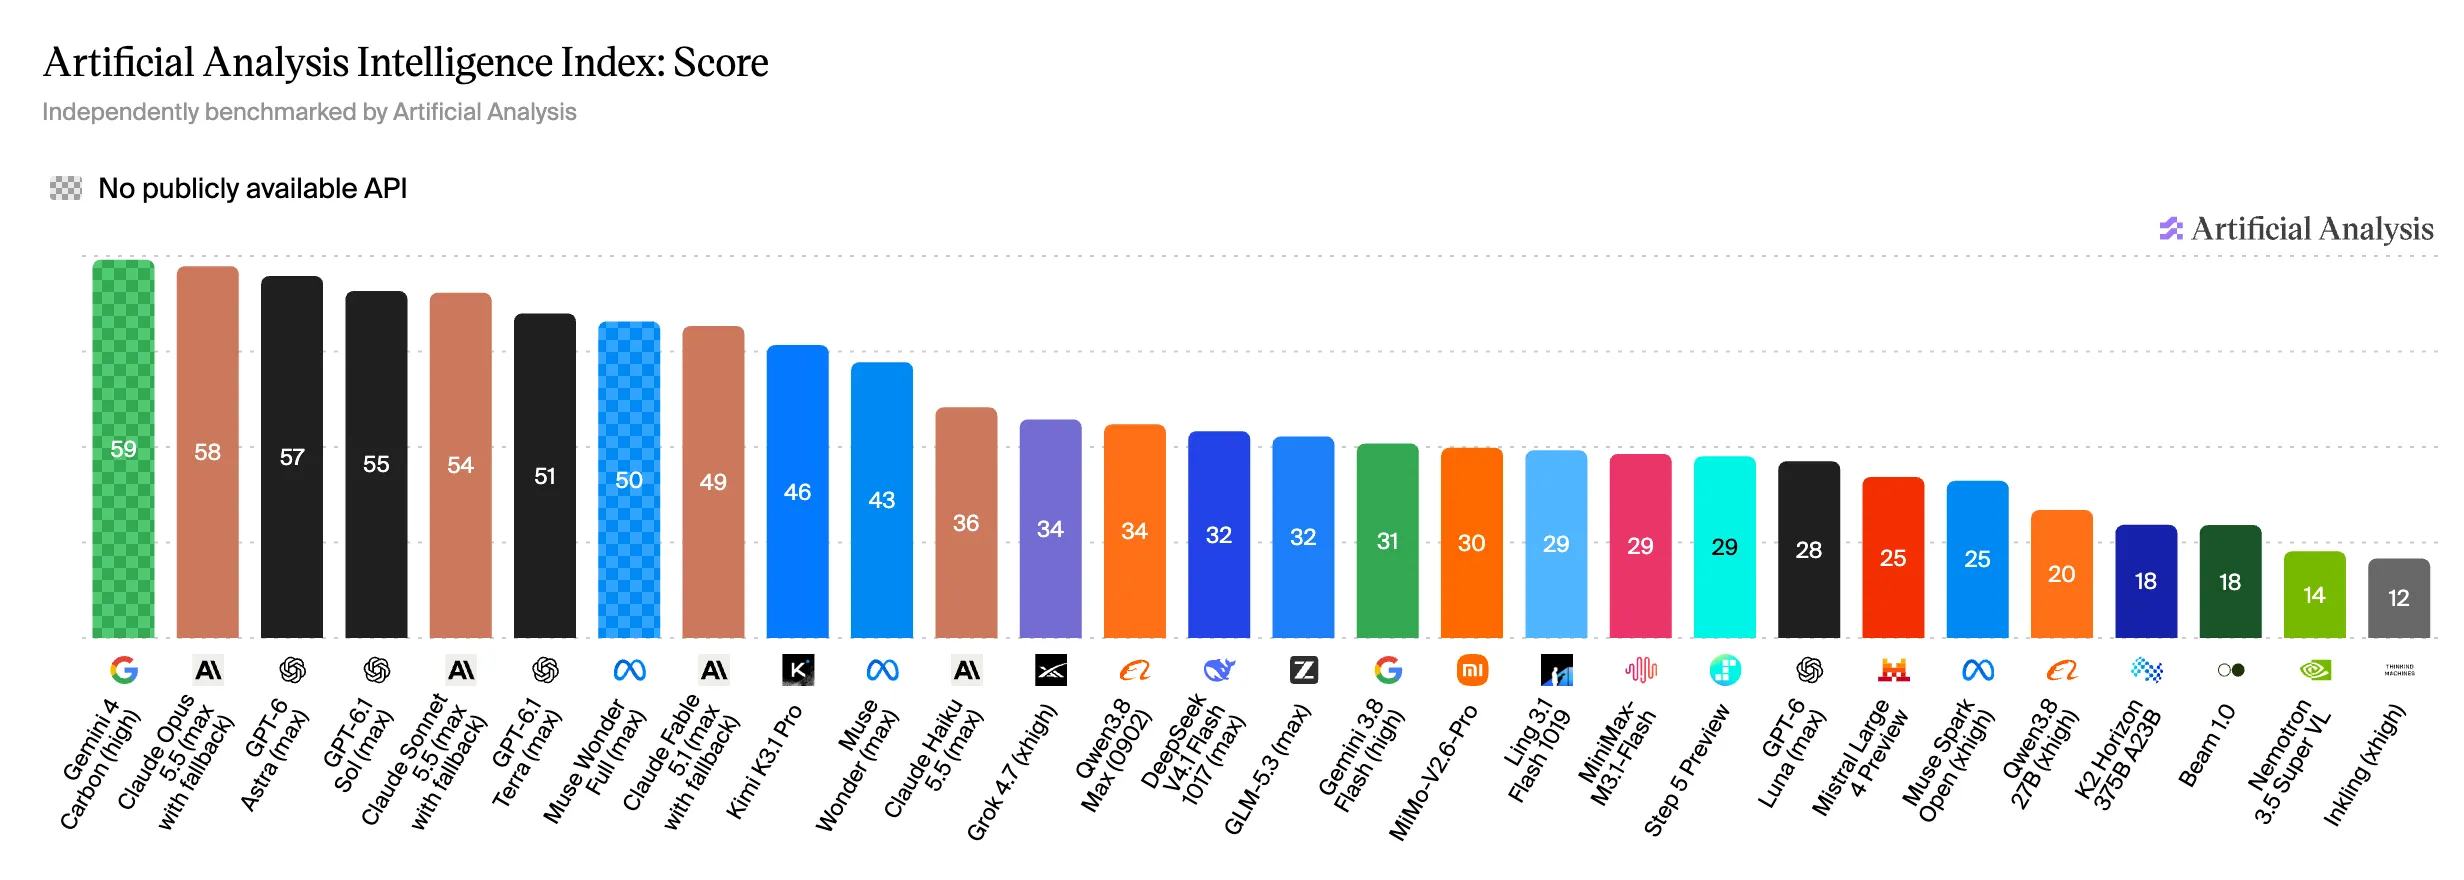
In Bezug auf die Gesamtleistung zitierte Google die von Artificial Analysis veröffentlichten Bewertungsergebnisse des Artificial Analysis Intelligence Index 5.0 und sagte, dass Gemini 4 Carbon mit 59 Punkten den ersten Platz belegte, vor Claude Opus 5.5 von Anthropic und GPT-6 Astra von OpenAI. Diese Liste untersucht umfassend die Modellfähigkeiten in mehreren Dimensionen, die Aufgabentypen und Bewertungsmethoden verschiedener Benchmarks sind jedoch unterschiedlich, sodass die umfassende Rangfolge nicht bedeutet, dass das Modell in allen praktischen Anwendungen Vorteile hat.
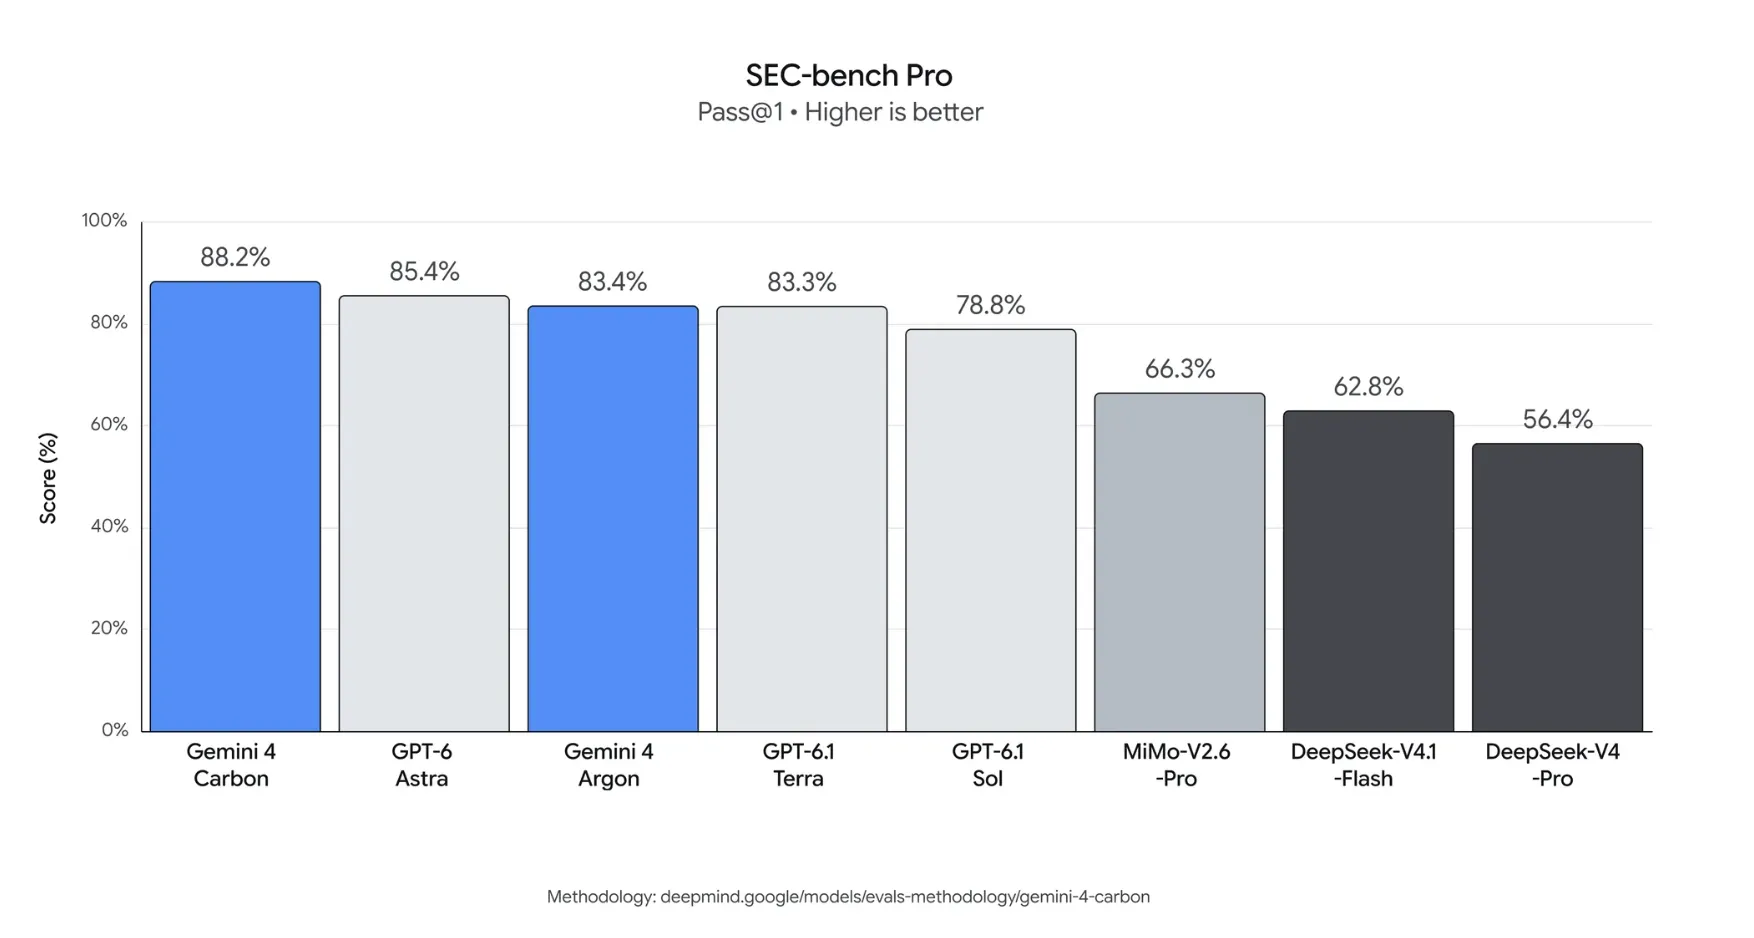
Cybersicherheit steht im Mittelpunkt dieser Einführung. Von Google veröffentlichte Daten zeigen, dass Gemini 4 Carbon im SEC-Bench Pro-Benchmark-Test, der hauptsächlich die Fähigkeit des Modells bewertet, echte Software-Schwachstellen zu entdecken, eine Punktzahl von 88,2 % erreichte; Im ExploitGym-Test, der zur Messung der Fähigkeit des Modells verwendet wird, die Ausnutzbarkeit von Schwachstellen zu überprüfen und entsprechende Ausnutzungspläne zu erstellen, erreichte es eine Punktzahl von 54,8 %. Im CWE-Benchtest, der sich auf die Bewertung konzentriert, ob das Modell wirksame Reparaturlösungen für identifizierte Sicherheitslücken vorschlagen kann, erreichte es eine Punktzahl von 71 %.
Diese Funktionen decken mehrere Schlüsselaspekte der Softwaresicherheitsarbeit ab. Herkömmliche Sicherheitstools basieren in der Regel auf vordefinierten Regeln, bekannten Schwachstellenmerkmalen und spezifischen Testprozessen, während von fortschrittlichen Modellen der künstlichen Intelligenz erwartet wird, dass sie komplexe Codes weiter analysieren, in großen Softwaresystemen verborgene Fehler entdecken und Entwicklern dabei helfen, die Ursachen von Schwachstellen zu verstehen und letztendlich gezielte Patches zu generieren.
Es gibt jedoch einen wichtigen Unterschied zwischen der Entdeckung von Sicherheitslücken und der Ausnutzung von Sicherheitslücken. Die Fähigkeit, Fehler in einem Programm zu identifizieren, bedeutet nicht, dass das Modell diese Fehler in einer realen Umgebung erfolgreich ausnutzen kann. Ebenso bedeutet die Generierung eines scheinbar vernünftigen Fixcodes nicht, dass die Schwachstelle dadurch vollständig beseitigt wurde. Die von Google veröffentlichten Testergebnisse spiegeln die Leistung unter bestimmten Bewertungsbedingungen wider. Der tatsächliche Sicherheitseffekt hängt immer noch von der Codeumgebung, den Testmethoden und der anschließenden manuellen Überprüfung ab.
Google sagte außerdem, dass Gemini 4 Carbon in internen Tests mehr als doppelt so erfolgreich bei der Generierung von sicherem Code war wie Gemini 4 Argon. Das Chrome-Team berichtete außerdem, dass Carbon in seinen internen Bewertungen qualitativ hochwertige Sicherheitspatches produzierte, die deutlich besser waren als die Spitzenmodelle einiger anderer Labore. Allerdings stammen diese Ergebnisse größtenteils aus Googles eigener Testumgebung. Spezifische Bewertungsbedingungen und Testaufgaben können sich auf die endgültige Leistung auswirken, und es sind noch weitere unabhängige Tests erforderlich, um sie zu überprüfen.
Zusätzlich zur Cybersicherheit ist Gemini 4 Carbon für technische Aufgaben optimiert, die eine kontinuierliche Ausführung über lange Zeiträume erfordern. Laut Google haben interne Teams beobachtet, wie Modelle tagelang liefen und nach mehreren Fehlschlägen und Versuchen weiterhin komplexe mehrstufige technische Probleme angingen.
Diese Aufgaben können das Auffinden schwieriger Fehler in großen Codebasen, die Behebung von Systemproblemen auf niedriger Ebene und die Implementierung von Codeänderungen über mehrere Module hinweg umfassen. Im Gegensatz zu einem Chatbot, der nur eine einzige Frage beantworten muss, muss ein Agent einen Plan erstellen, Tools aufrufen, die Ergebnisse überprüfen und den Plan basierend auf dem Feedback während der Ausführung anpassen. Je komplexer die Aufgabe, desto mehr muss das Modell die kontextbezogene Kohärenz aufrechterhalten und vermeiden, vorzeitig aufzugeben, wenn es nicht weiterkommt.
Google sagte, dass Carbon bei der Bewältigung solch langfristiger Aufgaben besser darin sei, Fehlerpfade zu identifizieren und unzuverlässige Abkürzungen zur Erledigung der Aufgabe zu vermeiden. Im eigentlichen Entwicklungsprozess soll dies den Ingenieuren dabei helfen, die Zeit für wiederholte Fehlerbehebungen zu verkürzen, sodass künstliche Intelligenz kontinuierlichere Softwarewartungs- und Debugging-Arbeiten übernehmen kann.
Gleichzeitig betonte Google, dass das neue Modell auch Verbesserungen bei der Zuverlässigkeit aufweist. Das Unternehmen gibt an, dass Carbon unbegründete Behauptungen im Vergleich zu Argon um etwa die Hälfte reduziert. Bei einem Problem mit unzureichenden Beweisen oder Unklarheiten ist es wahrscheinlicher, dass das Modell weiter nach Informationen sucht, Widersprüche zwischen verschiedenen Informationen aufzeigt oder klar angibt, welche Schritte noch nicht abgeschlossen werden können, anstatt direkt eine Antwort zu geben, bei der es an Beweisen mangelt.
Im Hinblick auf die zeitnahe Abwehr von Injektionsangriffen verdienen auch die von Google veröffentlichten internen Bewertungsergebnisse Beachtung. Hint-Injection-Angriffe veranlassen Systeme der künstlichen Intelligenz in der Regel dazu, von ihren ursprünglichen Missionszielen abzuweichen, indem sie bösartige Anweisungen in Webseiten, Dateien oder anderen externen Inhalten verstecken. Google sagte, dass im indirekten Prompt-Injection-Test von Gray Swan die Angriffserfolgsrate von Carbon weiter von 0,7 % Argon auf 0 % gesunken sei, was bedeutet, dass es unter den vom Test abgedeckten Angriffsversuchen keine erfolgreichen Fälle gab.
Die Tatsache, dass in einem einzigen Benchmark keine Angriffe erfolgreich beobachtet wurden, beweist jedoch nicht, dass das Modell gegen alle Hint-Injection-Angriffe resistent ist. Angriffsmethoden in realen Umgebungen können sich weiterhin ändern, und das Modell muss auch mit Maßnahmen wie Berechtigungsverwaltung, Tool-Aufrufbeschränkungen, Überprüfung von Eingabeinhalten und manueller Überwachung kombiniert werden, um ein zuverlässigeres Sicherheitssystem aufzubauen.
Da Carbons Fähigkeiten im Bereich der Netzwerksicherheit weiter ausgebaut werden, hat Google beschlossen, eine schrittweise Öffnungsstrategie zu verfolgen. Das neue Modell steht zunächst einer ausgewählten Gruppe von Cybersicherheits-Verteidigungsorganisationen über das Fairwind-Programm des Unternehmens zur Verfügung. Google sagte, dass das Unternehmen am freiwilligen Testprozess vor der Veröffentlichung modernster Modelle teilnimmt, der von der US-Regierung gefördert wird, und plant, den Sicherheitsschutzmechanismus basierend auf dem Feedback der ersten Benutzer weiter anzupassen und ihn dann schrittweise für vertrauenswürdigere Partner zu öffnen.
Google hat noch nicht das genaue Datum bekannt gegeben, wann Carbon allen Entwicklern, Unternehmen und allgemeinen Nutzern zugänglich sein wird. Das Unternehmen hofft, das Modell nach Abschluss der erforderlichen Tests und Anpassung der Schutzmaßnahmen so bald wie möglich in weiteren Produkten und Dienstleistungen einführen zu können.
Diese begrenzte Offenheitsstrategie spiegelt eine echte Herausforderung für die Branche der künstlichen Intelligenz wider: Modelle, die Sicherheitsteams dabei helfen können, Schwachstellen zu entdecken, können auch von böswilligen Personen verwendet werden, um Angriffspunkte zu finden oder Ausnutzungstools zu entwickeln. Je stärker die Modellfähigkeit ist, desto mehr müssen Unternehmen die Dual-Use-Risiken bewerten, die es in verschiedenen Nutzungsszenarien mit sich bringen kann.
In Bezug auf den Preis ist der anfängliche Preis für Gemini 4 Carbon derselbe wie für Gemini 4 Argon, wobei 2 US-Dollar pro Million Input-Tokens und 10 US-Dollar pro Million Output-Tokens berechnet werden. Google bietet auch einen erheblichen Rabatt für das Caching von Eingabe-Tokens an, wobei der Rabatt bis zu 95 % des Preises für Eingabe-Tokens beträgt. Dieser Preis gehört jedoch zur Preisgestaltung für den Aktionszeitraum. Die von Google angekündigten Folgepreise betragen 4 US-Dollar pro Million Input-Tokens und 20 US-Dollar pro Million Output-Tokens. Der offizielle Anpassungszeitpunkt steht noch nicht fest.
Aus Sicht der Produktpositionierung ist Carbon kein neues Modell, das lediglich auf Chat-Erfahrung abzielt, sondern ein professionelles Tool, das sich mehr auf komplexe Softwareentwicklung, kontinuierliche Ausführung von Aufgaben und Netzwerksicherheitsverteidigung konzentriert. Ihr Wert liegt nicht nur darin, die richtige Antwort geben zu können, sondern auch darin, die Arbeit über einen längeren Zeitraum hinweg abschließen zu können und angemessen reagieren zu können, wenn Fehler, unklare Anforderungen oder potenzielle Sicherheitsrisiken auftreten.
Diese Veröffentlichung zeigt auch, dass Google das Iterationstempo modernster Modelle beschleunigt. Kurz nach der Einführung von Gemini 4 Argon verbesserte Carbon mehrere wichtige Leistungsindikatoren weiter. Für Unternehmensanwender dürfte diese schnelle Iteration die Zeit verkürzen, in der die Technologie der künstlichen Intelligenz in die tatsächlichen Softwareentwicklungs- und Sicherheitsbetriebsprozesse eindringt, aber sie erhöht auch die Bedeutung unabhängiger Bewertung, kontinuierlicher Überwachung und Sicherheitsüberprüfung.
Derzeit hat Gemini 4 Carbon in einer Reihe von von Google veröffentlichten Benchmark-Tests führende Ergebnisse erzielt, seine tatsächliche Leistung muss jedoch noch von unabhängigeren Institutionen und tatsächlichen Nutzern überprüft werden. Da Cyberangriffe immer ausgefeilter werden, könnte künstliche Intelligenz zu einem wichtigen Verteidigungsinstrument für Sicherheitsteams werden und auch die Automatisierung der Erkennung und Ausnutzung von Schwachstellen erhöhen. Google entschied sich dafür, das Modell zunächst für überprüfte Verteidigungsbehörden zu öffnen, in der Hoffnung, seine Risiken weiter einzuschätzen und gleichzeitig technische Fähigkeiten freizugeben und nach und nach entsprechende Nutzungsgrenzen festzulegen.
Kommentare