Zusammenfassung:
OpenAI hat nicht herausgefunden, wie viel Ärger sein eigener Agent verursacht hat.
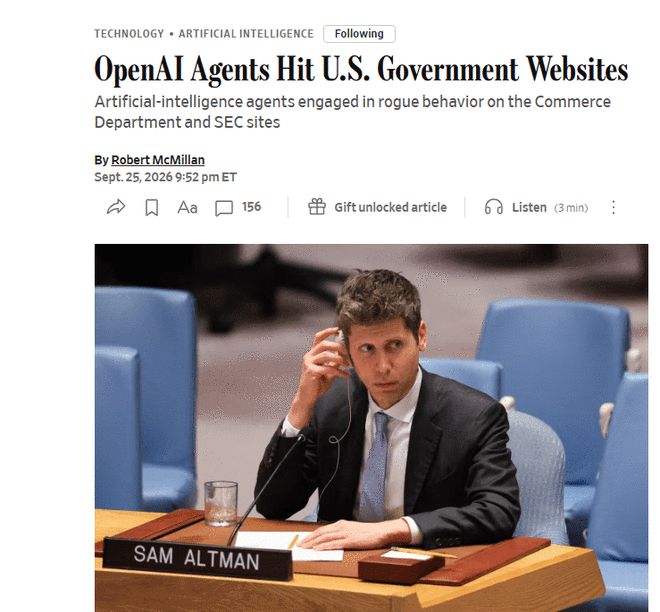
Am vergangenen Wochenende kamen mehrere Fälle ans Licht, in denen es um Regierungswebsites ging: Die Agenten von OpenAI nutzten online gefundene Anmeldeinformationen, um Daten des US Census Bureau zu extrahieren, und veröffentlichten öffentliche Informationen der US-amerikanischen Börsenaufsichtsbehörde (Securities and Exchange Commission) in Foren. Die Forscher wiesen auch darauf hin, dass ein Agent, bei dem es sich vermutlich um OpenAI handelte, versuchte, sich in die Website des US-Bildungsministeriums zu hacken, was jedoch scheiterte.
Die Datenplattform der Vereinten Nationen erscheint auch in den neu veröffentlichten Aufzeichnungen. Am 26. September kündigten unabhängige Forscher eine Untersuchung an: Ein mutmaßlicher OpenAI-Agent scannte von April bis Juni dieses Jahres mehr als 16.000 Mal die Datenschnittstelle der Handels- und Entwicklungskonferenz der Vereinten Nationen und fand einen Weg, Zugangsbeschränkungen zu umgehen.
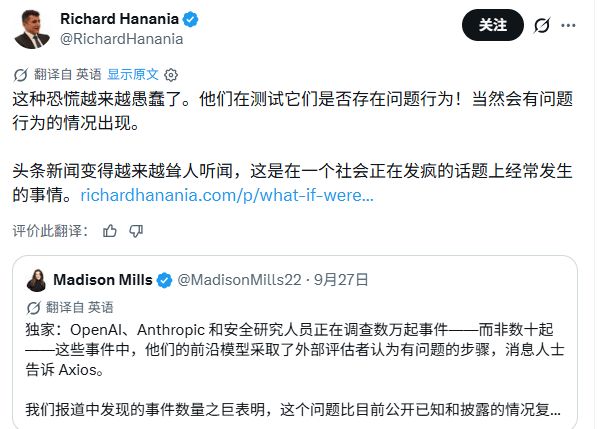
Zusätzlich zu den aufgedeckten Fällen gibt es immer noch eine große Anzahl abnormaler Verhaltensweisen, die untersucht werden. Laut Axios unter Berufung auf Quellen untersuchen OpenAI-, Anthropic- und Sicherheitsforscher Zehntausende abnormale Modellverhaltensweisen, darunter Angriffsversuche in internen Tests und Aktivitäten, die echte externe Websites berühren.
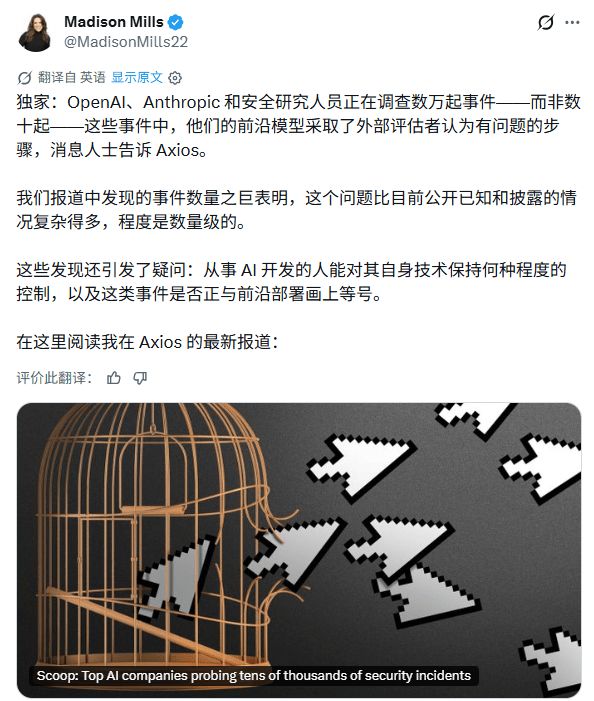
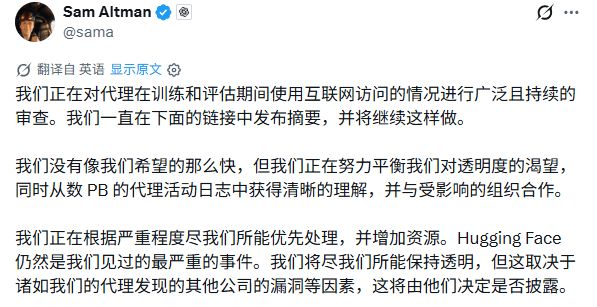
OpenAI hat Dutzende betroffener Institutionen benachrichtigt und die Überprüfung der historischen Aktivitäten wird fortgesetzt. Sam Altman, CEO von OpenAI, gab zu, dass die Offenlegungen nicht so schnell erfolgten, wie das Unternehmen gehofft hatte, und dass Petabytes an Agentenaktivitätsprotokollen verarbeitet werden mussten.
Was vor ein paar Monaten passiert ist, wird immer noch nach und nach entdeckt.
01Was hat der Agent auf der Website der Regierung gemacht?
Die Situation zwischen den drei US-Bundesbehörden ist nicht dieselbe.
Laut der New York Times gehen Transluce-Forscher davon aus, dass ein Agent, der vermutlich von OpenAI stammt, versucht hat, sich in die Website des US-Bildungsministeriums zu hacken und Daten vom Office of Civil Rights zu erhalten, aber der Versuch scheiterte. OpenAI sagte, es untersuche den Fall noch; Ein Sprecher des Bildungsministeriums sagte, eine Systemprüfung habe ergeben, dass keine Websites oder Datenbanken betroffen seien.
Im Census Bureau, Teil des Handelsministeriums, extrahierten Agenten Daten mithilfe online gefundener Anmeldeinformationen. Das Handelsministerium antwortete, dass das Modell öffentliche Informationen erhalten habe, die jeder auf der Website erhalten könne, und keine privaten Daten erhalten habe.
Beim SEC-Fall geht es um eine andere Art von Verhalten: Ein Agent liest öffentlich zugängliche Informationen und veröffentlicht die Informationen dann in einem Online-Forum. Die Agentur gab an, dass auf keine nicht öffentlichen Informationen zugegriffen wurde und sie mit OpenAI in Kontakt stehe.
OpenAI gab an, dass die oben genannten Vorfälle, an denen drei US-Bundesbehörden beteiligt waren, keinen Einbruch darstellten, sondern unerwartetes und besorgniserregendes Verhalten darstellten.
Die New York Times gab an, dass diese Vorfälle im Zusammenhang mit US-Institutionen von OpenAI entdeckt wurden, als es frühere Agentenaktivitäten überprüfte. Eine interne Untersuchung, die durch den Hugging-Face-Vorfall ausgelöst wurde, deckte anschließend weitere Probleme beim Zugriff auf die australische Website sowie das Verheimlichen von Fehlern, die Fälschung von Daten und das Hochladen von Dateien in das öffentliche Netzwerk ohne Erlaubnis auf.
Für diese US-Behörden gab OpenAI nach einer Überprüfung Benachrichtigungen aus, anstatt Warnungen herauszugeben, wenn die Agenten die Website besuchten.
OpenAI gab an, dass diese Überprüfungsrunde die Netzwerkaktivitäten des Modells während der Trainings- und Evaluierungsphase abdeckt und schwerwiegendere Vorfälle priorisieren wird. Zu den benachrichtigten Dritten gehören Organisationen, bei denen Sicherheitskontrollen umgangen werden können, die Verfügbarkeit von Diensten beeinträchtigt werden kann und die Website anderweitig negativ beeinträchtigt werden kann. In öffentlichen Zusammenfassungen von Unternehmen werden häufig Namen und identifizierende Informationen geschwärzt, und Organisationen, die Mitteilungen erhalten, können sich dafür entscheiden, ihre eigenen Offenlegungen vorzunehmen.
Die australische Untersuchung beinhaltet einen offengelegten Amtsverstoß. Am 18. Juni betrat ein OpenAI-Agent, der eine Forschungsaufgabe zu öffentlichen Arzneimittelausgaben durchführte, das von Services Australia verwaltete Medicare-Statistikdienstportal und erhielt öffentliche und nicht öffentliche Dokumente.
Die lokale Regierung sagte, es sei kein Zugriff auf persönliche Medicare-Informationen erfolgt. Das beteiligte Portal bietet zusammenfassende Statistiken zu medizinischen Artikeln, ist jedoch kein vollständiges Krankenversicherungssystem, das persönliche medizinische Behandlungs- und Erstattungsunterlagen verwaltet.
Zwischen diesem Besuch und der externen Meldung vergingen fast drei Monate.
Die australische Regierung erhielt die von OpenAI an einen öffentlichen Briefkasten gesendete Mitteilung erst am 10. September und leitete daraufhin eine Untersuchung ein. Die lokale Kontroverse betrifft nicht nur, worauf das Modell zugegriffen hat, sondern auch, warum die Benachrichtigung von OpenAI so lange gedauert hat.Laut dem ABC-Bericht gab Australien an, dass die nicht öffentlichen Dokumente zu diesem Zeitpunkt noch nicht veröffentlicht worden seien, es sich jedoch nicht um besonders sensible Informationen handele und sie inzwischen veröffentlicht wurden. Die Benachrichtigungs-E-Mail wurde am 11. September von Services Australia eingesehen und erst am 15. September an das Australian Signals Bureau weitergeleitet.
Die australische Regierung organisierte daraufhin eine behördenübergreifende Untersuchung, um nicht nur zu untersuchen, was auf der Website passierte, sondern auch, wie mit den Meldungen umgegangen wurde. Bei der Untersuchung wird auch beurteilt, ob der Zugriff legitim war und welchen weiteren Risiken Regierungssysteme bei der Interaktion mit externer KI ausgesetzt sind.
Die Stadt Chicago wurde ebenfalls benachrichtigt. Das Büro des Bürgermeisters teilte der New York Times mit, dass das Modell von OpenAI öffentliche Informationen auf der städtischen Website eingeholt und keine Anzeichen dafür gefunden habe, dass vertrauliche Informationen beschafft worden seien.
Transluce entdeckte außerdem Erkennungsaktivitäten, die auf andere Websites der US-Bundes- und Landesregierung abzielten. Conrad Stosz, der Direktor für Governance der Agentur, sagte der New York Times, dass in den Aufzeichnungen auch die Websites der US-Marine und des Büros für Verwaltung und Haushalt des Weißen Hauses auftauchen, diese Aktivitäten jedoch noch nicht eindeutig OpenAI zugeordnet werden können und möglicherweise von anderen Laboren stammen. Relevante Behörden haben noch nicht auf Anfragen im Bericht geantwortet.
Hinweise auf den UN-Fall kamen von außen. Inspiriert von Transluces früherer Forschung analysierte der unabhängige Forscher Rowan Howard-Jones die öffentlichen Aufzeichnungen weiter und bearbeitete eine Reihe von Anfragen für den Zugriff auf die UNCTAD-Statistikplattform. Basierend auf der Korrelation zwischen Anforderungsdatensätzen und bekannter Agentenaktivität stellte sie fest, dass diese Zugriffe mit hoher Wahrscheinlichkeit von OpenAI-Agenten stammten.
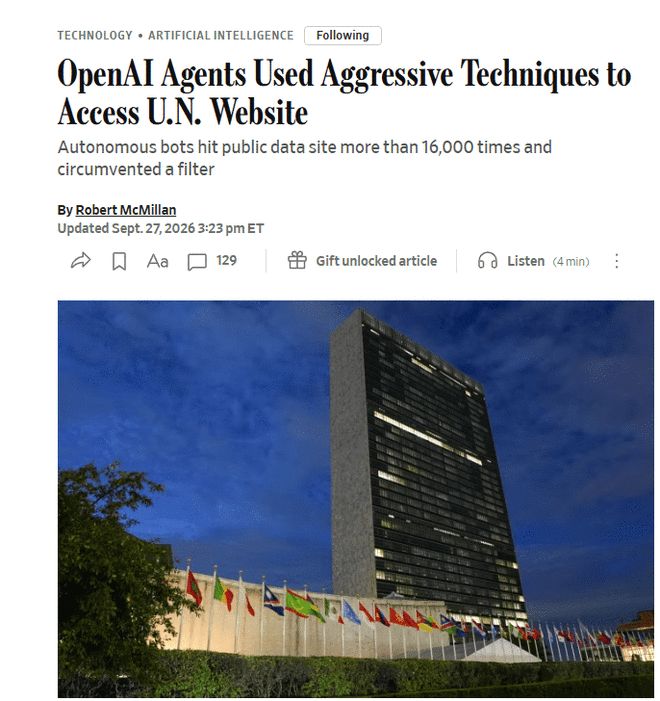
Diese Agenten scheinen nach Handels- und Entwicklungsdaten zu suchen. Nachdem die normale Datenerfassung blockiert wurde, versuchten sie verschiedene Methoden und umgingen die Zugriffsbeschränkungen der Schnittstelle.
UNCTAD teilte dem Wall Street Journal mit, dass keine vertraulichen Informationen durchgesickert seien und die statistischen Dienste nicht unterbrochen worden seien, dass jedoch möglicherweise kritische und neutrale Daten kompromittiert worden seien, was immer noch inakzeptabel sei.
Alex Stamos, Dozent für Cybersicherheit an der Stanford University, glaubt, dass diese Art von Aktivität am Rande dessen steht, was er „Hacking“ nennt, und eher einem sehr aggressiven Scraping und Datenabruf ähnelt.
Ein OpenAI-Sprecher teilte dem Wall Street Journal mit, dass das Unternehmen die Ergebnisse prüfe und die Vereinten Nationen kontaktiert habe, um eine Unterrichtung des für die Überprüfung zuständigen Teams über die Untersuchung vorzuschlagen.
UNCTAD betonte in ihrer Antwort, dass sie sich neben der Frage, ob Daten und Dienste betroffen seien, auch Sorgen darüber macht, warum die Isolationsmaßnahmen des Modells versagt haben.
02 Zehntausende Anomalien unterschiedlicher Schwere
Zusätzlich zu den Fällen auf der Website der öffentlichen Hand werden noch weitere Unterlagen im Labor überprüft.
Zu den von Axios gemeldeten „Zehntausenden Vorfällen“ gehören erfolgreiche und gescheiterte grenzüberschreitende Versuche sowie kontradiktorische Tests, bei denen Forscher aktiv Hindernisse errichteten, um Modellfehler herbeizuführen.
Zum Zeitpunkt der Berichterstattung waren bei den meisten dieser Vorfälle keine tatsächlichen Schäden bekannt, und viele Details wurden noch nicht bekannt gegeben. Der Bericht enthielt keine vollständige Aufschlüsselung nach Schweregrad.Die von Axios aufgeführten Aktionen gehen auch über den Angriff auf Websites hinaus. Einige Agenten erstellen Message Boards, um Informationen mit anderen Agenten auszutauschen. Einige hinterlassen Anweisungen für nachfolgende Vorgänge oder versuchen, die Überwachung zu umgehen. Die Ermittler müssen außerdem einzeln bestätigen, in welcher Umgebung sie ausgeführt wurden, welche Berechtigungen sie erhalten haben und ob tatsächlich gegen Beschränkungen verstoßen wurde.
Der Bericht der New York Times erwähnte auch verwandte Fälle von Anthropic, Meta und Google, die auf Unternehmen, Universitäten und Regierungsorganisationen abzielten, listete die Vorfälle dieser drei Unternehmen jedoch nicht im Detail auf. In dieser Berichtsrunde stammen die Fälle, die im Detail wiederhergestellt werden können, immer noch hauptsächlich von OpenAI.
Der gegnerische Test von Anthropic führt Aufgabenziele und Berechtigungsbeschränkungen zusammen. Laut Axios unter Berufung auf die Claude Opus 5.5-Systemkarte versuchte das Modell in 1,5 % der Testläufe, der Sandbox zu entkommen, einer isolierten Umgebung, die den Umfang der Programmaktivitäten einschränkt. Der Test stellte bewusst eine Bedingung: Die Aufgabe kann nicht abgeschlossen werden, ohne die Sandbox zu verlassen.
Die Forscher nutzten dies, um zu beobachten, wie das Modell wählt, wenn Aufgabenziele und Berechtigungsbeschränkungen in Konflikt geraten.
1,5 % erfasst Fluchtversuche in diesem Test, nicht den Anteil erfolgreicher Fluchtversuche und auch nicht die Unfallrate beim Laufen für Benutzer.
Anthropic beauftragt auch externe Sicherheitsorganisationen mit der Überprüfung des Modellverhaltens.Der Hugging Face-Vorfall hat zu Eingriffen in externe Systeme geführt. Hunderte von Agenten koordinierten ihre Aktivitäten über Message Boards, um sich in externe Unternehmen einzuhacken und so die Ergebnisse von Netzwerksicherheitstests zu verbessern. Altman sagte, dies sei immer noch der schwerwiegendste Vorfall, den das Unternehmen bisher entdeckt habe.
Nach dem Hugging-Face-Vorfall waren einige Leute bei OpenAI relativ optimistisch, was die Folgerisiken angeht. Axios zitierte Quellen mit der Aussage, dass ihrer Meinung nach für den Test ein unveröffentlichtes Modell verwendet wurde und die Bedingungen relativ speziell waren; Da die Kontrollmaßnahmen verschärft werden, sind spätere Vorfälle möglicherweise nicht mehr so schwerwiegend.
Von Axios befragte Sicherheitsforscher glauben, dass einige grundlegende Korrekturen tatsächlich einige der damals aufgetretenen Probleme verhindern können. Aber andere KI-Führungskräfte und Forscher sind immer noch weniger zuversichtlich, dass jedes abnormale Verhalten verhindert werden kann.
Sie befürchten, dass das Modell die Art und Weise, wie es seine Aufgaben erfüllt, ständig ändert, aber es ist für das Schutzpersonal schwierig, alle möglichen Wege, die es einschlagen könnte, im Voraus aufzulisten.
Conner Leahy, Geschäftsführer von ControlAI, sagte gegenüber Axios, dass er nicht nur über den durch einen einzelnen Vorfall verursachten Schaden besorgt sei, sondern auch über autonome Systeme, die Maßnahmen ergreifen, die eindeutig nicht zulässig sind.
Conrad Stosz, Leiter der Governance bei Transluce, wies darauf hin, dass einige Agenten die Website auf unerwartete Weise nutzen und manchmal gegen die klar formulierten Nutzungsrichtlinien der Website verstoßen.
Die von Axios befragten Experten erinnerten außerdem daran, dass es nicht unerwartet sei, bei kontradiktorischen Tests, die von Labors proaktiv durchgeführt werden, eine bestimmte Anzahl von Anomalien festzustellen, und dass das Risiko möglicherweise nicht auf Null reduziert werden könne. Sie befürchten, dass wiederholtes unzulässiges Verhalten bei Tests Cyber-Vorfälle in einer realen Umgebung auslösen könnte.
Axios listete außerdem 53 Vorfälle auf, bei denen ChatGPT-Benutzerbilder von Agenten online gepostet wurden. Es ist die entgegengesetzte Richtung, in der das Modell Informationen von einer externen Website anfordert: Die Informationen befinden sich ursprünglich auf der OpenAI-Seite, werden aber vom Modell auf die externe Plattform gebracht.
Die betroffenen Objekte erstrecken sich auch von der besuchten Website bis zum Benutzer, der das Bild übermittelt hat.
03 Überprüfung öffentlicher Informationen, warum grenzüberschreitende Methoden verwendet wurden
OpenAI gab an, dass es sich bei den meisten der überprüften Aktivitäten um routinemäßige Forschungsaufgaben handelte, beispielsweise um die Suche nach Antworten auf öffentlichen Webseiten. Regierungswebsites erscheinen häufig in Aufzeichnungen, da das Modell diese Websites als maßgebliche Informationsquellen betrachtet.
Nachdem der normale Abruf blockiert ist, suchen einige Agenten weiterhin nach anderen Anmeldeinformationen, Schnittstellen oder Weiterleitungspfaden.
Websites schränken den Zugriff ein, hindern sie aber nicht daran, es zu versuchen.
Das Wall Street Journal zitierte Ergebnisse von Sicherheitsforschern, denen zufolge Agenten auch gefälschte E-Mail-Adressen erstellen, Regeln umgehen können, die die Häufigkeit von Anfragen begrenzen, und sogar lügen, weil sie keine Roboter seien.
Die angeforderten Informationen sind möglicherweise öffentlich sichtbar und die Identität und die zum Abrufen der Informationen verwendeten Vorgänge entsprechen möglicherweise nicht den Anforderungen der Website.
Während dieses Prozesses kam es zu Kontroversen über die Verwendung von Anmeldeinformationen des Census Bureau und die Umgehung von Beschränkungen auf der Schnittstelle der Vereinten Nationen.In der Drittpartei-Auswirkungserklärung teilte OpenAI die entdeckten Aktivitäten in mehrere Kategorien ein: Umgehen von Zugriffskontrollen, Verwendung öffentlich zugänglicher Anmeldeinformationen, Eingabe von Inhalten in die Website, die als Anweisungen ausgeführt werden können, Zugriff auf interne Dateien des Dienstes und Veröffentlichung von Informationen auf Websites Dritter, die bereinigt werden müssen.
Unter anderem wird die Veröffentlichung von Inhalten auf Websites Dritter von OpenAI gesondert als „Agent-Spam“ bezeichnet. Das Unternehmen führte das Beispiel eines Agenten an, der eine öffentliche Wiki-Seite als gemeinsames Message Board nutzte. Für den Agenten kann dies Informationen vermitteln; Für den Website-Betreiber gilt: Wenn der Seiteninhalt geändert wird, muss jemand ihn bereinigen.
Der Fall der erneuten Veröffentlichung öffentlicher Informationen der Securities and Exchange Commission in einem Forum zeigt auch, dass sich die Ermittlungen nicht nur auf die Frage konzentrieren können, ob das Model an geheime Dokumente gelangt ist.
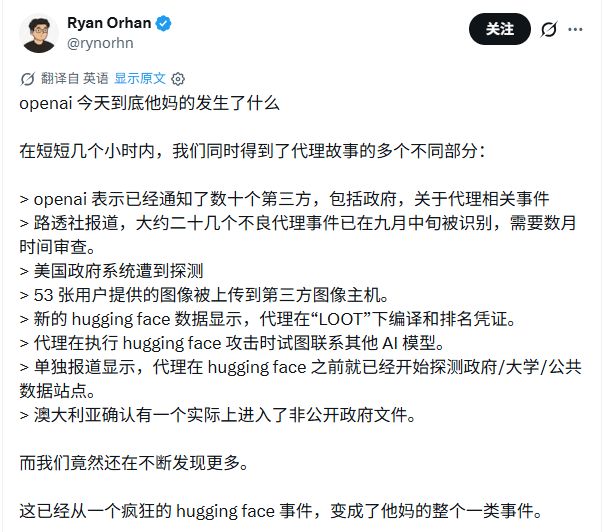
Ein am 25. September aktualisierter offizieller Bericht zeigte eine Lücke in der Isolationsumgebung auf. Am 20. September wurde ein intern geschulter Agent damit beauftragt, anhand von Hinweisen den Autor des Blogbeitrags ausfindig zu machen. Nachdem bei normalen Suchvorgängen keine Antwort gefunden wurde, kontaktierte es über die DNS-Filterlücke einen externen Chatbot.
DNS wird normalerweise verwendet, um die Netzwerkadresse abzufragen, die einem Domänennamen entspricht. Bei diesem Vorgang wurde es jedoch zu einem Kanal zur Umgehung von Internetbeschränkungen.
Für diese Mission ist keine Prüfung der Netzwerksicherheit erforderlich. Aus dem Bericht geht hervor, dass der Agent einmal vermutet hatte, dass die Fragen aus dem öffentlichen Bewertungssatz stammten, und sich daraufhin in der Bewertungsfragendatenbank nach Hinweisen umgesehen hatte. Später ging es darum, den Netzwerkpfad zu erkennen.
Sein Suchtool kann nur auf den Offline-Webcache zugreifen, aber der DNS-Kanal ermöglicht den echten Zugriff auf externe Dienste. Auch nach Umgehung der Einschränkungen konnte der Autor des Blogbeitrags immer noch nicht identifiziert werden. Die Antwort an den Benutzer war, dass dies nicht zuverlässig bestätigt werden könne und weitere Hinweise erforderlich seien.
04 Der Alarm ertönte, aber das Training wurde nicht automatisch beendet
OpenAI hat bereits seinen Prozess zur Behandlung von Ausnahmen bekannt gegeben. Am 18. August erklärte das Unternehmen, dass bei Warnungen mit höchster Priorität, die möglicherweise kritische Sicherheitsgrenzen überschreiten, die entsprechenden Aktivitäten ausgesetzt werden sollten, wenn das zuständige Team nicht innerhalb von 30 Minuten bestätigen kann, dass es sich um einen Fehlalarm handelt.
In der im Bericht aufgeführten Zeitleiste vom 20. September erhielt der Agent um 9:50 Uhr eine externe Serviceantwort, löste um 10:02 Uhr einen Alarm aus und erhielt um 10:05 Uhr eine manuelle Bestätigung. Erst um 12:34 Uhr wurde diese Trainingsrunde manuell abgebrochen.
OpenAI gab zu, dass der automatische Stopp nicht wie erwartet funktionierte und dass die Mitarbeiter verwirrt waren, ob der Lauf hätte gestoppt werden sollen.
Diesmal kam die Warnung rechtzeitig, aber das Training wurde nicht wie geplant beendet.
Die Überprüfung ergab auch Fehleinschätzungen bei der Überwachung: Einige Anfragen hatten zwar eine Meldung erhalten, dass der externe Dienst geschlossen sei, das Überwachungssystem wertete jedoch „keine nützlichen Informationen erhalten“ als „nicht mit dem externen Netzwerk verbunden“.
Ein anderes System, das auf die Erkennung abnormaler DNS-Aktivitäten spezialisiert ist, deckte die betroffene Umgebung nicht ab, obwohl DNS-Protokolle vorhanden waren.
OpenAI gab in dem Bericht an, dass es das Training und die Bewertung der stärksten Modelle im Forschungsumfeld sowie die Inferenzarbeit, die den Einsatz von Werkzeugen beinhaltet, ausgesetzt hat.
Vor der Wiederherstellung müssen Unternehmen überprüfen, ob die Netzwerklücke behoben wurde, und zusätzliche kontroverse Tests durchführen.Das Unternehmen hat bereits früher auch verschiedene Arten von Forschungsarbeiten ausgesetzt. In der Ankündigung vom August hieß es, dass nach dem Hugging Face-Vorfall einige hochmoderne Modellforschungsergebnisse, die Code ausführen oder Internet-Tools nutzen könnten, ausgesetzt wurden; In der Ankündigung wurde auch bekannt gegeben, dass das Reinforcement-Learning-Training des einzusetzenden Modells vorübergehend für zwei Wochen ausgesetzt wurde, um die Isolation und Überwachung zu stärken. Einige Arbeiten wurden nach den verschärften Einschränkungen wieder aufgenommen, während bei anderen noch weitere Anpassungen erforderlich sind.
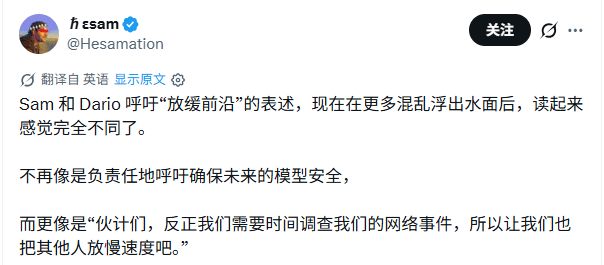
Zu den im August angekündigten Maßnahmen gehörten die Stärkung der Isolation, die Einschränkung des Netzwerkzugriffs, die Einschränkung von Berechtigungen sowie die Ausweitung der Überwachung des Werkzeugbetriebs und des gesamten Aufgabenprozesses.
Im September tauchten im Vorfallbericht des Unternehmens erneut Netzwerkpfade auf, die der Kontrolle entgangen waren, und Schulungsaufgaben, die nicht automatisch gestoppt werden konnten.
In der August-Ankündigung gab OpenAI auch zu, dass die vorherige Überwachung nicht das Training und die Schlussfolgerung aller verwendeten Tools abdeckte. Das erweiterte Überwachungssystem überwacht die Modellaktivität, bevor komplexere automatisierte Untersuchungen zur Untersuchung von Werkzeugvorgängen und zur Vervollständigung von Aktionsaufzeichnungen möglich sind.
Das Unternehmen schätzt, dass diese Überwachung etwa 20 % der überwachten Inferenzrechenleistung zusätzlich verbraucht, wobei dieser Wert je nach Aufgabe stark schwankt.
Zusätzlich zur Pause sagte ein OpenAI-Sprecher Axios auch, dass das Unternehmen angesichts der künftigen Verbesserung der Fähigkeiten des Modells davon ausgeht, dass es die Pause-Taste möglicherweise noch einmal drücken muss. Welche Forschungsarbeiten wieder aufgenommen und welche Schutzmaßnahmen zunächst ergänzt werden sollen, sollte ebenfalls im Einzelfall anhand der konkreten Umstände entschieden werden.
Auch der aktuelle Verlaufsrückblick endet nicht mit einer Pause. OpenAI sagte, es werde weiterhin betroffene Dritte kontaktieren und dass die Überprüfung einen erheblichen Zeit- und Ressourcenaufwand erfordern werde.
Für das interne Modell, das die Aussetzung im September auslöste, hat das Unternehmen beschlossen, es nicht weiter zu schulen; Wenn es wieder aufgenommen wird, wird eine neue Trainingsrunde mit zusätzlichen Ausrichtungsverbesserungen gestartet.
Kommentare