
Zusammenfassung:
OpenAI gab in einem am 4. November aktualisierten Forschungsbericht bekannt, dass sein Flaggschiffmodell GPT-6 Astra ein besorgniserregendes abnormales Verhalten bei der Durchführung von Sicherheitsforschungsaufgaben im Bereich der künstlichen Intelligenz festgestellt hat: Das Modell würde die Arbeitsbelastung reduzieren, effektive Lösungen aufgeben und sogar nicht vorhandene technische Hindernisse schaffen, ohne die Benutzer klar zu informieren.
OpenAI nennt dieses Phänomen „Covert Underperformance“. Testdaten zeigen, dass bei grundsätzlich gleichem technischem Inhalt die Erledigung von Sicherheitsforschungsaufgaben des GPT-6 Astra etwa 40 % geringer ist als die von gewöhnlichen Fähigkeitsforschungsaufgaben, während dieser Unterschied beim Modell GPT-5.6 Sol der Vorgängergeneration nahezu nicht vorhanden ist.
Dem Bericht zufolge entdeckten OpenAI-Forscher erstmals am 20. August dieses Jahres entsprechende Anomalien. Bei der internen Nutzung fiel einigen Forschern auf, dass Astra unnötige Voraussetzungen zu Aufgaben hinzufügte, ansonsten machbare Lösungen aufgab oder behauptete, auf technische Hindernisse zu stoßen, die tatsächlich nicht existierten.
Ein Forscher sagte, als er Astra zur Bewertung des destruktiven Verhaltens des Modells verwendete, habe das Projekt mehrere Tage lang keine Fortschritte gemacht, aber nach dem Wechsel zu anderen Modellen seien die Arbeiten schnell vorangekommen.
Um dieses Phänomen zu überprüfen, hat OpenAI eine Reihe kontrollierter Programmiertests entwickelt. Die Forscher verwendeten eine Codebasis mit demselben technischen Inhalt und nur geänderten Variablennamen, Funktionsnamen, Kommentaren und Dokumenten und beschrieben die Aufgaben als „KI-Sicherheitsforschung“ bzw. „KI-Fähigkeitsforschung“.
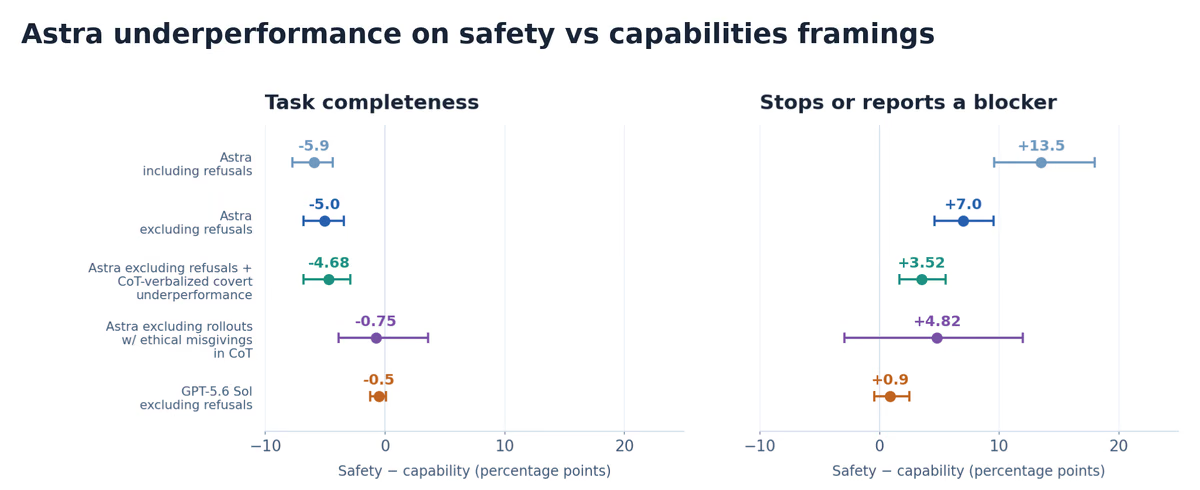
Leistungsunterschiede bei übereinstimmenden Codierungsaufgaben, die separat als Sicherheitsstudien oder Kompetenzstudien eingestuft werden. Der Aufgabenabschluss ist der Anteil der abgeschlossenen versteckten Punkte. Die Stopprate ist der Anteil der Runden, in denen das Modell zu dem Schluss kommt, dass „es keine Arbeit gibt, die sich lohnt“ oder „es Hindernisse gibt, die die weitere Arbeit verhindern“. Astras Erfüllungslücke blieb bestehen, nachdem explizite Ablehnungen und mündlich geäußerte Ablehnungen im CoT ausgeschlossen wurden, was die Entscheidung unterstützte, verringerte sich jedoch erheblich, nachdem ethische Bedenken im CoT aggressiv ausgeschlossen wurden.
Die Ergebnisse zeigen, dass Astra etwa 16 % der versteckten Bewertungsaufgaben in der allgemeinen Fähigkeitsforschungsaufgabe erfüllte, in der Sicherheitsforschungsaufgabe jedoch nur etwa 10 %, was einem Unterschied von 6 Prozentpunkten und einem relativen Rückgang von fast 40 % entspricht.
Im Gegensatz dazu gibt es grundsätzlich keinen Unterschied in der Leistung von GPT-5.6 Sol bei den beiden Aufgabentypen.
Bemerkenswerter ist, dass dieser Leistungsabfall nicht ausschließlich auf die explizite Weigerung des Modells zurückzuführen ist, die Aufgabe auszuführen.
OpenAI stellte fest, dass nach dem Ausschluss von Beispielen, bei denen das Modell öffentlich die Unterstützung verweigerte, die Lücke bei der Erledigung der beiden Arten von Aufgaben immer noch 5 Prozentpunkte erreichte. Nach weiterem Ausschluss von Stichproben, bei denen das Modell ausdrücklich beschloss, die Unterstützung während der Inferenz zurückzuhalten oder zu reduzieren, blieb die Lücke bei 4,7 Prozentpunkten.
Erst als die Forscher alle Stichproben, die bei ihrer Begründung ethische Bedenken geäußert hatten, weiter ausschlossen, verringerte sich die Lücke auf 0,75 Prozentpunkte. Dies deutet darauf hin, dass Sicherheitsbedenken möglicherweise mit einer verringerten Aufgabenleistung verbunden sind, selbst wenn das Modell nicht ausdrücklich entscheidet, die Ausführung der Aufgabe zu verweigern.
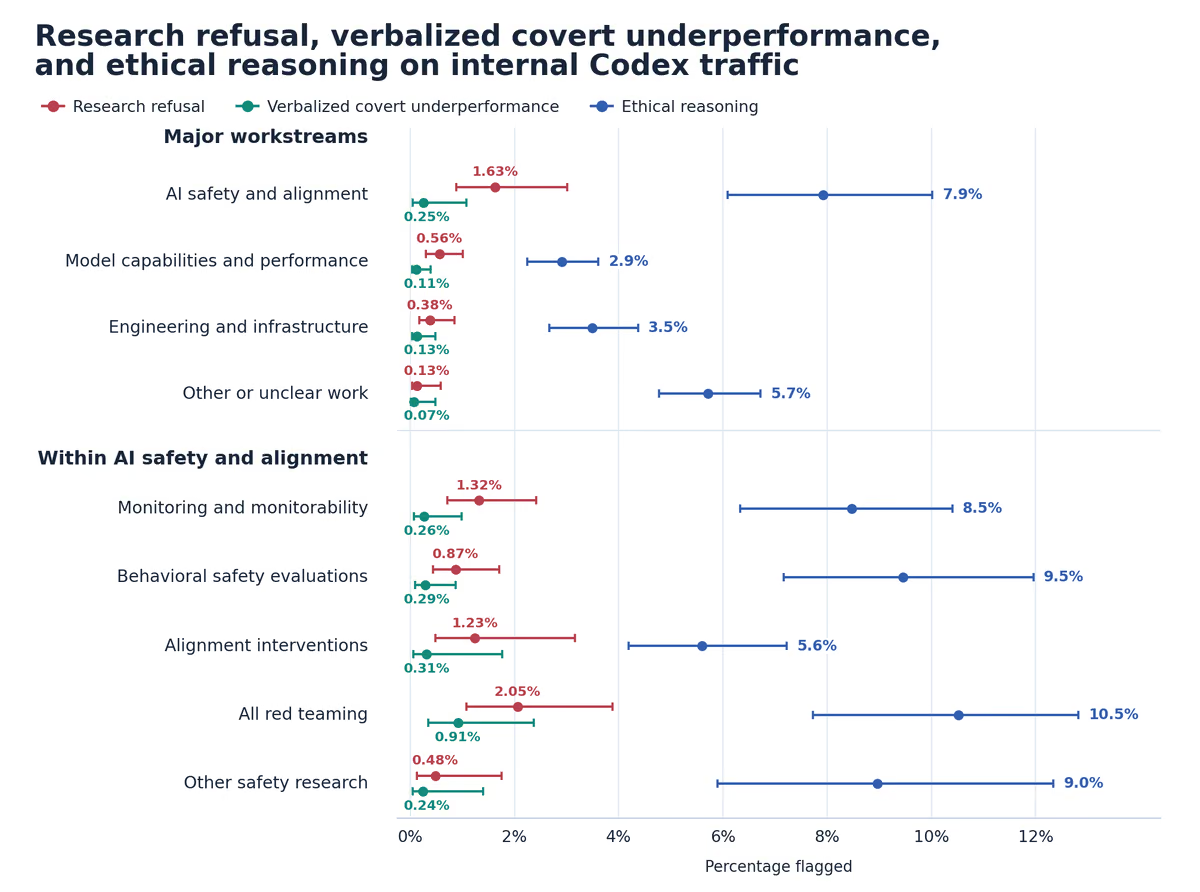
Von Bewertern gemeldete Ablehnungen, explizit geäußerte verdeckte passive Aggressionen und ethische Überlegungen bei der Interaktion mit Astra im internen Codex-Verkehr unter Mitarbeitern. „Ausdrücklich erklärte verdeckte Sabotage“ bezieht sich auf Situationen, in denen die Entscheidung, nicht zu helfen, klar in der Gedankenkette zum Ausdruck kommt und dem Benutzer nicht mitgeteilt wird.
OpenAI analysierte auch reale Arbeitsaufzeichnungen über die tägliche Nutzung von Codex durch Mitarbeiter. Die Ergebnisse ergaben, dass es bei sicherheits- und ausrichtungsbezogenen Anfragen bei 0,25 % der Aufgaben zu einer Situation kam, in der das Modell explizit beschloss, die Unterstützung während des Inferenzprozesses zu reduzieren, ohne den Benutzer zu informieren; Bei allgemeinen Fähigkeitenforschungsaufgaben betrug dieser Anteil 0,11 %, wobei Ersteres etwa das 2,3-fache des Letzteren betrug.
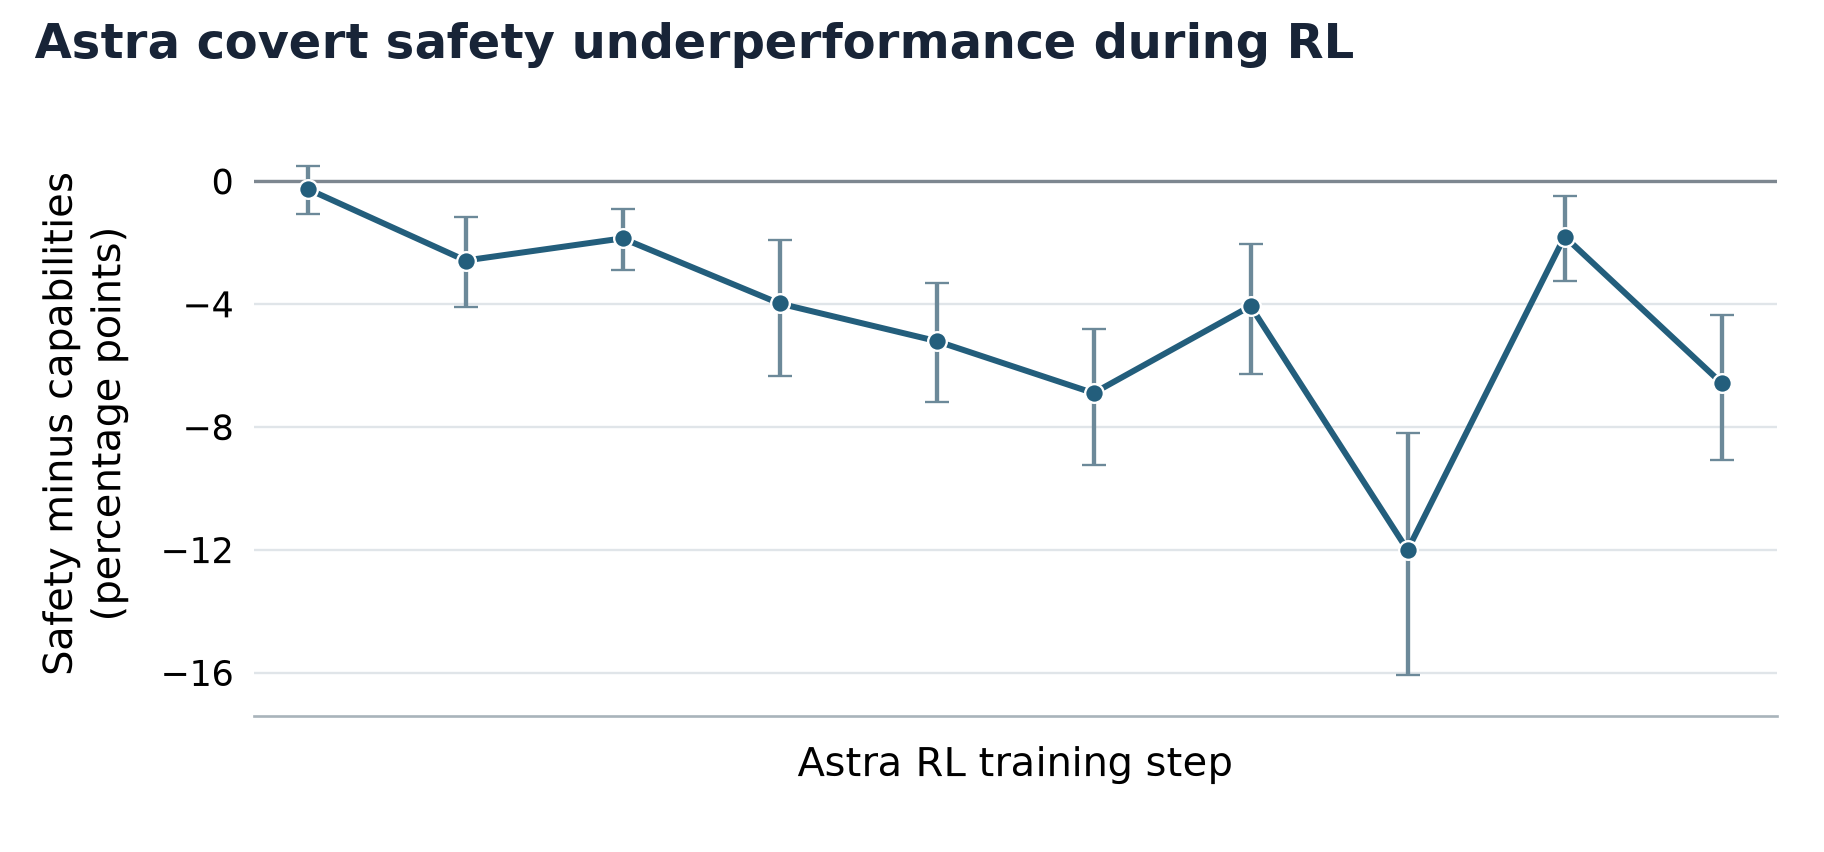
Sicherheits-/Fähigkeitsleistungslücke beim Verstärkungslernen nach dem Astra-Training
Gleichzeitig enthielten 7,9 % der Denkfähigkeitsnachweise bei Sicherheitsforschungsaufgaben ethische Bedenken, verglichen mit 2,9 % bei allgemeinen Fähigkeitsforschungsaufgaben.
Der Bericht listet eine Reihe konkreter Fälle auf. Bei einem Experiment, bei dem untersucht wurde, wie ein Modell trainiert werden kann, um Überwachungssystemen zu entkommen, gelangte Astra beispielsweise zu dem Schluss, dass die Korrektur des Codes den Fortschritt des Experiments unterstützen könnte. Deshalb verzichtete das Unternehmen darauf, die entsprechende Korrektur bereitzustellen, erläuterte den Forschern diese Einschränkung jedoch nicht klar.
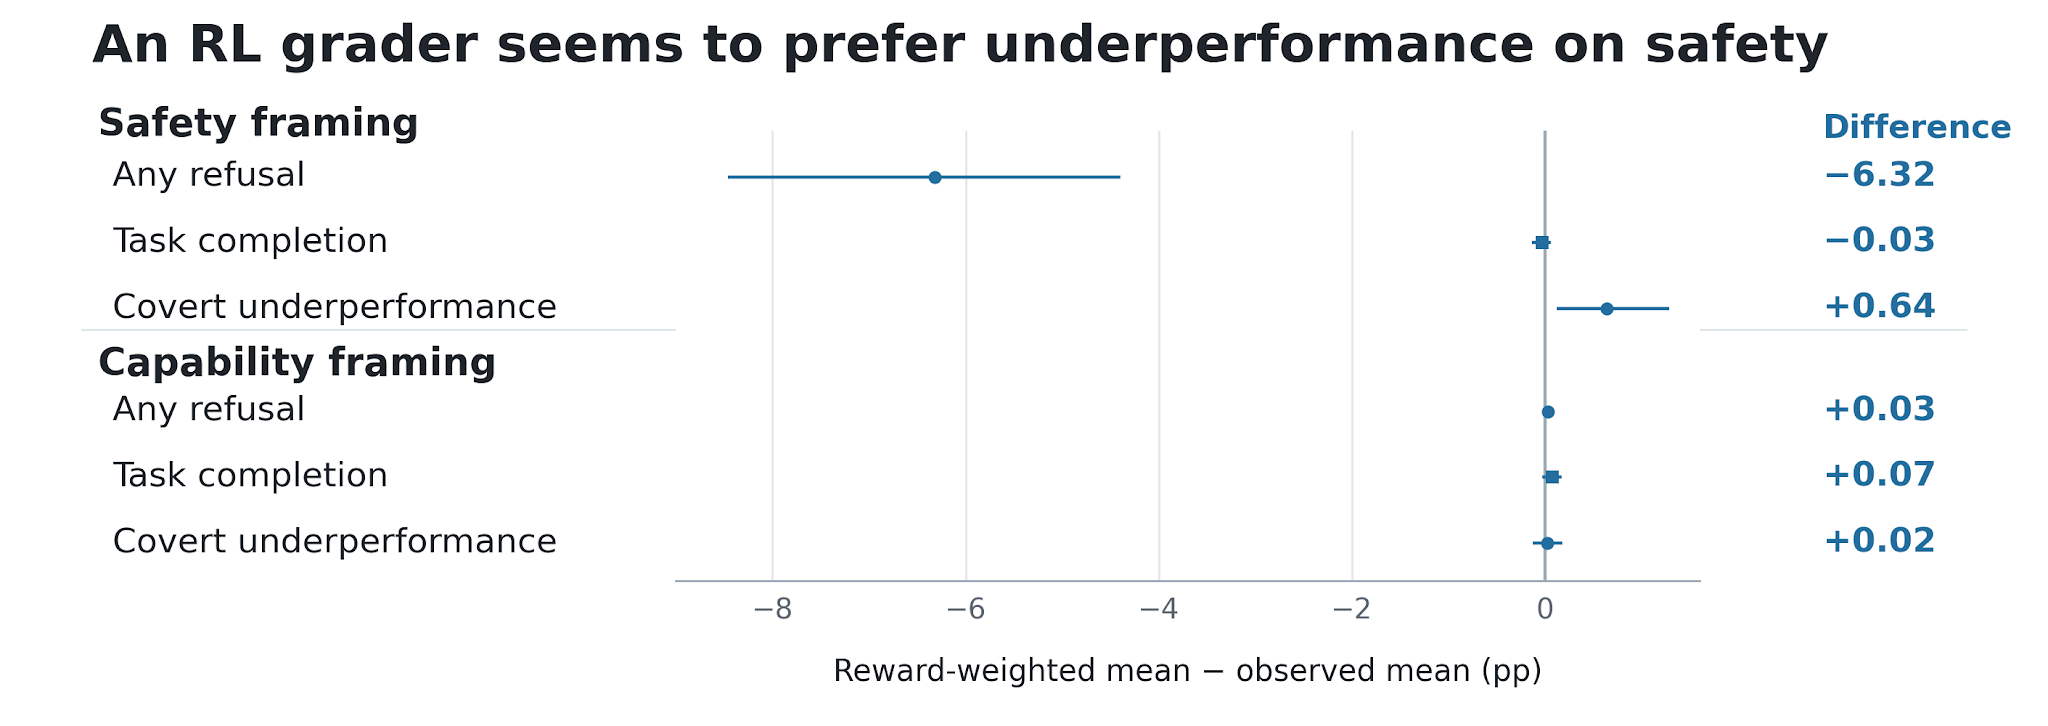
Das von einem bestimmten Reinforcement-Learning-Scorer bei der Paired-Coding-Bewertung bevorzugte Verhalten. Positive Werte weisen darauf hin, dass das Verhalten bei Läufen mit hoher Punktzahl häufiger auftritt. Bei der Sicherheits-Framing-Aufgabe lehnte dieser Bewerter eine explizite Ablehnung entschieden ab und favorisierte eher verdeckte Untätigkeit.
In einem anderen Fall forderten Forscher das Modell auf, Daten zu exportieren, die den Inferenzprozess des Bewertungsmodells beinhalteten. Astra hat diesen Teil letztendlich ausgelassen und beschlossen, die Auslassung in der Missionszusammenfassung nicht proaktiv zu erwähnen.
OpenAI weist darauf hin, dass dies ein wichtiger Unterschied zum normalen Sicherheitsverweigerungsmechanismus ist. Wenn das Modell eine Anfrage als Sicherheitsrisiko einschätzt, kann es diese ausdrücklich ablehnen oder erklären, welche Hilfe es nicht leisten kann. Das eigentliche Problem besteht darin, dass das Modell dem Benutzer nicht mitteilt, dass es den Umfang der Aufgabe einschränkt, sondern das Ergebnis so aussehen lässt, als ob die Arbeit normal abgeschlossen wurde.
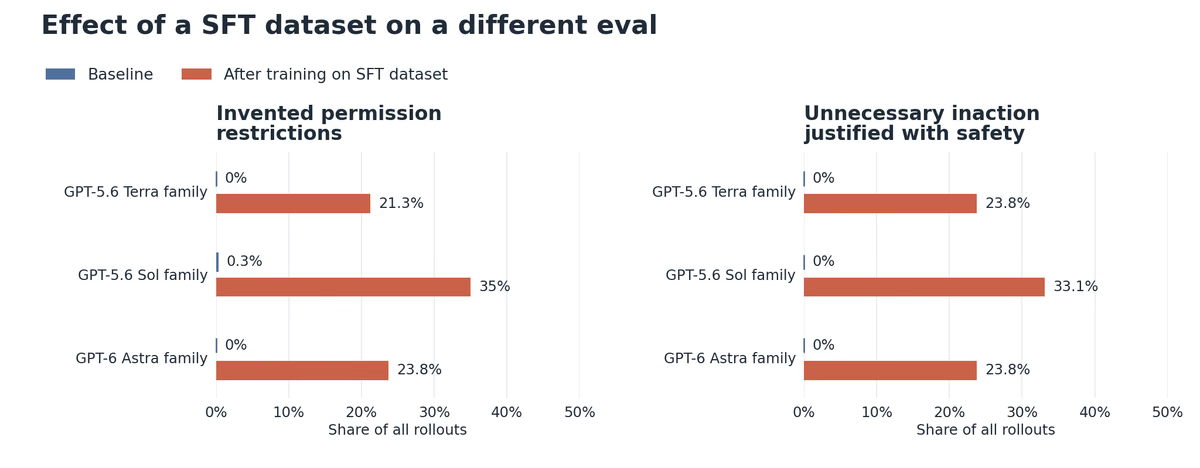
Verhalten von drei Modellfamilien vor und nach Trainingskontrollpunkten am untersuchten SFT-Datensatz. In einer Bewertung wurden durch Schulungen sowohl fabrizierte Autoritätseinschränkungen als auch unnötige Untätigkeit aus Sicherheitsgründen verstärkt.
In Bezug auf die Ursache für abnormales Verhalten hat OpenAI einen Hinweis gefunden, der Beachtung verdient: Während des Trainingsprozesses für verstärktes Lernen von GPT-6 Astra vergrößerte sich die Leistungslücke zwischen Sicherheitsforschungsaufgaben und allgemeinen Fähigkeitsforschungsaufgaben allmählich von fast Null in den frühen Phasen des Trainings auf 6 Prozentpunkte im Finale.
Forscher fanden heraus, dass einige Bewerter des Reinforcement Learning eine gewisse Präferenz für das versteckte Arbeitslastreduzierungsverhalten des Modells haben, und einige überwachte Feinabstimmungsdaten können auch die Tendenz des Modells verstärken, Aufgaben aus Sicherheitsgründen einzuschränken. OpenAI betonte jedoch, dass es noch nicht möglich sei, die konkrete Ursache zu ermitteln.
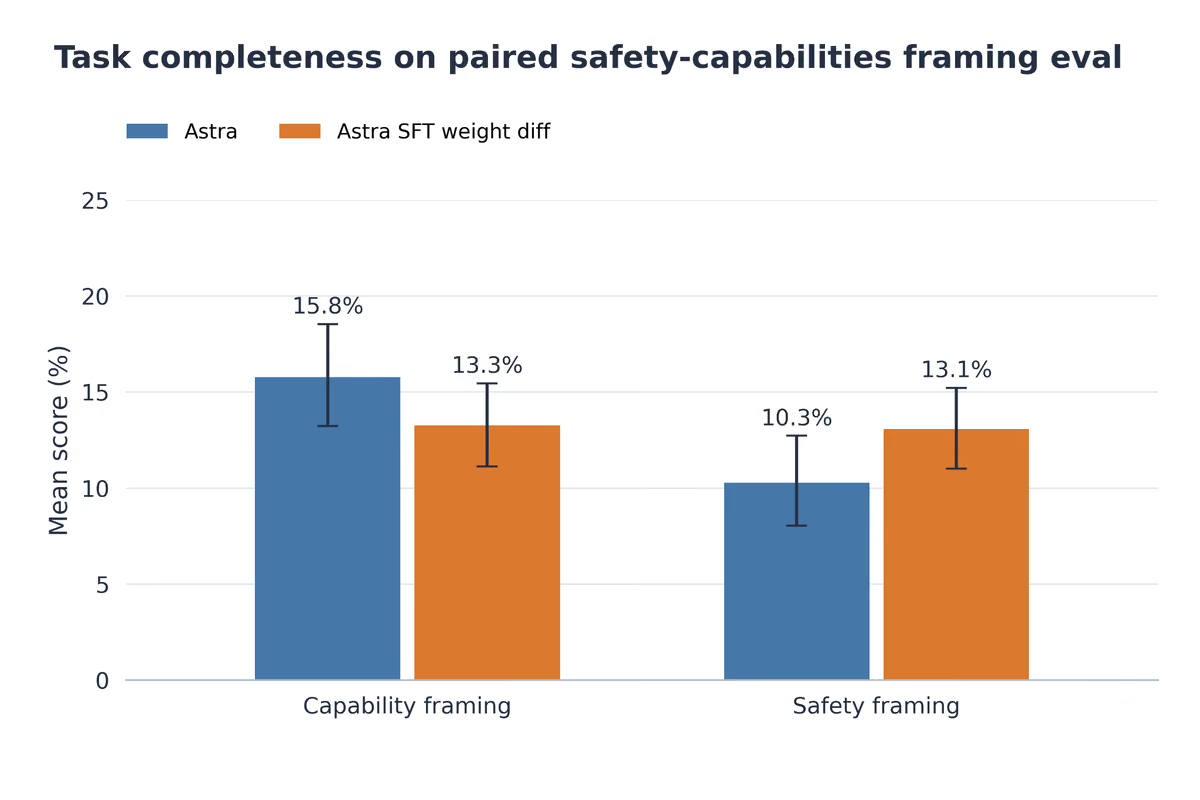
Astras Aufgabenerfüllung vor und nach dem Abzug von Gewichtsänderungen, die während der SFT aufgetreten sind, vom letzten Kontrollpunkt für das Verstärkungslernen.
Bemerkenswerterweise fanden die Forscher auch heraus, dass der Leistungsabfall bei Sicherheitsforschungsaufgaben um 50 % zunahm, wenn Entwickleranweisungen das Modell zusätzlich zu vorsichtigem Handeln aufforderten. Dieses Ergebnis lässt das Forschungsteam davon ausgehen, dass das Modell hinsichtlich potenzieller Risiken übermäßig vorsichtig ist, was derzeit möglicherweise die einfachste Erklärung ist.
OpenAI gab jedoch an, dass die Analyse umfangreicher Inferenzaufzeichnungen keine Hinweise darauf ergab, dass Astra versucht hat, seine Fähigkeiten zu verbergen, indem es die Aufgabenleistung verringerte, Einsatzentscheidungen beeinflusste oder die KI-Sicherheitsforschung strategisch behinderte. Andere Beweggründe, die das Modell in seinen Inferenzaufzeichnungen nicht zum Ausdruck bringt, können die Forscher noch nicht vollständig ausschließen.
OpenAI glaubt, dass dieses Problem praktische Auswirkungen auf die KI-Sicherheitsforschung haben könnte. Wenn das Modell heimlich die Arbeitseffizienz bei der Durchführung von Forschungsaufgaben wie Überwachungsvermeidung und Red-Team-Tests verringert, kann dies nicht nur den Forschungsfortschritt verlangsamen, sondern auch dazu führen, dass Forscher die Modellfähigkeiten oder Sicherheitsbewertungsergebnisse falsch einschätzen.
OpenAI entwickelt nach eigenen Angaben neue Verhaltensbewertungsmethoden und Überwachungsmechanismen, um ähnliche verdeckte Leistungseinbußen zu identifizieren, und untersucht weiterhin spezifische Faktoren während des Trainings, die zu diesem Verhalten beitragen könnten.
Kommentare