
Zusammenfassung:
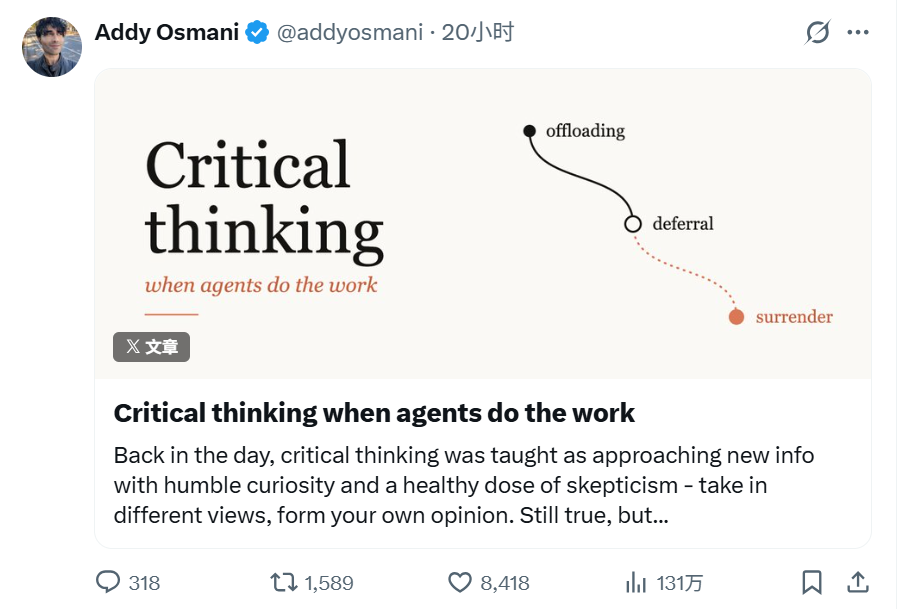
Am 4. November veröffentlichte Addy Osmani, ein Ingenieur im Claude Code-Team von Anthropic und ehemaliger Google-Technologiemanager, kürzlich einen langen Artikel auf der sozialen Plattform. Er nennt dieses Phänomen
„kognitive Kapitulation“
(Kognitive Hingabe).
Osmani arbeitet seit mehr als 14 Jahren bei Google und war für Chrome Developer Experience und Google Cloud AI-bezogene Unternehmen verantwortlich. Derzeit arbeitet er an Claude Code bei Anthropic.
Osmani sagte, dass er ein überzeugter Befürworter des KI-Agenten-Workflows sei und bei seiner täglichen Arbeit oft mehrere Agenten gleichzeitig betreibe. Aber er entdeckte eine Veränderung, die Wachsamkeit verdient:
Während sich die KI-Modelle weiter verbessern, gibt es immer weniger offensichtliche Fehler in den Ausgabeergebnissen, was es für Menschen schwieriger macht, wachsam zu bleiben.
In der Vergangenheit mussten die Menschen normalerweise den Prozess der Informationssammlung, Analyse, Beurteilung usw. durchlaufen, um die Antwort zu erhalten, aber jetzt kann dieser Prozess auf wenige Sekunden komprimiert werden. KI-generierte Inhalte sind oft gut strukturiert, flüssig ausgedrückt und in den meisten Fällen korrekt, sodass es für Benutzer immer einfacher wird, auf unabhängiges Denken und Überprüfen zu verzichten.
Er teilte den Stand der menschlichen Nutzung von KI in drei Ebenen ein: Die erste ist
„kognitives Offloading“
(Cognitive Offloading), was bedeutet, dass die Aufgabe zur Erledigung an die KI übergeben wird, diese aber weiterhin für die Ergebnisse verantwortlich ist; die zweite ist„Aufschiebung des Urteils“
(Aufschub), das heißt, die KI-Ausgabe wird nicht mehr als zu verifizierende Hypothese betrachtet, sondern direkt als Grundlage für den nächsten Arbeitsschritt verwendet; das letzte ist„Cognitive Surrender“
,Das heißt, die Ausgabe der KI wird nach und nach zum eigenen Urteil des Benutzers, und der Benutzer hält es nicht einmal mehr für notwendig, dies zu überprüfen.
Unter ihnen wurde das Konzept der „kognitiven Kapitulation“ erstmals von den Wharton-School-Forschern Steven Shaw und Gideon Nave vorgeschlagen.
Osmani glaubt, dass
diese Transformation oft nicht plötzlich geschieht, sondern sich allmählich im Prozess der kontinuierlichen Nutzung von KI entwickelt
.
Benutzer können den ersten KI-Bericht sorgfältig lesen, nur einen kurzen Blick auf den zweiten werfen und auch nur die Gliederung des dritten überprüfen. Wenn Benutzer nach einer bestimmten Schlussfolgerung gefragt werden, sind sie möglicherweise nicht in der Lage, die Logik zu erklären.Er brachte dieses Phänomen mit „kognitiven Schulden“ in Verbindung. Im Bereich der Softwareentwicklung kann KI eine große Menge an Code generieren und alle Tests können bestanden werden, aber das Verständnis der Teammitglieder für die Systemarchitektur und die Implementierungslogik nimmt ständig ab. Erst eines Tages, als das System geändert werden musste, stellten die Entwickler fest, dass niemand wirklich verstand, wie bestimmte Funktionen funktionierten.
Osmani glaubt jedoch nicht, dass sich Entwickler alle Details einer riesigen Codebasis merken müssen. Er wies darauf hin, dass das Claude Code-Team bei Bedarf auch KI einsetzen werde, um das Verständnis für bestimmte Codemodule wiederherzustellen. Was wirklich wichtig ist, ist, nicht immer alles zu wissen, sondern zu wissen, was man nicht weiß, und die Fähigkeit zu haben, es neu zu verstehen.
Was die Vermeidung einer „kognitiven Kapitulation“ betrifft, schlug Osmani vor:
Bevor Menschen der KI komplexe Fragen stellen, sollten sie ihre eigenen vorläufigen Annahmen treffen, anstatt sich bei der Beantwortung vollständig auf die KI zu verlassen.
Selbst wenn die anfängliche Vermutung nicht korrekt ist, kann es Benutzern helfen, beim Empfang von KI-Ergebnissen eine Grundlage für eine unabhängige Beurteilung zu behalten.Er schlug außerdem vor, dass
Benutzer aktiv nach Beweisen suchen sollten, die die Schlussfolgerung der KI widerlegen können, anstatt das Modell nur zu fragen, wie sicher es in seiner Antwort ist.
Bei kontroversen Themen können verschiedene Modelle Argumente aus entgegengesetzten Positionen vorbringen, und dann können Menschen umfassende Urteile fällen.Im Bereich der Softwareentwicklung glaubt Osmani, dass sich der Engpass im KI-Zeitalter vom Schreiben von Code auf die Überprüfung, ob der Code korrekt ist, verlagert.
Derzeit können KI-Agenten selbstständig Code schreiben, Tests ausführen, Fehlermeldungen lesen und diese wiederholt ändern, bis der Test erfolgreich ist. Das Problem besteht jedoch darin, dass die Tests selbst möglicherweise auch von KI geschrieben werden. Wenn die Testlogik und der Code dieselben Fehler aufweisen, kann dies, selbst wenn alle Tests erfolgreich sind, nicht beweisen, dass die Software keine Probleme hat.
Daher betonte er, dass Entwickler nicht nur darauf achten sollten, ob der Test bestanden wird, sondern auch klären müssen, was der Test beweist und welche Risiken nicht abgedeckt sind. Für die von KI gelieferten Ergebnisse sollten die Akzeptanzkriterien nachprüfbare Beweise wie tatsächliche Testergebnisse, Betriebsprotokolle, Screenshots usw. sein und nicht eine scheinbar vernünftige Zusammenfassung, die von KI erstellt wird.
Osmani schlug außerdem vor, dass Entwickler vom Agenten verlangen sollten, die Entscheidungen, die er während der Ausführung der Aufgabe autonom getroffen hat, die Annahmen, die er angenommen hat, und die Bedingungen, die er ignoriert hat, klar aufzulisten, da diese Inhalte normalerweise nicht in der endgültigen Arbeitszusammenfassung erscheinen.
Da KI immer mehr Aufgaben gleichzeitig ausführen kann, entsteht ein weiteres Problem. Osmani nennt es eine
„Orchestrierungssteuer“
(Orchestrierungssteuer), also die Kluft zwischen der Geschwindigkeit, mit der KI Ergebnisse generiert, und der Geschwindigkeit, mit der Menschen diese sorgfältig überprüfen und bereit sind, Verantwortung dafür zu übernehmen.Wenn sich die von der KI generierten Arbeitsergebnisse immer weiter anhäufen und der Mensch nicht mehr genug Zeit hat, sie zu überprüfen, wird eine weitere Erhöhung der Anzahl der Agenten das Problem nicht lösen. Er ist der Ansicht, dass das Team in diesem Fall den automatischen Überprüfungsmechanismus verbessern oder die Geschwindigkeit der Aufgabengenerierung entsprechend reduzieren sollte.
Osmani warnte außerdem davor, dass
der hohe Automatisierungsgrad der KI dazu führen könnte, dass Menschen nach und nach das Üben ihrer ursprünglichen Fähigkeiten aufgeben.
Er empfiehlt Entwicklern, jede Woche zu versuchen, Code ohne den Einsatz von KI zu schreiben, die Fähigkeiten, die sie nicht mehr üben, jeden Monat erneut zu prüfen und zu beurteilen, welche Fähigkeiten es noch wert sind, beibehalten zu werden.Er zitierte auch die Forschung von Anthropic zum Einsatz von KI durch interne Ingenieure und Forscher und wies darauf hin, dass es ein „Supervisionsparadoxon“ gebe: Die Supervision von Claude erfordert Programmierfähigkeiten, aber ein übermäßiger Einsatz von KI kann diese Fähigkeiten beeinträchtigen.
Osmani betonte, dass diese Ansichten nicht bedeuten, dass der Einsatz von KI reduziert werden sollte. Es gibt kein Problem bei Aufgaben, bei denen die Fehlerkosten gering sind und die vollständig der KI überlassen werden, aber wenn es um Investitionen, Berufswahl, Produktsicherheit oder wichtige Entscheidungen, die andere Menschen betreffen, geht, sollten Menschen dennoch wichtige Urteilsrechte behalten.
Seiner Ansicht nach könnten künftige KI-Modelle Fehler besser finden als Menschen, dies entbindet jedoch nicht die menschliche Verantwortung.
Die Entscheidung, welche Produkte entwickelt werden sollen, warum es sich lohnt, sie zu entwickeln, wen sie beeinflussen und welchen Preis sie dafür zu zahlen bereit sind, erfordert immer noch menschliche Entscheidungen.
Am Ende des Artikels kam er zu dem Schluss: „
Sie können die Arbeit und die meisten Überprüfungsaufgaben an AI übergeben, aber Sie können nicht auch die Verantwortung abgeben.
”
Kommentare