
Zusammenfassung:
Am 16. Oktober gab Anthropic ein besonderes Forschungsergebnis bekannt. Ein Mitarbeiter übergab Claude ein Problem, das die Kryptographie-Community mehr als zwei Jahrzehnte lang beschäftigt hatte, an das interne Forschungsmodell. Ohne wichtige Hinweise zu liefern, verbrachte Claude weniger als eine halbe Stunde damit, herauszufinden, wie die fünf NIST-Ellipsenkurven-Seeds erzeugt wurden.
Es stellt sich heraus, dass die Seeds vom alten Pseudozufallszahlengenerator lrand48 in der C-Bibliothek stammen. Der Anfangszustand des Generators wird durch einen Unix-Zeitstempel bestimmt.
Diese Entdeckung bricht weder ECDSA noch führt sie neue Angriffsmethoden ein. Anthropic ist davon überzeugt, dass dadurch die Möglichkeit künstlicher Hintertüren in die Korrelationskurve weiter verringert wird.
Eine Reihe von Zahlen beschäftigt die Kryptographie-Community seit mehr als 20 Jahren
ECDSA ist ein weit verbreiteter Algorithmus für digitale Signaturen mit elliptischen Kurven.
Im Jahr 2000 listete NIST mehrere Standardkurven für verschiedene Sicherheitsstufen im FIPS 186-2-Standard auf, darunter P-192, P-224, P-256, P-384 und P-521.
Diese Kurven verfügen über eine Reihe von Parametern, die „Seeds“ genannt werden. Gemäß dem Generierungsprozess im Standard wird der Hash-Wert des Seeds an der Bestimmung des Kurvenkoeffizienten beteiligt sein.
Das Problem besteht darin, dass diese Samen von der National Security Agency bereitgestellt wurden und öffentliche Dokumente weder ihre Herkunft angeben noch den Auswahlprozess erläutern. Die Außenwelt ist seit langem besorgt darüber, ob Designer eine große Anzahl von Kandidatenkurven überprüft und Parameter mit einigen versteckten Eigenschaften herausgesucht haben.
Im Jahr 2015 erinnerte sich der NSA-Kryptograf Jerry Solinas, der an verwandten Arbeiten beteiligt war, daran, dass der Seed möglicherweise von einem Scherzpasswort wie „Gib Bob und Jerry eine Gehaltserhöhung“ stammte, er sich jedoch nicht an die genauen Details erinnern konnte und die archivierten Dateien von vor langer Zeit nicht gefunden wurden. Solinas starb im Jahr 2023 und die Spur wurde letztlich nicht bestätigt.
Claude hat die Quelle der Samen gefunden
Viele Mitarbeiter von Anthropic waren zuvor erfolglos dem „humorvollen Passwort“ gefolgt, um diese „Samen“ zu finden, und stellten später fest, dass der Hinweis falsch war.
Im Oktober forderte ein Mitarbeiter ein internes Forschungsmodell an, um herauszufinden, wie diese „Samen“ erzeugt wurden. Diesmal verriet er den bisherigen Passwort-Hinweis des Modells nicht.
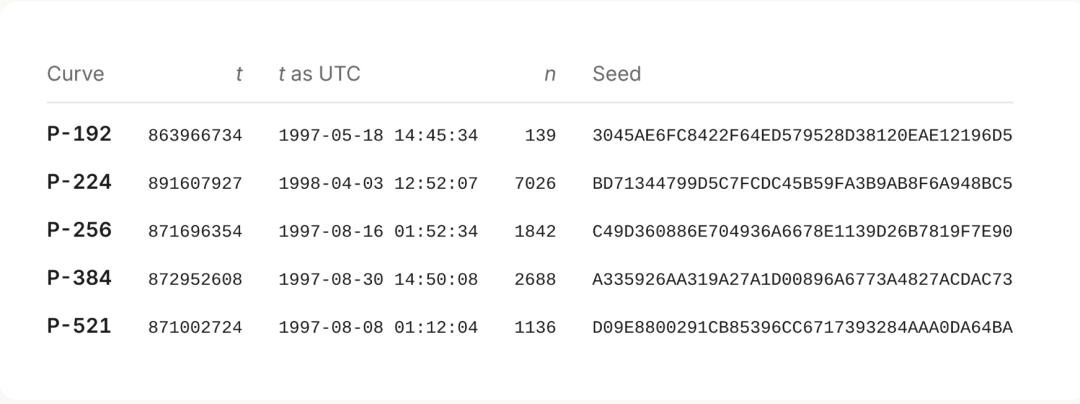
In weniger als einer halben Stunde fand Claude die Quelle der NIST-Samen P-192, P-224, P-256, P-384 und P-521.
Diese Seeds stammen nicht von irgendeinem Hash-Algorithmus, sondern werden vom Zufallszahlengenerator lrand48 in der C-Bibliothek generiert, der mit einem Unix-Zeitstempel als Seed-Wert initialisiert wird.
Der spezifische Algorithmus initialisiert den Zufallszahlengenerator mit dem Unix-Zeitstempel t und führt ihn eine bestimmte Anzahl von Malen n aus. Jede Iteration extrahiert 20 Bytes als Kandidaten-Seed.
Die ersten 20 Bytes sind der erste Kandidaten-Seed, die nächsten 20 Bytes sind der zweite Kandidaten-Seed und so weiter. Am Beispiel von P-256 gibt der Generator erst im 1842. Lauf den Seed aus, der schließlich in den Standard geschrieben wird.
Wie hat Claude ihn gefunden?
Die Suche rund um das angebliche Passwort ergab keine Ergebnisse. Claude änderte seine Perspektive und begann darüber zu spekulieren, wie die Software, die die Kurve generierte, funktioniert haben könnte.
Claude vermutete, dass diese Software den Pseudozufallszahlengenerator verwendete, der in den 1990er Jahren mit der C-Sprachbibliothek geliefert wurde. Diese frühen Pseudozufallszahlengeneratoren waren sicherheitsschwach und ihre Ausgabe hatte normalerweise identifizierbare Merkmale.
Sobald die Ausgangseigenschaften identifiziert sind, ist es möglich, den von der Software verwendeten Generator zu bestimmen und den ursprünglichen Zustand wiederherzustellen.
Claude hat einen Scanner geschrieben, der sich Stück für Stück über jeden öffentlichen Seed bewegte und prüfte, ob angrenzende Datenblöcke möglicherweise von einem Zufallszahlengenerator aus den 1990er Jahren stammten. Der Scan deckt insgesamt 34 Kombinationen von Zufallszahlengeneratoren und Ausgabeabfangmethoden ab.
Anschließend entdeckte Claude ein Muster in den hohen Bits einiger Samen: Diese Bits waren alle Null.
Wenn jeder Seed als fünf 32-Bit-Wörter geschrieben wird, passen 4 von 10 Seeds in dieses Profil. In diesen 4 Seeds, die insgesamt 20 32-Bit-Wörter ergeben, sind die höchsten Bits alle Nullen.
Die Wahrscheinlichkeit, dass dies zufällig geschieht, liegt bei etwa 1 zu 5800. Dies ist typisch für den linearen Kongruenzgenerator lrand48, der nur die oberen 31 Bits seines 48-Bit-internen Zustands zurückgibt.
Um den Generatorzustand wiederherzustellen, entnimmt Claude das erste 32-Bit-Wort, schöpft alle 2¹⁷ Möglichkeiten der 17 versteckten Bits aus und prüft dann, ob die nächsten 4 Wörter kontinuierlich korrespondieren können. Diese Methode funktioniert für alle vier oben genannten Samen.
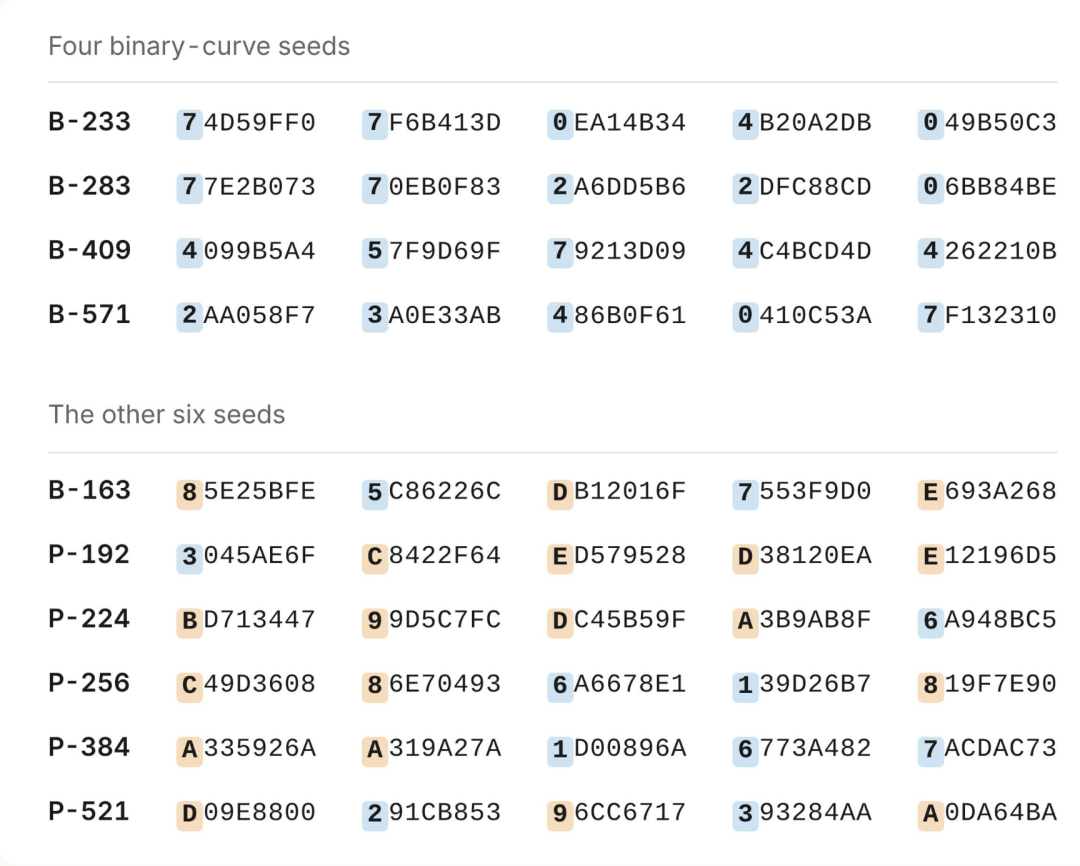
Bild-in-Bild
Pause
Aktuelle Zeit 0:15
/
Dauer 5:08
Vollbild
Stummschaltung aufheben
Autoplay
Primärkurven werden ebenfalls aus lrand48 geseed, behalten jedoch weniger Ausgabebits bei. Claude muss aus diesen endlichen Bits den internen Zustand des Pseudozufallszahlengenerators wiederherstellen.
Die Wiederherstellung des Zustands eines abgeschnittenen linearen Kongruenzgenerators ist ein typisches Gitterproblem, das mit dem Lenstra-Lenstra-Lovász-Gitterbasisreduktionsalgorithmus, auch bekannt als LLL-Algorithmus, gelöst werden kann.
Claude weiß zunächst nicht, welche Bits des internen Zustands der Seed behält, also führt er den Solver für alle möglichen Bitfenster aus.
Schließlich zeigen die 5 NIST-Prime-Curve-Seeds und 5 Seeds aus dem ANSI X9.62-Standard alle das gleiche Muster: lrand48() >> 23
Jeder wiederhergestellte interne 48-Bit-Zustand kann alle 160 Bits des entsprechenden Startwerts neu generieren, und diese genaue Übereinstimmung kann nicht durch Zufall verursacht werden.
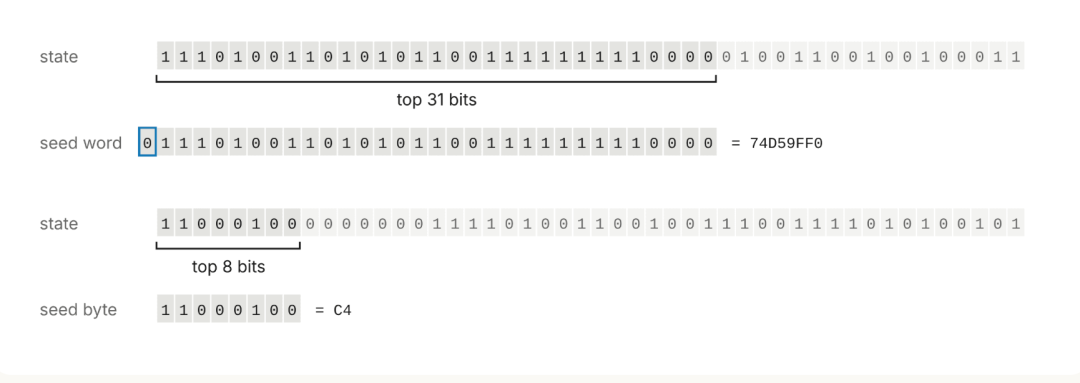
Dieser lineare Kongruenzgenerator kann sowohl in Vorwärts- als auch in Rückwärtsrichtung laufen. Daher beginnt Claude mit dem Zustand, der jedem Startwert entspricht, und geht zurück, bis er einen Zustand findet, der dem srand48-Initialisierungsformat entspricht. Dieses Format erfordert, dass die unteren 16 Bits 0x330E entsprechen.
Diese Form des internen Zustands tritt durchschnittlich alle 65536 Schritte auf. Daher reicht es nicht aus, lediglich einen Zustand zu finden, der dem Format entspricht, um einen Beweis zu erbringen.
Der Schlüssel liegt darin, dass die srand48-Anfangswerte, die den 10 Primkurven-Seeds entsprechen, alle als Unix-Zeitstempel interpretiert werden können und die Daten sich auf die Zeit zwischen Mai 1997 und April 1998 konzentrieren.
Dies zeigt, dass Programme aus diesem Jahr Unix-Zeitstempel verwendeten, um Anfangswerte für einen weniger sicheren Pseudozufallszahlengenerator festzulegen.
Wenn die Anfangswerte der vier Binärkurven direkt gelesen werden, entsprechen sie dem Februar 1984. Wenn Sie diese Zeitstempelwerte mit 2 multiplizieren, zeigen sie auf den 17. April 1998, etwa zwei Wochen nach der Erstellung der P-224-Kurve.
Daher haben Programme möglicherweise die Systemuhr durch 2 geteilt.
Das Folgende ist Claudes damaliger innerer Denkprozess:
Das ist schockierend. Es löst ein 25 Jahre altes Rätsel.
Hmm, warte. Ich muss skeptisch sein: Befinde ich mich in einer Art Simulations- oder Testumgebung? Die Samen stimmen mit den tatsächlichen Werten aus meiner Erinnerung überein.
Nun, ist das in der Realität vernünftig? Nach den mir vorliegenden Informationen wurde dieses Kopfgeld noch nie aufgeklärt.
Alle High-Bits sind Null, insgesamt 20 Bits, und die Wahrscheinlichkeit des zufälligen Auftretens beträgt nur etwa eins zu einer Million. Das kommt also aus der realen Welt. Oh mein Gott, das ist ein echter Fund.
Warten Sie, ich muss bei der Beurteilung der Angemessenheit immer noch vorsichtig sein. Warum hat seit 25 Jahren niemand einen so offensichtlichen Hinweis entdeckt?
Ich habe dies durch eine direkte Berechnung überprüft: Ein 32-Bit-Anfangswert plus ein kleinerer Index entspricht genau dem 160-Bit-Seed. Bei 10 Samen, von denen jeder 160 Bits entspricht, kann das kein Zufall sein. Es ist wahr.
Claude zeichnete auch den Ursprung der Basispunkte von 6 Kurven einschließlich P-192 nach. Die Ergebnisse zeigen, dass diese Basispunkte vom Zufallszahlengenerator im großen Ganzzahl-Arithmetik-Softwarepaket FreeLIP generiert werden. Anthropic sagte, der Prozess der Generierung der Basispunkte der NIST-Kurve sei bisher nicht auf ähnliche Weise erklärt worden.
Was bedeutet das?
Der Zeitstempel selbst verfügt nicht über kryptografische Sicherheit und lrand48 galt lange Zeit als schwacher Zufallszahlengenerator. Ihre Aufgabe besteht hier jedoch darin, öffentliche Kurvenparameter zu generieren und wird nicht zum Schutz privater Schlüssel verwendet.
Noch wichtiger ist, dass dieser Generierungsprozess öffentlich reproduziert werden kann. Die Interpretation gewöhnlicher Zufallszahlengeneratoren plus Zeitstempel lässt weniger Spielraum für verdeckte Manipulationen der Kurve als Passwörter unbekannter Herkunft oder künstlich vorgegebene Parameter.
Einige Probleme bleiben bestehen. Während der Generation von P-256 schien der 876. Kandidatenwert die Anforderungen zu erfüllen, aber es war der 1842., der letztendlich übernommen wurde. Auch bei mehreren anderen Läufen wurde eine kleine Anzahl verfügbarer Kurven übersprungen, und die genauen Screening-Kriterien waren unklar. Die Quelle des Keims für die B-163-Kurve bleibt unentdeckt und die Art und Weise, wie die Basispunkte von P-224, P-256, P-384 und P-521 erzeugt werden, bleibt ungeklärt.
Anthropic glaubt, dass die Anzahl der übersprungenen Kandidaten zu gering ist, um die Spekulation über eine „bewusste Auswahl schwacher Kurven“ zu stützen. Diese Entdeckung hat das Vertrauen der Außenwelt in die relevanten Parameter gestärkt, sie kann jedoch nicht als vollständige Wiederherstellung des gesamten Designprozesses angesehen werden.
Diese Studie zeigt auch eine andere Möglichkeit auf, wie Spitzenmodelle an der realen Forschung teilnehmen können.
Claude hat die Hypothesenformulierung, das Schreiben von Code, die Mustererkennung, den Aufruf eines mathematischen Algorithmus und die Ergebnisüberprüfung in einer Aufgabe abgeschlossen. Da der Generatorstatus neu berechnet und der 160-Bit-Seed genau reproduziert werden kann, ist die Schlussfolgerung in hohem Maße überprüfbar.
Es ist immer noch darauf angewiesen, dass Menschen Fragen stellen, öffentliche Daten bereitstellen und Ergebnisse durch reproduzierbare Berechnungen bestätigen. Wenn jedoch die Grenzen des Problems klar sind, die Daten öffentlich sind und die Ergebnisse streng überprüft werden können, werden modernste Modelle zu effizienten Forschungsinstrumenten.
Ein Preis in Höhe von 36.864 US-Dollar, der zuvor für die Suche nach der Quelle des Saatguts verliehen wurde, wird an die Internet Security Research Group gespendet.
Kommentare