Zusammenfassung:
Der Linux-Entwickler Osama Arif hat zwei Patches an die Kernel-Mailingliste gesendet, die darauf abzielen, Anforderungskonflikte zu reduzieren, wenn zswap Swap-Seiten lädt. Zswap ist der Komprimierungs-Cache-Mechanismus von Linux. Es komprimiert die auszulagernden Seiten und legt sie vorübergehend im Speicher ab. Wenn die Seiten aus dem Komprimierungscache gelesen werden können, kann der Zugriff auf das Swap-Gerät reduziert werden, was besonders hilfreich ist, um den E/A-Druck der Festplatte zu verringern, wenn der Speicher knapp ist.
Das Problem besteht darin, dass der vorhandene Code dafür sorgt, dass komprimierte Schreibvorgänge und komprimierte Lesevorgänge asynchrone Komprimierungsanforderungen pro CPU und Mutex-Sperren gemeinsam nutzen. Wenn eine Schreibaufgabe mit niedriger Priorität während des Sperrzeitraums vorzeitig beendet wird, muss möglicherweise auch eine Leseaufgabe mit hoher Priorität warten. Der erste Patch setzt Anfragen, Warteobjekte und Mutex-Sperren für die Komprimierung bzw. Dekomprimierung, sodass das Lesen nicht mehr durch Schreibaufgaben blockiert wird; Der zweite Patch ermöglicht es dem synchronen Softwarekomprimierungsalgorithmus, On-Stack-Anfragen zu verwenden, um die ZSWAP-Sperre weiter zu umgehen. Algorithmen, die eine asynchrone Verarbeitung oder zusätzlichen Anforderungskontext erfordern, verwenden weiterhin Anforderungen pro CPU und Mutex-Sperren.
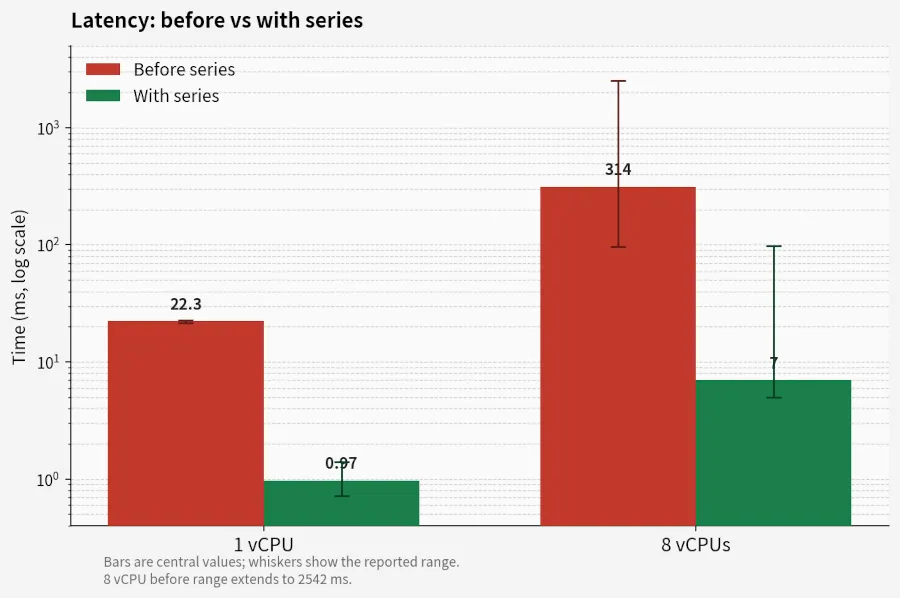
Vom Patch-Autor veröffentlichte Benchmark-Tests zeigen, dass in einer einzelnen virtuellen CPU-Umgebung die durchschnittliche langsamste Leselatenz pro Runde von 22,3 Millisekunden auf 0,97 Millisekunden sank; In einer Umgebung mit 8 virtuellen CPUs sank sie von 314 Millisekunden auf 7 Millisekunden. Jeder Test wurde 5 Runden lang durchgeführt, wobei der ZSTD-Kompressor, die virtuelle Maschine und die Speicherfestplatte als Umschaltgeräte verwendet wurden und Last durch Aufgaben mit unterschiedlicher Priorität erzeugt wurde. Die Anzahl der Lesevorgänge über 10 Millisekunden wurde ebenfalls von 26 auf 35 Mal pro Runde in einem Single-Core auf Null reduziert, und in einer Multi-Core-Umgebung wurde sie von 3 auf 18 Mal pro Runde auf maximal ein Mal reduziert. Die Autoren geben an, dass Benchmarks und Testprogramme mit Hilfe großer Sprachmodelle geschrieben werden.
Diese Zahlen spiegeln Verbesserungen der Leselatenz in bestimmten Stresstests wider und bedeuten nicht, dass alle Linux-Geräte oder täglichen Arbeitslasten die gleiche Gesamtgeschwindigkeit erfahren.
Der Patch befindet sich noch in der Überprüfungsphase der Kernel-Mailingliste und wurde noch nicht in den Hauptkernel integriert:
https://lore.kernel.org/lkml/
[email protected]
/
Kommentare