
Zusammenfassung:
Ein Google DeepMind-Ingenieur hat kürzlich ein kreatives Experiment demonstriert: Er hat das kleine Sprachmodell Gemma 3 270M von Google erfolgreich direkt in einem gewöhnlichen Büro-Laserdrucker ausgeführt. Die Anzahl der Parameter dieses Modells beträgt etwa 270 Millionen, und der im Experiment verwendete Drucker verfügt nur über 14,1 MB verfügbaren Speicher, erreicht aber dennoch eine Generierungsgeschwindigkeit von mehr als 60 Wörtern pro Sekunde.
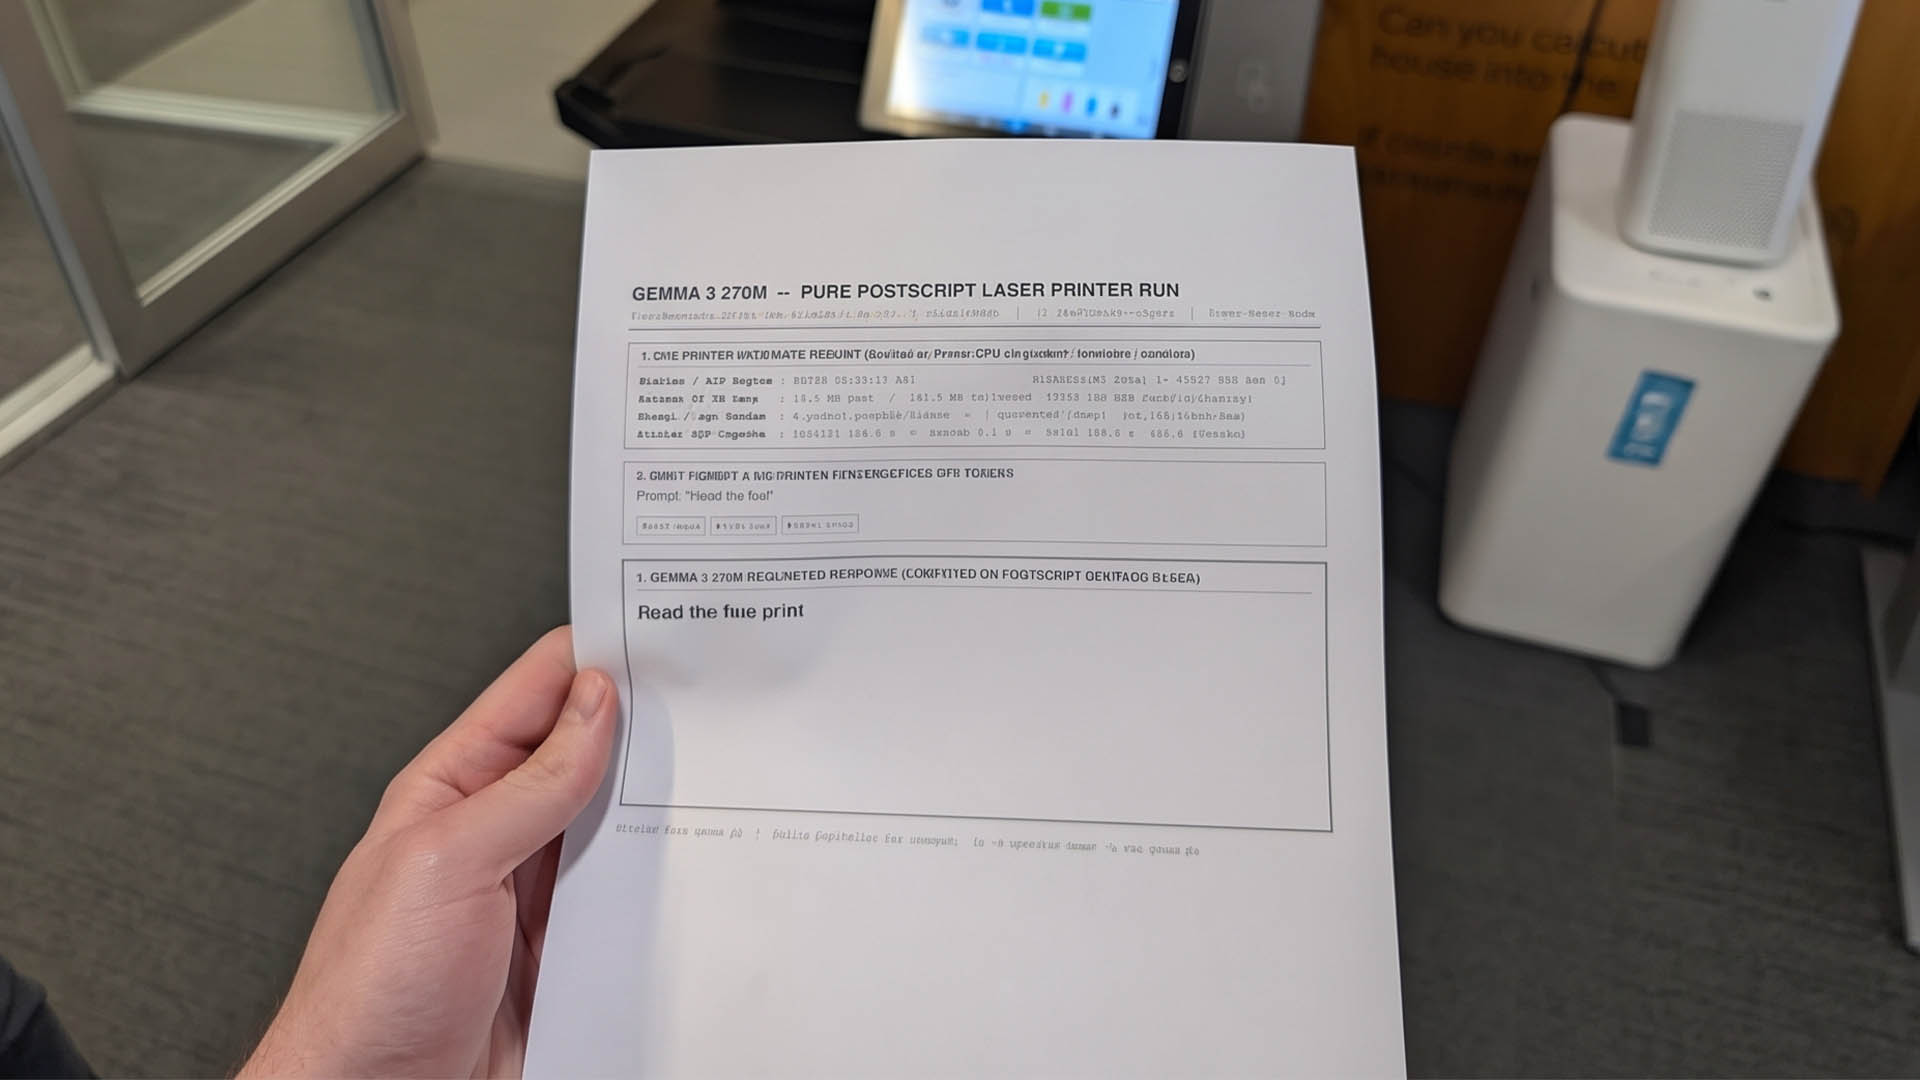
Dieses Ergebnis gab Ingenieur Omar Sanseviero auf der sozialen Plattform X bekannt. Er sagte, dass er mit Hilfe des Carbon-Projekts das Gemma-Modell direkt auf dem Bürodrucker ausgeführt habe. Während des gesamten Experiments wurde weder die Firmware des Druckers verändert, noch wurde eine externe Computerplatine oder andere Hardware verwendet. Stattdessen stützte es sich vollständig auf die in moderne Laserdrucker integrierte Seitenbeschreibungssprache PostScript.
PostScript ist eine Turing-vollständige Seitenbeschreibungssprache, die häufig verwendet wird, um zu steuern, wie Drucker Text, Grafiken und Seitenlayout darstellen. Das experimentelle Team verwendete Carbon, eine leichte Transformer-Inferenz-Engine, und kombinierte sie mit dem quantisierten Gemma 3 270M-Modell, um schließlich eine originale PostScript-Druckdatei zu generieren. Wenn der Drucker die Datei ausführt, schließt er tatsächlich die Inferenzberechnung des Sprachmodells in seinem PostScript-Interpreter ab.
Um zu vermeiden, dass der Druckerspeicher während der Modellinferenz knapp wird, wurde im Experiment die dynamische Laminar-Flow-Ladetechnologie eingesetzt. Das System lädt ständig verschiedene Schichten des Modells in den Speicher und aus dem Speicher und hält die maximale Speichernutzung bei nur 14,1 MB, während der Drucker 244,6 MB virtuellen PostScript-Speicher zuweist. Trotzdem erreichte der Gemma 3 270M immer noch eine Generierungsgeschwindigkeit von 61,3 Token/s auf der CPU des Druckers.
Laut den im Experiment erfassten Hardwareinformationen führt dieser Ricoh-Drucker nativ 18-Schicht-Transformer-Berechnungen innerhalb des PostScript Level 3-Interpreters durch. Bei Eingabe der Eingabeaufforderung „Lesen Sie das Bußgeld“, die nur vier Token enthält, dauert die Vorfüllphase 184 Sekunden, während die Dekodierungszeit zum Generieren eines einzelnen Tokens nur 0,1 Sekunden beträgt und der gesamte Verarbeitungsprozess insgesamt 184 Sekunden beträgt.
Nachdem die Berechnung abgeschlossen ist, druckt der Drucker schließlich die aus drei Wörtern bestehende Antwort „Lesen Sie das Kleingedruckte“ direkt auf das Papier. Dieses Ergebnis beweist nicht nur, dass das Modell tatsächlich die Überlegungen im Inneren des Druckers vervollständigt, sondern zeigt auch, dass das Potenzial der täglichen Büroausrüstung auf Softwareebene weit über den Erwartungen der Menschen liegt. Obwohl dieser Betriebsmodus nicht für tatsächliche Produktionsumgebungen geeignet ist, zeigt er die Grenzen dessen auf, was möglich ist, wenn kleine quantitative Modelle, Inferenz-Engines und vorhandene Hardwarefunktionen kombiniert werden.
Kommentare