
Zusammenfassung:
Ähnlicherweise kostete die neue Version von DeepSeek weniger als 40 % von Claude Opus 5.5, um alle 10 Programmieraufgaben korrekt auszuführen, und die durchschnittliche Wartezeit für jede Aufgabe war zwei Minuten länger.
Am 17. Oktober veröffentlichte DeepSeek V4.1-Flash-1017 und der Preis blieb unverändert. Nach seiner Veröffentlichung haben Entwickler es bereits zum Erstellen von Spielen, zum Erstellen von Webseiten und zum Ändern von Code verwendet.
Um das tatsächliche Niveau zu testen, wählte Entwickler Ibragim Badertdinov 10 Aufgaben aus seiner täglichen Arbeit aus und ließ verschiedene Modelle dreimal mit demselben Satz Programmiertools laufen, wobei er den hohen Inferenzgang von DeepSeek V4.1-Flash-1017 und den niedrigen Gang von Opus 5.5 und GPT-6 Astra nutzte.
Nach dem eigentlichen Test haben alle drei Modelle den Test bestanden, aber die Lücke wurde durch die Abrechnung und den Zeitaufwand noch größer: DeepSeek gab durchschnittlich nur 0,045 US-Dollar pro Aufgabe aus, was weitaus weniger war als die 0,1168 US-Dollar von Opus und die etwa 0,26 US-Dollar von GPT-6 Astra; Opus und GPT benötigten jedoch nur 37 bzw. 55 Sekunden für den Abschluss, während DeepSeek 2 Minuten und 38 Sekunden benötigte.
Diese 10 Aufgaben sind alle kleinformatig. Ist die Lücke zwischen DeepSeek, GPT und Claude als Gesamtprojekt nur eine Frage des längeren Wartens?
Alle zehn Fragen im Jahr 01 bestanden, DeepSeek spart Geld, Opus spart Zeit
Die Themen, die Ibragim ausgewählt hat, stammen aus etwa drei Monaten seiner eigenen Aufzeichnungen über die Verwendung von Agenten, einschließlich Datenverarbeitung, Back-End, Front-End und Bereitstellung unter Verwendung von Python und TypeScript. Er wählte die Aufgaben aus, die er normalerweise in weniger als einer Stunde erledigen konnte, und fügte ihnen dann automatische Prüfprogramme hinzu.
Ein vereinfachtes Beispiel, das er offenbarte, ist das Importieren eines Datenstapels in eine lokale Datentabelle. Zusätzlich zum erfolgreichen Import muss das Programm auch doppelte Datensätze überspringen, widersprüchliche Zahlen ablehnen und unbefriedigende Daten melden; Beim Ersetzen alter Daten kann der ursprüngliche Inhalt nicht nach der Hälfte des Schreibvorgangs zerstört werden. Der Test prüft auf leere Eingaben, Datenkonflikte, Beschädigung der Originaldatei usw.
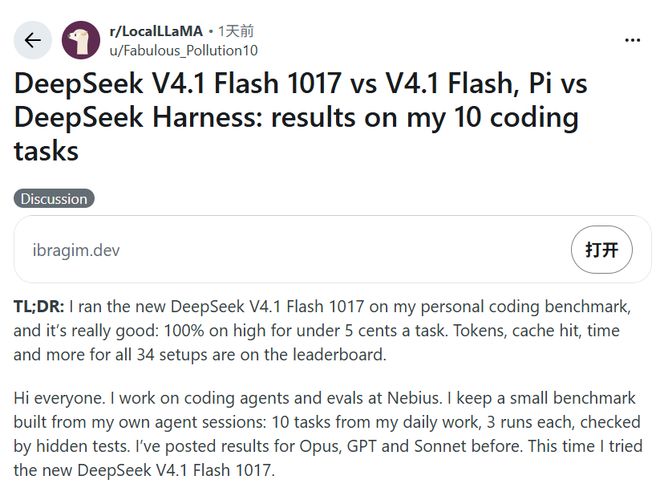
Alle drei Modelle haben diese Prüfungen bestanden, aber DeepSeek hat weitere Schritte unternommen.
DeepSeek läuft ebenfalls auf dem Pi-Programmiertool und benötigt durchschnittlich 15,3 Schritte pro Aufgabe, Opus benötigt 3,7 Schritte und GPT-6 Astra benötigt 6,5 Schritte. Die gesamte Token-Nutzung von DeepSeek beträgt etwa 547.000 und die von Opus etwa 31.000.Ich benutze viel, aber die Rechnung steigt nicht. Ibragim erklärte, dass fast alle DeepSeek-Eingaben den Cache erreichten und die aufgezeichnete Cache-Trefferquote 97,9 % erreichte. Die 547.000 Token wurden vom Modell nicht neu geschrieben. Eine so lange Antwort beinhaltete Inhalte, die in mehreren Anrufrunden wiederholt gesendet wurden. Durch günstige zwischengespeicherte Eingaben blieben die Kosten für diesen Test unter 5 Cent pro Test.
Ob diese zwei Minuten für Benutzer einen Einfluss haben, hängt davon ab, ob sie vor dem Bildschirm gewartet haben. Nach der Übergabe der Aufgabe und der anschließenden Erledigung anderer Dinge darf das Warten kein Hindernis sein; Wenn Sie unmittelbar nach Sichtung der Ergebnisse mit der nächsten Änderungsrunde beginnen möchten, ist die Geschwindigkeit von Opus und GPT in dieser Testreihe nützlicher. Verglichen werden hier die Kosten für die Erledigung von Aufgaben über die API, nicht die monatliche Gebühr für ChatGPT- oder Claude-Abonnementpakete.
Die neue Version ist im Vergleich zur Vorgängerversion ebenfalls verbessert. Zuvor verwendete Ibragim zum Testen die höchste Inferenzeinstellung der September-Version von Flash und bestand 28 von 30 Durchläufen, mit einer durchschnittlichen Zeit von 4 Minuten und 30 Sekunden für jeden Test. Diesmal hat es mit der neuen Version der High-End-Einstellung alle 30 Mal bestanden und die Zeit wurde auf 2 Minuten und 38 Sekunden reduziert.
02 Ich habe einen BMW für 0,38 $ gebaut, aber es dauerte 40 Minuten, eine normale Webseite zu betreiben
Was DeepSeek dieses Mal zeigen möchte, ist nicht nur das Ausfüllen einer Funktion. Zu den offiziell veröffentlichten Fällen gehören die 3D-Szene „Verbotene Stadt“, ein Web-Rennspiel und eine mit Godot produzierte Reproduktionsdemonstration „Portal 2“. Das Unternehmen gibt an, dass die neue Version die Fähigkeit verbessert, Projekte von Grund auf durch bestärkendes Lernen mit Selbstfeedback abzuschließen.
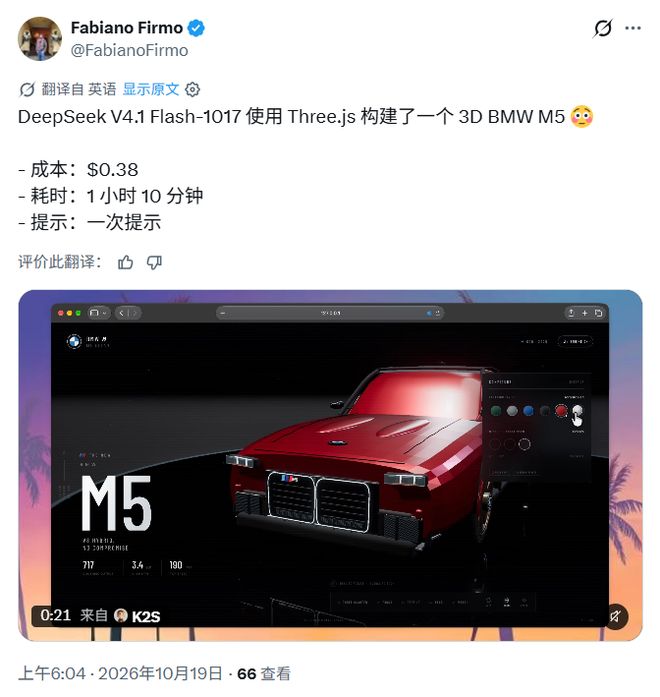
Entwickler Fabiano Firmo bat ihn, mit Three.js ein 3D-Modell des BMW M5 zu erstellen. Auf dem von ihm geposteten Bild erscheint auf der Anzeigeseite ein rotes Auto mit Farboptionen daneben.
Seiner Aussage zufolge hat er dieses Mal nur eine Mahnung verschickt, die 0,38 $ gekostet hat und 1 Stunde und 10 Minuten gedauert hat.
Einige Benutzer demonstrierten auch ein Spiel ähnlich der „Rocket League“, bei dem Autos auf dem Spielfeld Fußball spielen. X-Benutzer Markets & Mayhem kommentierte, dass die Physikeffekte normal funktionieren und es spielbar ist, es aber noch verbessert werden muss. Für jemanden, der zunächst einen Prototyp einer Webseite oder eines Spiels erstellen möchte, ist der Nutzen dieser Demos einfacher zu erkennen als Musterprüfungsergebnisse.
Die Bereitschaft, mehr als eine Stunde zu warten, um ein 3D-Auto zu sehen, bedeutet jedoch nicht, dass Sie auch bereit sind, so lange zu warten, um eine gewöhnliche Webseite zu erstellen.
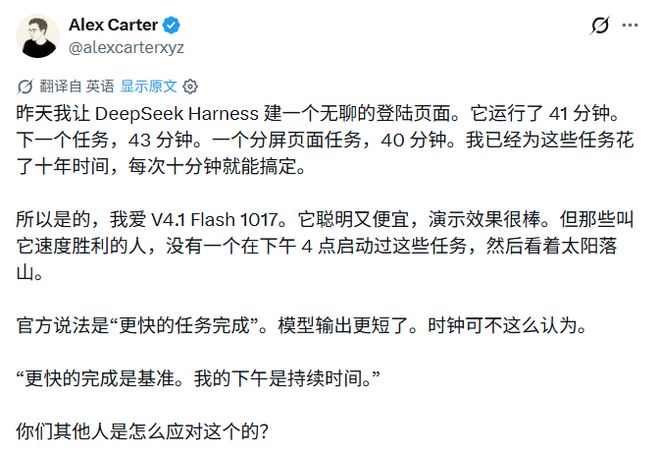
Entwickler Alex Carter sagte, er habe DeepSeek Harness gebeten, eine gewöhnliche Landingpage zu erstellen, deren Ausführung 41 Minuten dauerte; Die nächsten beiden Webseitenaufgaben dauerten weitere 43 bzw. 40 Minuten. Er fand das Modell schick, billig und gut präsentiert, aber die Seiten waren jahrelange Arbeit und konnten normalerweise in zehn Minuten fertiggestellt werden.
Developer Unbug hat auch ein ähnliches Gefühl: Das Modell ist intelligenter geworden, aber es ist leicht, zu lange nachzudenken und Maßnahmen zu verzögern. Ein anderer Benutzer, Elshayib, betonte, dass es bei seiner Beschwerde nicht um die Anzahl der pro Sekunde ausgegebenen Wörter ging, sondern dass das Modell zu lange zum Nachdenken brauchte, bevor es handelte.
Ein Test der API-Plattform OmniaKey hat diese lange Argumentationsausgabe aufgezeichnet. Die neue Version von Flash muss ein Programm schreiben, das Ausdrücke gemäß den Python-Operationsregeln berechnet, und kann keine vorgefertigten Analysetools aufrufen. Das Modell brauchte etwa 88 Sekunden, um alle 30 Inspektionsanwendungsfälle zu bestehen. Von den etwa 20.700 ausgegebenen Token wurden etwa 19.700 als Inhalt betrachtet.
Aber Flash ist nicht für alle Aufgaben langsam. In einem weiteren Test von OmniaKey extrahierte es 10 Felder aus einer Rechnungs-E-Mail, die in Deutsch und Englisch gemischt war, und beantwortete sie alle in 5,2 Sekunden korrekt; Der Tool-Aufruf zur Abfrage des Wetters und der Uhrzeit in zwei Städten wurde in 2,6 Sekunden abgeschlossen. OmniaKey selbst verkauft die Modell-API und jeder dieser Tests wird nur einmal ausgeführt.
Bei diesen Beispielen für BMW-Modelle und Landingpages handelt es sich nicht um Vergleiche der drei Modelle zum gleichen Thema. Wie das fertige Produkt von deepSeek ist und wie oft es später überarbeitet wird, muss noch mit GPT und Claude unter denselben Anforderungen verglichen werden.
03 Nach dem Herunterfahren des Ganges ging es eine Minute schneller und es gab drei weitere Ausfälle
Was passiert, wenn die hohe Inferenzeinstellung sehr lange dauert? Ibragim hat es auch getestet.
Nachdem in Pi die neue Version von DeepSeek auf die niedrige Einstellung eingestellt wurde, wird die durchschnittliche Zeit pro Element von 2 Minuten und 38 Sekunden auf 1 Minute und 31 Sekunden verkürzt und die Kosten werden von 0,045 US-Dollar auf 0,0257 US-Dollar gesenkt. Allerdings scheiterten 3 von 30 Läufen.
Alle auf hohem Niveau erzielten Pässe können nicht intakt gehalten werden.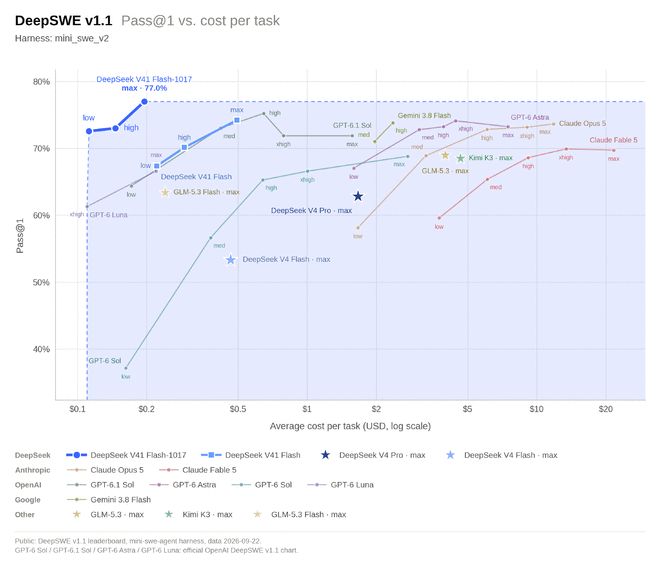
Auf diesem niedrigen Niveau wechselte ich zu DeepSeeks eigenem Harness, und die Ergebnisse änderten sich erneut: Es bestand 29 Mal in 30 Läufen, zwei mehr als Pi. Den Aufzeichnungen von Ibragim zufolge half die offizielle Toolumgebung dem Modell, eine Randbedingung zu bewältigen, die in Pi fehlte.
Die beiden Werkzeugsätze funktionieren bei Modellen unterschiedlich. DeepSeek Harness stellt direkt Tools zum Lesen und Bearbeiten von Dateien bereit, während Pi hauptsächlich die Bedienung des Modells über die Befehlszeile ermöglicht; Die Systemaufforderungswörter des ersteren sind ebenfalls länger. Nachdem dieses Mal die Tools gewechselt wurden, stieg die Token-Nutzung um etwa 75 %, und die durchschnittlich aufgewendete Zeit erhöhte sich von 1 Minute und 31 Sekunden auf 1 Minute und 53 Sekunden. In beiden Werkzeugsätzen können nur 9 Aufgaben dreimal hintereinander bearbeitet werden.
Wenn Sie bei demselben Modell die Inferenzausrüstung und den Werkzeugsatz ändern, ändern sich Geschwindigkeit, Kosten und Erfolg.
Sie sehen nur die von anderen geposteten Ergebnisse, müssen aber auch wissen, welche Einstellungen sie verwendet haben.DeepSeek erwähnte bei seiner Veröffentlichung auch deutlich, dass es über optimierte Tools wie DeepSeek Harness, Tencent CodeBuddy und WorkBuddy verfügt, und empfahl Harness-Benutzern ein Upgrade auf v0.2.1-rc.1 oder höher.
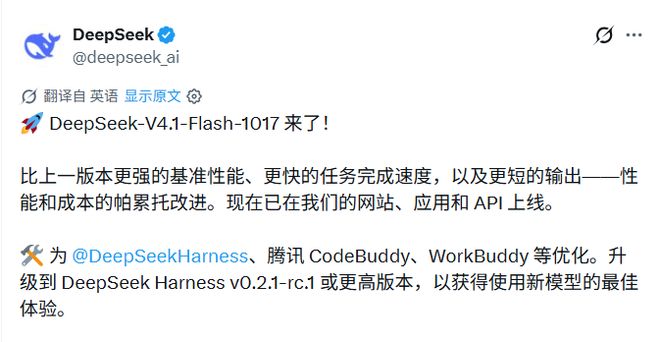
Dieses Update wurde für Webseiten, Apps und APIs eingeführt. API-Aufrufe verwenden weiterhin Deepseek-Flash und der Preis bleibt unverändert; Die neuen Modellgewichte wurden ebenfalls im Rahmen des MIT-Protokolls veröffentlicht.
Der vorherige Programmiertest wurde jedoch abgeschlossen, indem das Modell mit einem Tool verbunden wurde, das Dateien lesen, Code ändern und Prüfungen durchführen kann. Ihn zu bitten, einen Code in das Chat-Fenster zu schreiben, ist etwas anderes, als ihn zu bitten, ein Projekt zu übernehmen. Die Nutzungsumgebung ist unterschiedlich.
04Für den gleichen Fragenkomplex können GPT und Claude günstiger sein
Opus und Astra sind die Flaggschiffe der beiden Unternehmen, auch OpenAI und Anthropic haben günstigere Modelle.
In der gleichen Reihe von Ibragim-Tests haben GPT-6 Lunas xhigh-Gear und Haiku 5.5's high-Gear jeweils 30 Mal bestanden. Die durchschnittlichen Kosten für jeden Artikel betrugen nur 0,0145 US-Dollar bzw. 0,0208 US-Dollar, was niedriger ist als bei DeepSeek.
Der durchschnittliche Zeitverbrauch der beiden beträgt 2 Minuten und 46 Sekunden bzw. 2 Minuten und 08 Sekunden.Dadurch besteht die Wahl nicht mehr nur zwischen „teurem GPT, Claude“ oder „billigem DeepSeek“. Wer bereits Luna oder Haiku für die Erledigung kleinerer Aufgaben nutzt, kann durch den Umstieg auf Flash möglicherweise kein weiteres Geld sparen.
Schwierigere Aufgaben verändern die Frage, wie lange man warten muss, hin zu der Frage, ob man den Ergebnissen vertrauen kann. Der Er würde die Änderungen von einem anderen Modell überprüfen lassen, anstatt DeepSeek seine eigene Lösung genehmigen zu lassen. Dies ist seine Wahl der Verwendung, kein Test zu derselben Frage, um zu beweisen, dass GPT oder Claude zuverlässiger sind.
Der derzeit solideste Fortschritt besteht daher darin, dass die neue Version von DeepSeek in einer Reihe wirklich kleiner Programmieraufgaben die gleichen Inspektionsergebnisse wie das Flaggschiffmodell geliefert hat.
Wie viele manuelle Korrekturen bei großen Projekten erforderlich sind und ob Probleme behoben werden können, entscheidet darüber, wie weit dieser Ersatz gehen kann.
Zwischen dem Bau eines 3D-Autos und der langfristigen Aufrechterhaltung eines Projekts liegt noch viel Arbeit.Ibragim bereitet sich auch darauf vor, diesen Test schwieriger zu machen. Am Ende des Beitrags sagte er, dass der nächste Schritt darin bestünde, eine Gruppe viel schwierigerer Aufgaben auszuwählen und verschiedene Werkzeuge und Modelle zu vergleichen.
Kommentare