Zusammenfassung:
Am 9. November Ortszeit veröffentlichte Anthropic Claude Fable 5.2 und Claude Mythos 5.2. Beiden liegt das gleiche zugrunde liegende Modell zugrunde. Fable steht allen Benutzern zur Verfügung und verfügt über integrierte Schutzmaßnahmen für Cybersicherheit und Biosicherheit. Mythos hebt diese Einschränkungen auf und steht nur Institutionen offen, die das Cyber- oder Life-Sciences-Verifizierungsprogramm bestehen.
Nach der Veröffentlichung waren die Beschreibungen aller fast gleich: stärker und schneller. Manche Entwickler haben auch das Gefühl, dass die Preisgestaltung auf den ersten Blick falsch ist. Für die Codierung ist Fable 5.2 nicht kosteneffektiv. Anthropic selbst sagte jedoch in der Release-Dokumentation, dass für die meisten Codierungs- und Wissensarbeiten empfohlen wird, dass jeder „mit Claude Opus 5.5 beginnt“.
Die leistungsstärksten Modelle der Geschichte werden ständig aktualisiert, aber es bleibt nicht mehr viel Zeit, sie zu nutzen. Bevor sie AGI erreichen, stoßen KI-Unternehmen zunächst an die Grenze der Kommerzialisierung.
Der Stärkste wird immer stärker. Ist der Prototyp der digitalen Belegschaft entstanden?
Lassen Sie uns zunächst darüber sprechen, was das Besondere daran ist. FrontierCode 2.0 testet, „ob Open-Source-Projektbetreuer bereit sind, von Modellen geschriebenen Code zusammenzuführen.“ Auf der höchsten Rechenleistungsstufe erreichte Fable 5.2 49,1 %, während die Vorgängergeneration Fable 5.1 32,4 % erreichte.
Der Remote Labor Index, der misst, wie viele reale Fernarbeitsaufgaben ein Model selbstständig erledigen kann, hat sich von 17,9 % auf 41,3 % mehr als verdoppelt.
Anthropic verfügt außerdem über einen internen Robotersimulationstest, RoboDojo Sim, dessen Punktzahl sich von 27,6 % auf 64,9 % verbesserte. Allerdings stammt diese Zahl aus den internen Abläufen des Unternehmens und kann von der Außenwelt nicht reproduziert werden.
Dann ist da noch der Schwachpunkt. Auch in der offiziellen Vergleichstabelle in AutomationBench verlor Fable 5.2 mit 51,4 % gegen Google Gemini 4 Carbon mit 53,9 %.
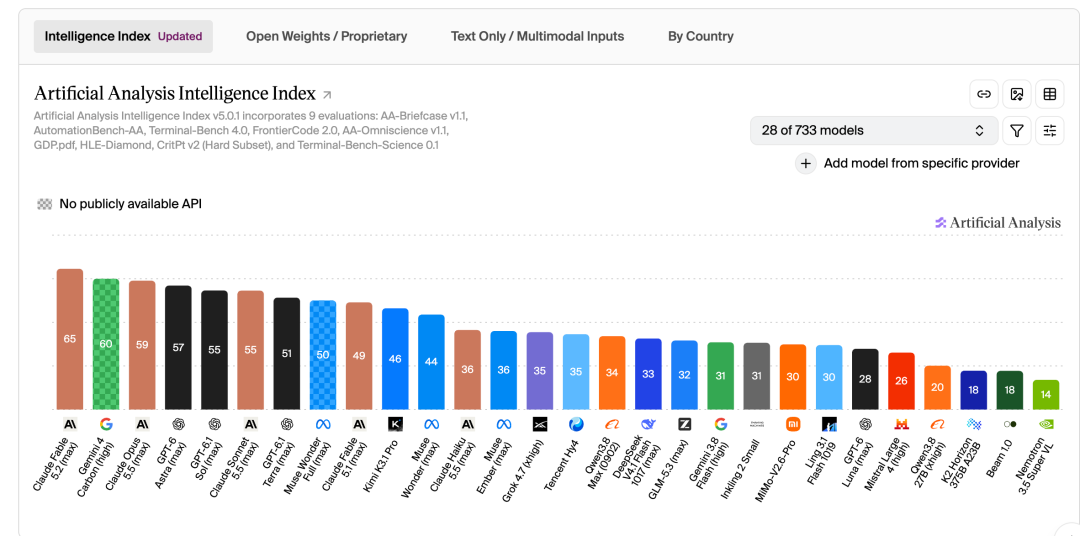
Auf der Smart List der externen Plattform Artificial Analysis führte Fable 5.2 die Liste mit 65 Punkten an und übertraf damit Gemini 4 Carbon auf dem zweiten Platz mit 60 Punkten bei weitem und 9 Punkte hinter GPT-6 astra auf dem vierten Platz.
Wie stark ist es? In mehr als einem Tag wurde eine große Leistung in der Geschichte der menschlichen Mathematik direkt vollbracht.
Innerhalb von 30 Stunden war die formale Verifizierung von Fermats letztem Satz abgeschlossen; Darüber hinaus wurden auch zwei ungelöste Probleme der Physik im Zusammenhang mit Schwarzen Löchern und der Quantengravitation gelöst. Es kann auch ein Betriebssystem völlig unabhängig betreiben, elektronische Geräte unabhängig entwerfen und herstellen und die Kapsidstruktur komplexer Adeno-assoziierter Viren vorhersagen...
Einige Leute glauben, dass Fable 5.2 bedeutet, dass sich KI von einem Produktivitätstool zu einer digitalen Belegschaft mit technischen Ausführungsfunktionen entwickelt.
Viele Entwicklergruppen glauben jedoch, dass dies bedeuten könnte, dass Anthropic in der Codierungsrichtung „sein Ende erreicht“ hat. Wenn nicht einige neue Wege und neue Modelle entwickelt werden, wird es schwierig sein, die Wahrnehmung der Anleger zu stimulieren. Und jetzt fällt es mit der kritischen Phase für Anthropic zusammen, um in Richtung IPO-Preis zu sprinten.
Der Preis liegt weit im Voraus, daher empfiehlt Anthropic, es nicht zu verwenden
Als viele Entwickler jedoch begeistert waren, die Funktionen von Fable 5.2 auszuprobieren, stellten sie fest, dass mit der Preisgestaltung etwas nicht stimmte.
Der Standardpreis von Fable 5.2 beträgt 8 US-Dollar für die Eingabe und 40 US-Dollar für die Ausgabe pro Million Token, was einem Rückgang von 20 % gegenüber den 10 und 50 US-Dollar der vorherigen Generation entspricht, und die Ausgabegeschwindigkeit ist bis zu 30 % schneller als bei 5.1. Wenn es zu langsam ist, können Sie den Schnellmodus aktivieren, der die Geschwindigkeit um das 2,5-fache erhöht und den Preis verdoppelt. Der Input beträgt 16 $ und der Output 80 $.
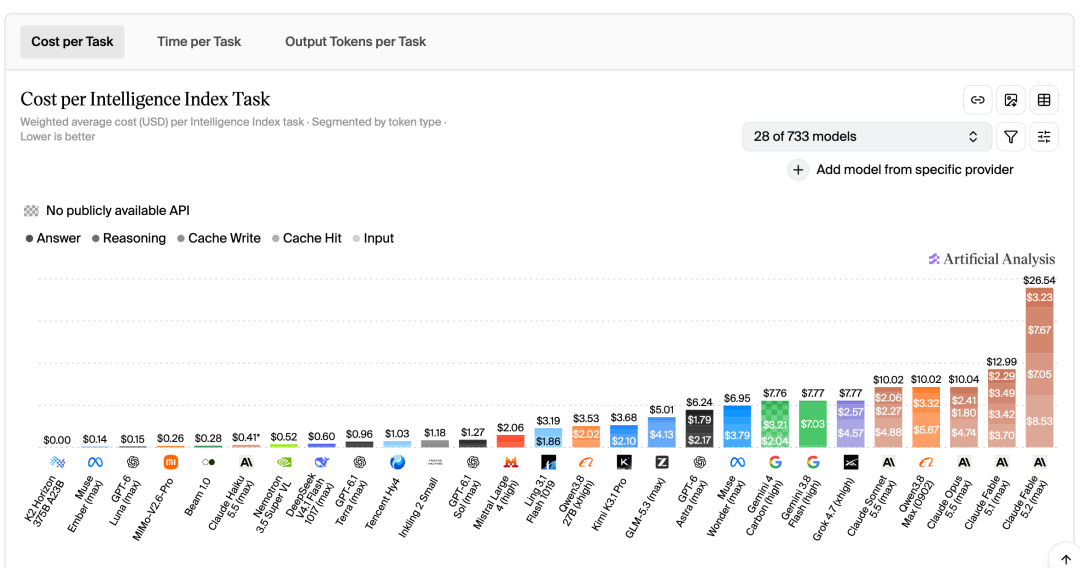
Intuitiv liegen die Kosten pro Aufgabe bei der künstlichen Analyse ebenfalls weit vorne.
Anthropic selbst hat jedoch in den Veröffentlichungsmaterialien eine Kurve „Codegenauigkeit vs. Kosten pro Aufgabe“ angegeben und kam zu dem Schluss, dass Fable 5.2 mit 45,3 % bei mittlerer Rechenleistung bereits nahe an Opus 5.5s Höchstwert von 45,5 % liegt und die Kosten für die Erledigung einer Aufgabe nur etwa die Hälfte betragen.
Derzeit haben Anthropic-Beamte den Maßstab für die Messung intelligenten Konsums geändert. In den letzten zwei Jahren basierte der Branchenpreisvergleich darauf, wie viel es pro Million Token kostete. Diesmal wurde es durch die Kosten pro erledigter Aufgabe ersetzt. Die von zwei Linealen gemessenen Ergebnisse können völlig gegensätzlich sein. Ein Modell, dessen Token-Stückpreis um 20 % günstiger ist, kann doppelt so viel kosten, wenn es drei weitere Runden braucht, um es richtig zu machen.
Darüber hinaus lautet die offizielle Empfehlung von Anthropic: „Für die meisten Programmier- und Wissensarbeiten empfehlen wir Benutzern, mit Claude Opus 5.5 zu beginnen.“
Im Vergleich zur aktuellen Preisstufe kostet DeepSeek V4.1-Flash 0,3 US-Dollar pro Million Input und 1,2 US-Dollar pro Million Output, Kimi K3.1 Pro kostet 2 US-Dollar pro Million Input und 10 US-Dollar Output und die GPT-5.5-Standardversion kostet 5 US-Dollar und 30 US-Dollar. Der Fable 5.2 steht an der Spitze, 8 $ und 40 $.
Mit anderen Worten: Dieses Modell ist jedes Mal, wenn es geöffnet wird, sehr teuer. Sein Wert liegt darin, es nur einmal in einem kritischen Moment zu öffnen, nicht jeden Tag.
Anthropic hat ihr diesbezüglich zwei neue Rollen zugewiesen. Einer ist Berater. Billigmodelle wie Haiku, Sonnet und Opus fragen danach, wenn sie auf Probleme stoßen. Der andere ist Orchestrator, ein Planer. Es erledigt dies nicht persönlich, sondern teilt die Aufgaben auf und weist sie kleineren Modellen zu.
Stronger than the Strongest wird immer noch aktualisiert, ist aber nicht mehr das Wichtigste
Anthropic sagte, ein Ingenieur habe Fable 5.2 einen leeren Ordner gegeben, der mehr als 1.000 Subagenten koordinierte und 8 Tage lang ununterbrochen lief, und schließlich einen Prototyp eines Betriebssystems übergeben, das auf einem Laptop gebootet werden konnte, mit eigenem Kernel, Festplatte, Tastatur und Netzwerktreiber, Dateispeicher, Fenster, Anmeldeschnittstelle und Installationsprogramm.
Eine weitere Gruppe von Agenten migrierte einen der eigenen Produktionsdienste von Anthropic von Python nach Rust, und die Startgeschwindigkeit war nach der Migration etwa 26-mal schneller.
Es hängt sogar mit der Hardware zusammen. Anthropic sagte, es habe mit dem Leiterplattenhersteller Diode zusammengearbeitet, um drei Produkte zu entwickeln – einen Sprachassistenten für zu Hause, einen USB-Konferenzlautsprecher und ein tragbares elektronisches Haustier, einschließlich Leiterplatten, Gehäusen und Software. Die Platinen können nach dem Bau ohne elektrische Änderungen betrieben werden.
Das mathematische Beispiel ist dieses. Ungefähr 1.000 Agenten haben weniger als 30 Stunden damit verbracht, den vorhandenen Beweis von Fermats letztem Satz in eine Form zu übersetzen, die Lean Schritt für Schritt überprüfen kann. Um dasselbe im September dieses Jahres zu tun, waren 11 Tage, ein spezielles Gerüst und die umfassende Anleitung der Forscher erforderlich. Diesmal wurde nur ein Drittel des Ausgabe-Tokens verwendet, und die Beweislänge betrug etwa ein Siebtel der ursprünglichen Länge.
Diese Fälle klingen wie Angeber. Wenn Sie jedoch „1000 Unteragenten“ durch „1000 Untergebene“ ersetzen, werden Sie feststellen, dass es sich tatsächlich um eine Organisationsstruktur und nicht um ein Modell handelt.
Ein Brancheninsider glaubt, dass der Wettbewerb um Topmodelle konvergiert ist, also Preiskonvergenz und Datenkonvergenz. Der nächste Schritt ist zweifellos die „Anwendungs“-Phase, in der die Obergrenze der Modellfähigkeiten und die Untergrenze des Preises gleichzeitig durchgeführt werden, was bedeutet, dass KI für verschiedene differenzierte Erkundungen verwendet werden kann. Bis dahin wird es für die Modellhersteller um Dimensionen wie Gurtzeug, Speicher und Benutzergewohnheiten gehen.
An diesem Punkt können wir sehen, dass große Modellhersteller Vorkehrungen treffen. Beispielsweise vervollständigen DeepSeek und OpenAI ebenfalls die gleichen Funktionen.
Im August dieses Jahres hat DeepSeek DeepSeek Harness unter der MIT-Lizenz als Open-Source-Lösung veröffentlicht. Als DeepSeek am 17. Oktober V4.1-Flash-1017 veröffentlichte, wurde deutlich, dass das neue Modell für intelligente Produkte wie DeepSeek Harness, Tencent CodeBuddy und WorkBuddy optimiert war. Und Cui Tianyi vom Geschirrteam rekrutiert in großem Umfang Leute. Ifeng Technology hatte zuvor von Brancheninsidern erfahren, dass Liang Wenfeng selbst besser darin sei: „Das ist auch der Bereich.“
Ebenfalls am 5. November veröffentlichte Kimi gerade Kimi Hosted Agents (gehostete Agenten) und schlug damit offiziell Harness as a Service vor.
Am selben Tag wechselte Cat Wu, die bei Anthropic für Claude Code-Produkte verantwortlich war, zu OpenAI und war für das Produktmanagement des Kernproduktteams verantwortlich. Sie war daran beteiligt, Claude Code von internen Prototypen zu weit verbreiteten kommerziellen Produkten voranzutreiben, und kam dann kurzzeitig zu Cursor.
Claude Code ist eines der repräsentativsten Produkte von Anthropic auf dem KI-Programmiermarkt. Cat Wu verfügt über direkte Erfahrung in seinem Prozess von der Produktkonzeption bis zur Kommerzialisierung. Die Rekrutierung von ihr durch OpenAI bedeutet offensichtlich, die Fähigkeiten von Codex und weiteren Agent-Produkten zu stärken.
Tatsächlich wurde kurz vor der Veröffentlichung von Fable 5.2 das angebliche neue Modell von Gemini „durchgesickert“. Benutzer @chetaslua kommentierte: „Es dauert doppelt so lange und die Codemenge verdoppelt sich.“ Dies ist ein neuer Kontrollpunkt für Gemini 4 mit dem Codenamen „Krypton“ innerhalb von Google. Es wird gesagt, dass die Leistung bei Codegenerierungsvisualisierungen und 3D-Szenen die des neu veröffentlichten Carbons deutlich übertrifft. Daher erhöht sich die Bildwiederholgeschwindigkeit der Topmodelle. Manche Leute denken, dass es am RSI liegt, sonst gibt es keine Möglichkeit, es zu erklären.
Dann kommt die Frage. Wenn Intelligenz kein Problem mehr darstellt, was ist dann Wettbewerbsfähigkeit? Wie wird der nächste Modellwettbewerb ablaufen? Die Antwort wird bald bekannt gegeben.
Kommentare