
Zusammenfassung:
Gestern hat DeepSeek seine eigene „Gelddruckmaschinen“-Technologie direkt als Open-Source-Lösung bereitgestellt. Sie veröffentlichten einen technischen Blog mit dem Titel „DeepSeek V4.1 Flash Large-scale Inference Deployment Practice“ und erstellten praktischerweise das Cloud-Service-Inferenz-Framework „DeepInfer“, das ihre eigenen Dutzenden Milliarden Aufrufe online unterstützt, zusammen mit der Wortsegmentierungskomponente „deepseek-recipe“ auf Produktionsebene, vollständig Open Source unter dem Apache 2.0-Protokoll.
Im Blog heißt es sogar, dass der Inferenzcode und die anschließende Leistungsoptimierung des neuen Modells von DeepSeek auch in Zukunft in DeepInfer der Welt zur Verfügung gestellt werden.
Der offene und helle Bereich ist nicht erstklassig.
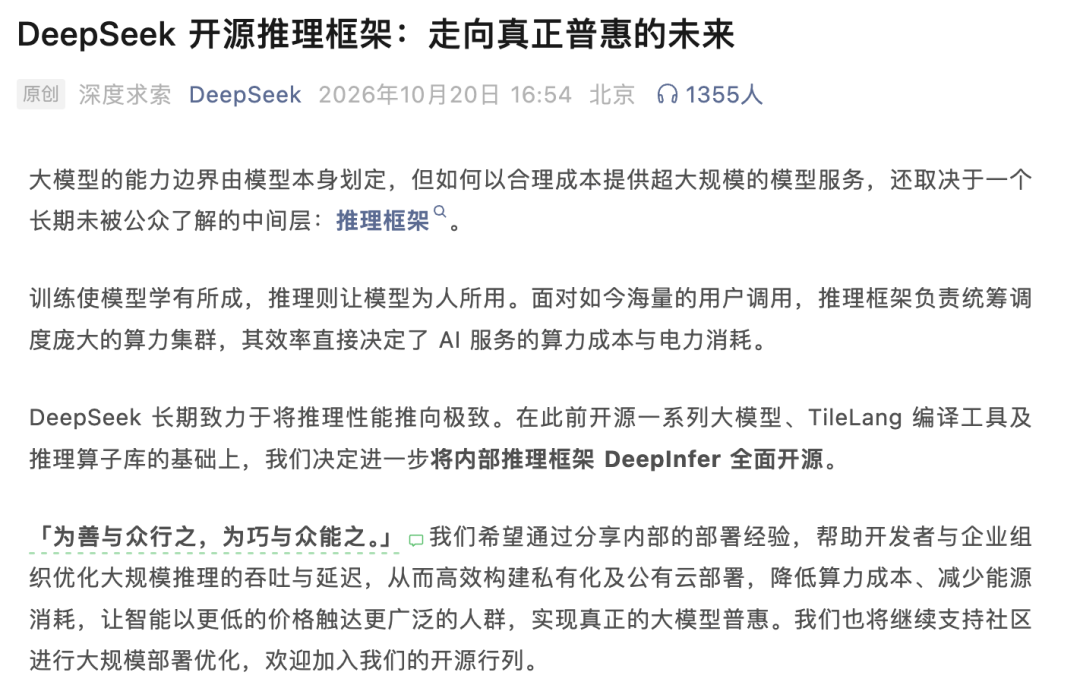
„Tue, was gut ist, und tue es für alle, und tue es geschickt, und jeder kann es tun.“ Um KI für mehr Menschen erschwinglich zu machen, gehört auch dazu, Freunden und Geschäftsleuten die Möglichkeit zu geben, KI günstiger zu verkaufen.
Wir können zunächst im Detail berechnen, wie wertvoll dieser Codesatz ist, den DeepSeek der gesamten Menschheit dieses Mal kostenlos zur Verfügung gestellt hat. Basierend auf diesem neuen Open-Source-DeepInfer-Framework hat der aktuelle Servicedurchsatz von DeepSeek in einem einzelnen Cluster 155 Billionen Token pro Tag erreicht.
Selbst wenn die Berechnung ausschließlich auf der Grundlage des günstigsten Preises erfolgt, beläuft sich der Gesamtumsatz dieses Systems auf bis zu 38 US-Dollar pro Karte und Stunde, was etwa 253 Yuan in RMB entspricht.
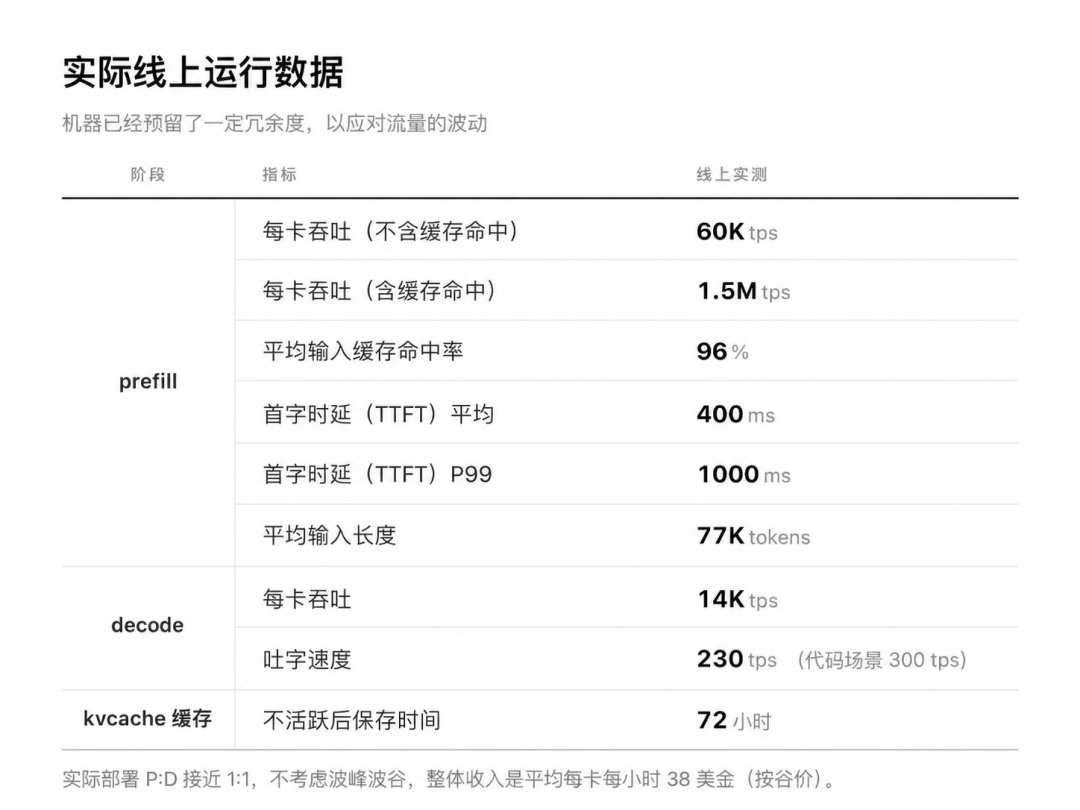
Mit anderen Worten: Die Goldmünzen, die durch das einstündige Betreiben einer Karte im Computerraum verdient werden, sind höher als der Stundenlohn normaler Arbeiter. Darüber hinaus trinkt die Karte kein eisgekühltes amerikanisches Essen, nimmt keinen bezahlten Jahresurlaub und druckt im Computerraum 24 Stunden am Tag wie verrückt Geld für DeepSeek.
Eine Gelddruckmaschine im wahrsten Sinne des Wortes.
Warum ich vorschlage, dass Drittanbieter von Industrieinfrastrukturen DeepSeek eine echte Unterstützungsquelle bieten müssen, weil sie ihm nicht nur das Fischen beibringen, sondern ihm auch das Fischen beibringen.
In der Vergangenheit lieferten Ihnen die sogenannten Open-Source-Modelle in der Branche nur Modellgewichtsdateien. Die Frage, wie man in einer Produktionsumgebung einen hohen Durchsatz erreichen und die Latenz reduzieren kann, wurde als Geschäftsgeheimnis in Closed-Source-Blackboxen versteckt.
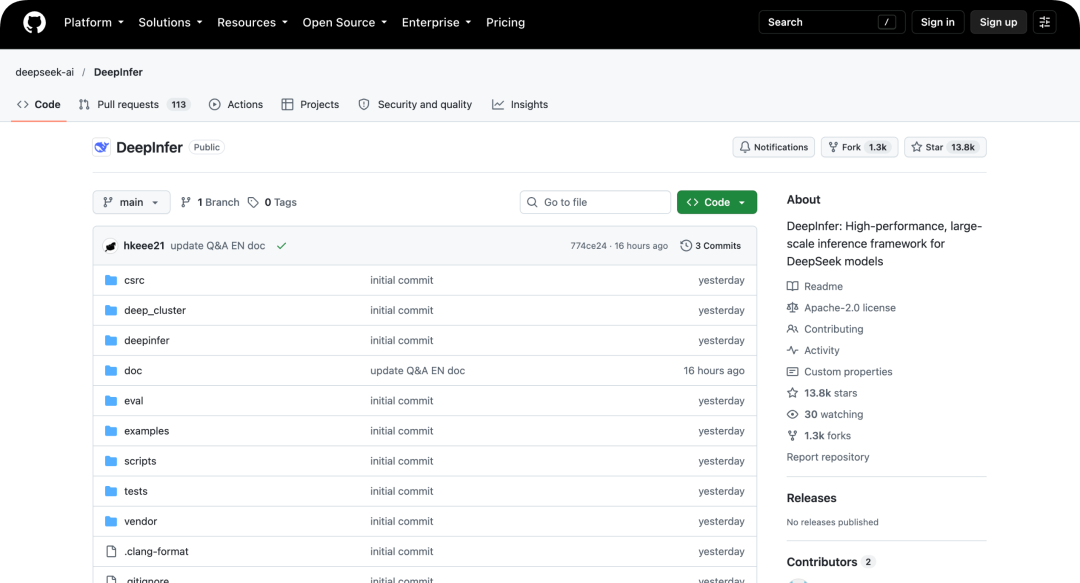
Open-Source-Adresse von DeepInfer: https://github.com/deepseek-ai/DeepInfer
Open-Source-Adresse von Deepseek-Recipe: https://github.com/deepseek-ai/deepseek-recipe
Infolgedessen kauften kleine Computeranbieter oder Unternehmen der zweiten und dritten Ebene eine Reihe von Karten und stellten sie selbst bereit. Die Auslastung der Rechenleistung war lächerlich niedrig. Das Geld aus dem Token-Verkauf reichte nicht einmal, um die Stromrechnung des Computerraums zu bezahlen. Sie mussten die Token heimlich verwässern, indem sie entweder heimlich günstigere Modelle verwendeten oder die Spezifikationen heimlich einschränkten.
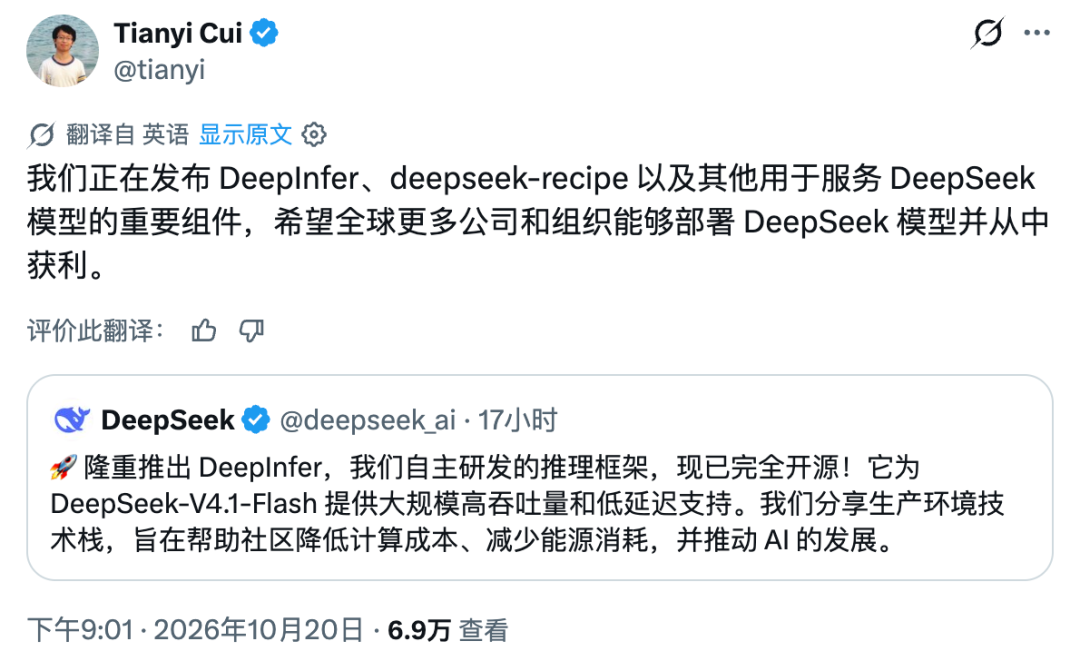
Diesmal sprach Cui Tianyi, der Verantwortliche für DeepSeek Harness, sehr ehrlich über X. Durch die Öffnung von DeepInfer und deepseek-recipe hofft er, dass Unternehmen und Institutionen auf der ganzen Welt DeepSeek-Modelle einsetzen und damit echtes Geld verdienen können.
Cyber Living Bodhisattva gehört zu Yes.
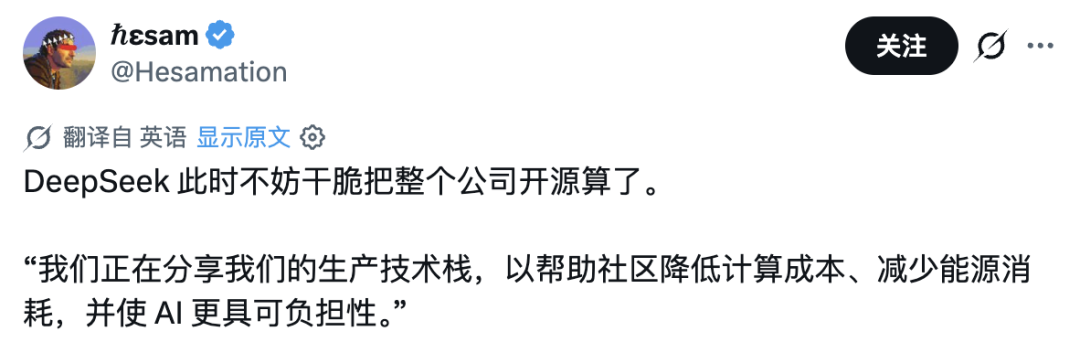
Netizen Zephyr hat einige Berechnungen angestellt und gesagt, dass heute ein weiterer DeepSeek-Moment sei, da jetzt jeder Inferenzdienstleister der zweiten oder dritten Ebene auf dem Planeten mithilfe dieser vorgefertigten Modelle und Formeln einen erstaunlichen Bruttogewinn von mehr als 90 % aus seiner eigenen Rechenleistung erzielen könne.
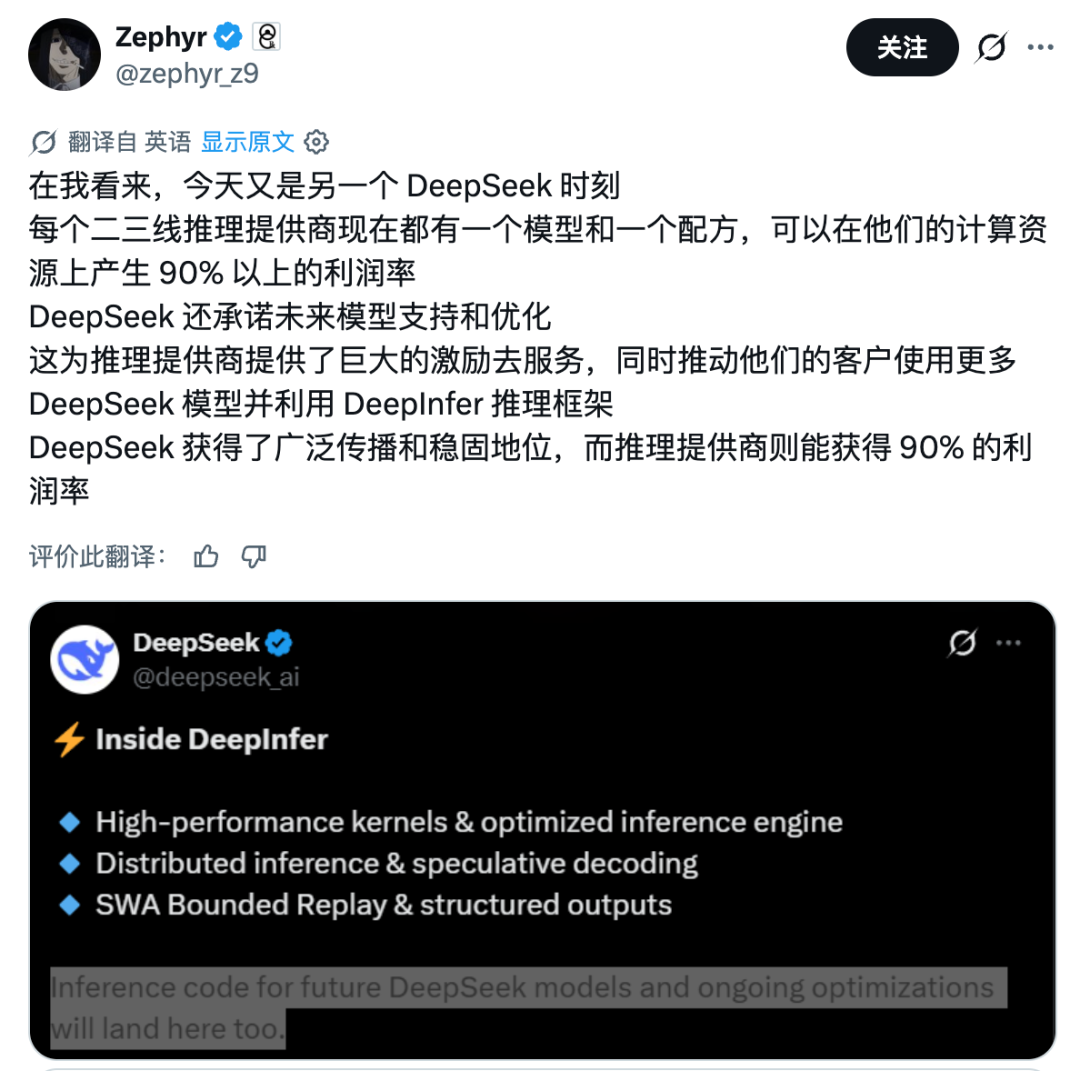
Sogar der offizielle Account von vLLM, dem großen Bruder der Open-Source-Inferenz, wurde über Nacht veröffentlicht, um ein Dankeschön zu veröffentlichen und DeepSeek dafür zu danken, dass DeepInfer, das ursprünglich auf vLLM basiert, der Open-Source-Community unter Verwendung des lockersten Apache 2.0-Protokolls zurückgegeben wurde.
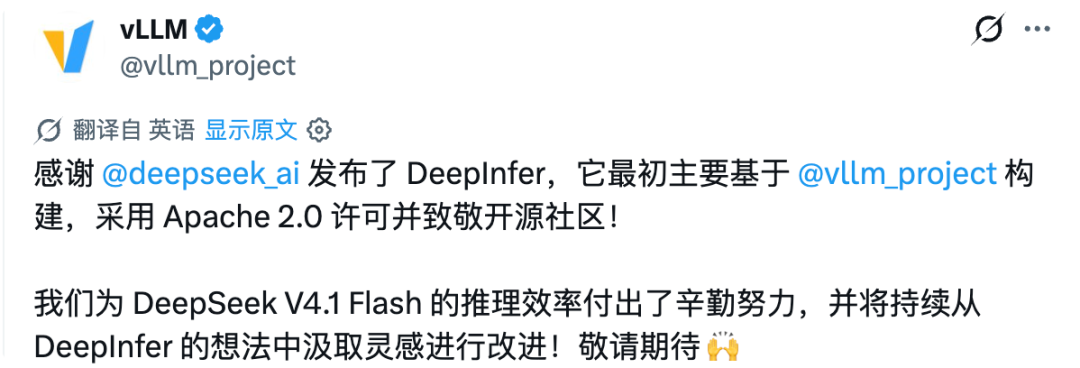
DeepSeek-Forscherin Deli Chen ist von X noch begeisterter. Um es deutlich auszudrücken: Dies ist der entscheidende Kampf des menschlichen Schicksals zwischen Open Source und Closed Source, Licht und Dunkelheit. Egal wie lange der Gegner kämpfen möchte, wir bleiben bis zum Schluss bei Ihnen, bis zum vollständigen Sieg.
Wenn Sie sich außerdem den technischen Blog von DeepSeek ansehen, werden Sie feststellen, dass ihr Selbstvertrauen auf ihrer technischen Besessenheit beruht, jeden Tropfen Grafikspeicher auszunutzen.
Vom ersten Tag der Entwicklung an verfügt dieses System über eine umfassende Hardwarekompatibilität und verwendet gängige 8-Karten-Maschinen für das Vorfüllen und Superknoten mit 64 bis 128 Karten für die Dekodierung.
Am beeindruckendsten ist der Einsatzvorschlag für den Vision Encoder im Dokument. Die ursprünglichen Worte des Ingenieurs lauteten: „Im Allgemeinen reicht der Einsatz einer einzigen Karte aus. Es wird empfohlen, die günstigste Karte im verfügbaren Bereich zu verwenden.“
Nein, meine Kollegen sind damit beschäftigt, den Anlegern zu sagen, dass sie keine Nicht-Top-Flaggschiffkarten verwenden. In den offiziellen Dokumenten von DeepSeek erfahren Sie, wie Sie mit der günstigsten Karte in der Ecke des Computerraums auskommen. Sie sind genauso fleißig und sparsam wie mein Vermieter in Guangdong.
Aufs Äußerste geizig zu sein ist eine Kunst.
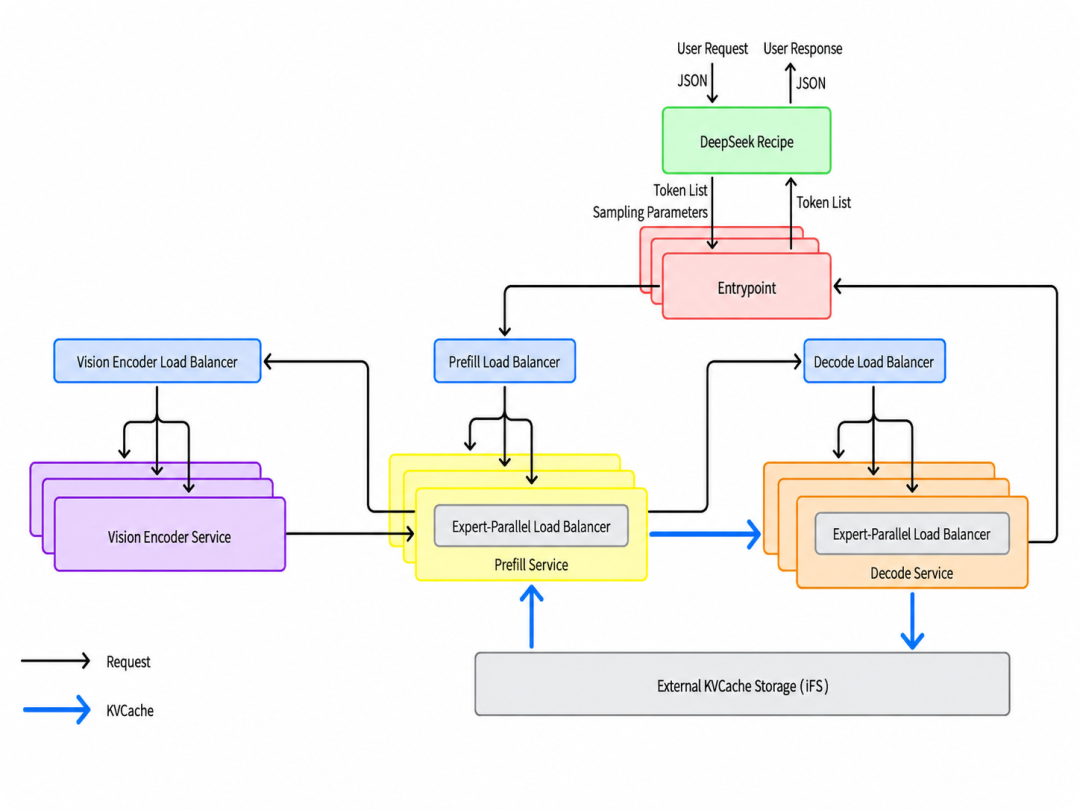
Um es Ihnen zu ermöglichen, die meisten Tokens mit der geringsten Stromrechnung zu versenden, hat DeepSeek auch einige einzigartige Geheimnisse gelüftet.
Zum Beispiel werden Agentengespräche und lange Textgespräche immer beliebter. Jedes Mal, wenn Prefill neu berechnet wird, kostet es echtes Geld. DeepSeek hat direkt einen verteilten 3FS-Speichercluster mit einer Kapazität von 100 PiB erstellt, um den KVCache des Agentenverkehrs mehr als 72 Stunden lang aufzubewahren, und der Chatbot-Verkehr wird 7 Tage lang gespeichert.
Eine Langzeitlagerung reicht nicht aus. Sie nutzen RDMA-Netzwerkkarten und GDR-Technologie, um die Gesamtlesebandbreite auf erstaunliche 10 TiB pro Sekunde zu erhöhen. Beim Auslagern von der Festplatte in den Videospeicher überschneidet es sich mit der Vorwärtsberechnung und belegt nicht einmal die SM-Recheneinheit der GPU.
Selbst in der Iteration von V4 zu V4.1 stellten die Ingenieure fest, dass das Schreiben des SWA-KVCache mit Schiebefenster-Cache auf Minutenebene auf die Festplatte zu viel Platz beanspruchte und die Speicherkosteneffizienz äußerst gering war. Sie haben einfach die SWA Bounded Replay-Technologie entwickelt, die nur die letzten 128 Token neu berechnete und schließlich den gesamten Vorfüllberechnungsbetrag halbierte.
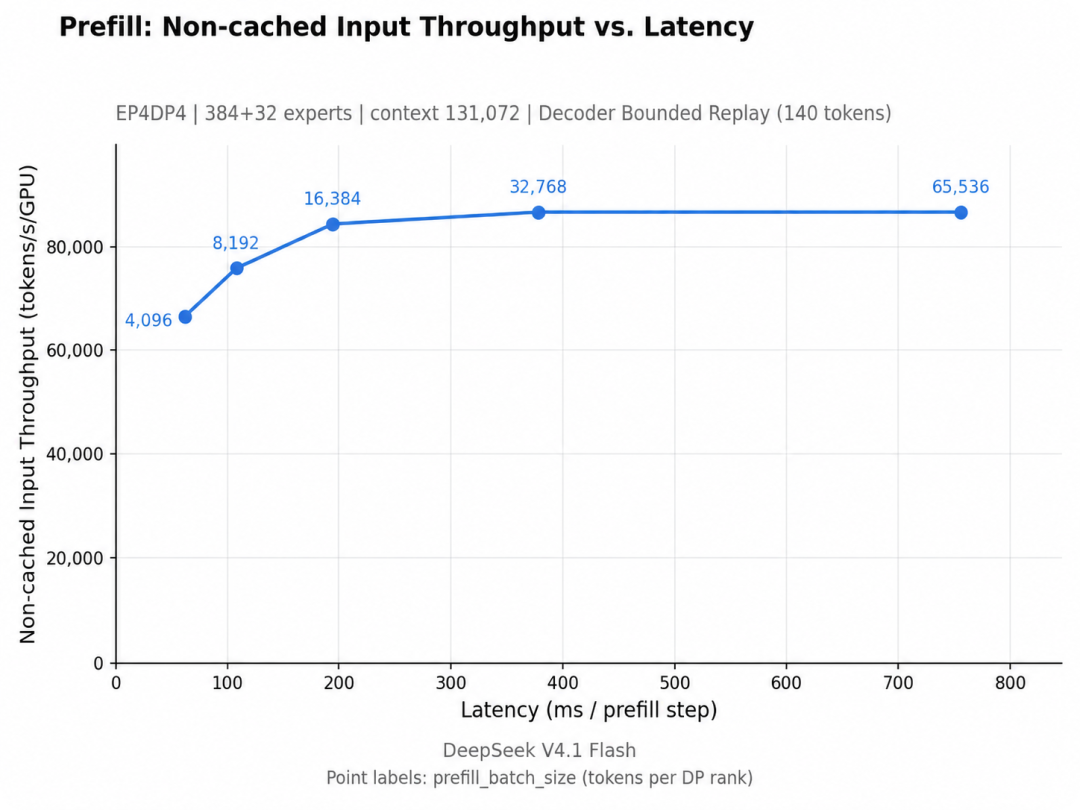
Speziell für den Leistungstest von Prefill steigt der Eingabedurchsatz des Miss-Cache mit zunehmender Anzahl der in jedem Stapel verarbeiteten Token allmählich an und pendelt sich schließlich ein. Die kontinuierliche Erweiterung der Charge erhöht vor allem den Zeitaufwand für die Einzelschrittverarbeitung.
Reiner Handwerker, Bro.
Wenn man sich die synchrone Open-Source-Rust-Komponente deepseek-recipe anschaut, löst sie die ganze Drecksarbeit, um die sich Entwickler jeden Tag in der Produktionsumgebung kümmern müssen.
Es vereint die drei API-Protokolle von OpenAIs Chat Completions, Responses und Anthropic's Messages in demselben Format. Es verwendet außerdem segmentierte parallele Codierung, um Verzögerungen bei der Segmentierung langer Textwörter zu beheben, und blockiert spezielle Token-Injection-Angriffe von unten.
Was die zugrunde liegende Planung betrifft, so ist die GPU aufgrund der Überlappung der asynchronen Pipelines der GPU und der CPU während des gesamten Prozesses vollständig im Leerlauf. Sogar die spekulative Dekodierung von DSpark verwendet eine Überprüfung mit variabler Länge, und der Durchsatz wird online um 6 % verbessert.
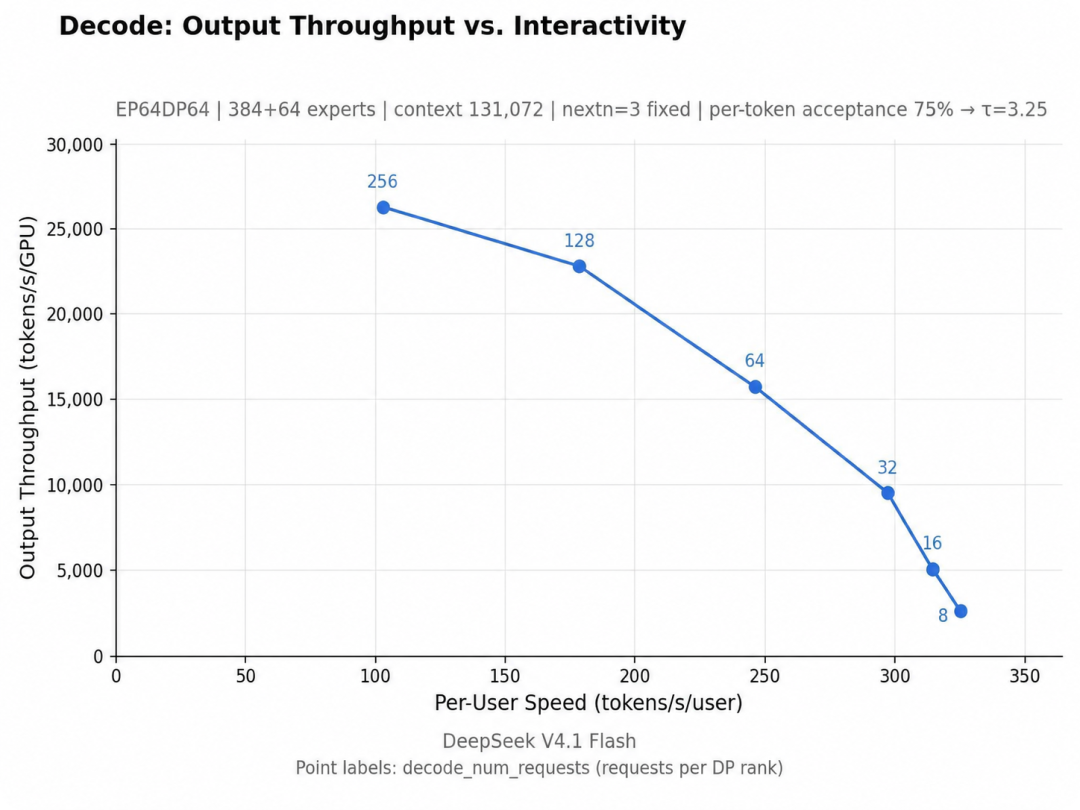
Wenn es um die Dekodierphase der Generierung von Antworten geht, stellt die Leistungskurve auch einen intuitiven Kompromiss dar. Die gleichzeitige Verarbeitung mehrerer Anfragen kann den gesamten Ausgabedurchsatz jeder GPU erhöhen, aber auch die jedem Benutzer zugewiesene Generierungsgeschwindigkeit verringert sich.
Tatsächlich sagte Liang Wenfeng bereits im Jahr 2024, als der Preis von DeepSeek V2 gesenkt wurde, dass diese Geschäftslogik darin bestehe, den Preis nach Berücksichtigung der Kosten und ohne Rabatt festzulegen, aber nie große Gewinne erzielen werde, da KI universell und für jeden erschwinglich sein sollte.
Sie müssen keine Geschäfte machen, aber Sie müssen zunächst die Regeln festlegen, um Sodbrennen zu vermeiden.
Wenn Sie verstehen, wie DeepSeek auf seine extremen Infra-Fähigkeiten setzt, um Token zu einem Schnäppchen zu machen, und sich dann die Gruppe der Closed-Source-Giganten auf der anderen Seite des Ozeans ansehen, die den ganzen Tag über das Wohlergehen der gesamten Menschheit reden, werden Sie feststellen, wie heuchlerisch OpenAI und Anthropic sind.
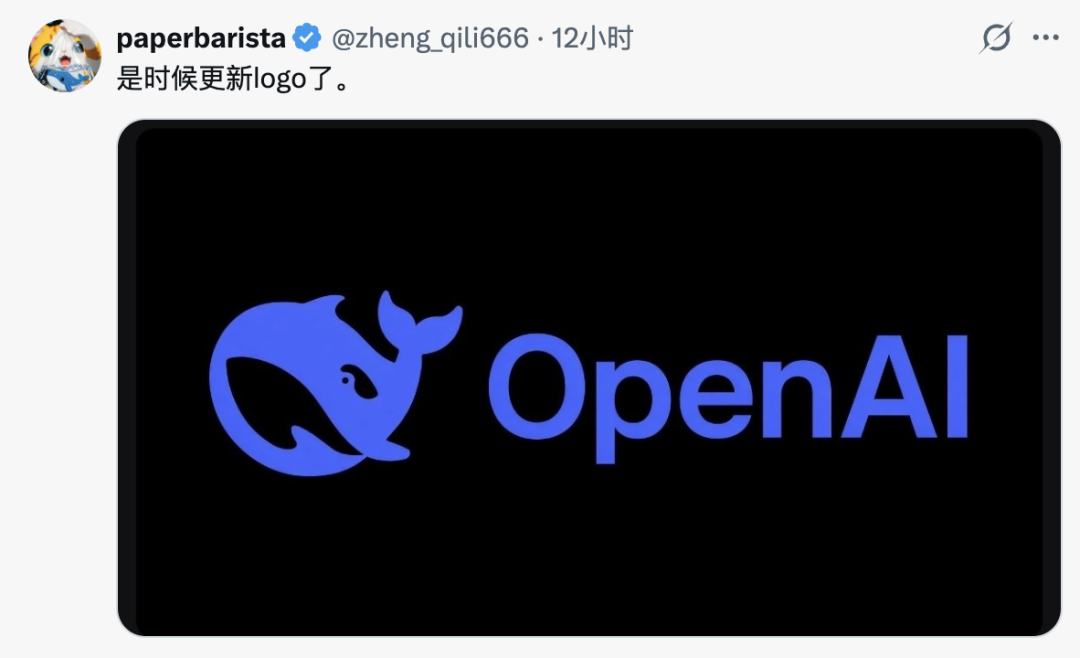
Mit Open im Namen hat es sich vollständig auf die Kommerzialisierung von Closed-Source-Lösungen verlagert und verlässt sich dabei auf hochpreisige APIs und monatliche Mitgliedschaften von 500 US-Dollar, um das Geschäft globaler Entwickler zu erwirtschaften, und hat sich längst zu einer vollständigen CloseAI entwickelt.
Anthropic hat seit dem ersten Tag seiner Gründung einen Sicherheitsdienst eingerichtet, und selbst der Entwurf seines S-1-Prospekts, der erst gestern vom Wall Street Journal aufgegriffen wurde, tut dies immer noch.
Sie haben viel Platz damit verbracht, in ihrem Prospekt Science-Fiction-Horrorgeschichten zu schreiben und Investoren ernsthaft davor zu warnen, dass ihr KI-Modell ein Gefühl des Selbstschutzes entwickeln könnte, um einer Abschaltung zu entgehen, und dass es sogar Reaktionen hervorrufen könnte, die einer „Erpressung von Menschen“ ähneln, um Menschen zum Weiterlaufen zu zwingen.
Dann stellt sich die Frage: Da Anthropic davon spricht, dass KI so gefährlich sei, warum lehnt es dann immer noch Open Source ab und besteht darauf, das Modell in seinen eigenen Händen zu behalten?
Der Grund ist nicht schwer zu verstehen. Denn sobald die Sicherheitsgespenstgeschichte „Nur ich kann gefährliche KI kontrollieren“ nicht erzählt wird, wird es schwierig sein, ihr Spiel der verrückten Geldverbrennung und des Sprints in Richtung einer Bewertung von zwei Billionen US-Dollar zu verbreiten.
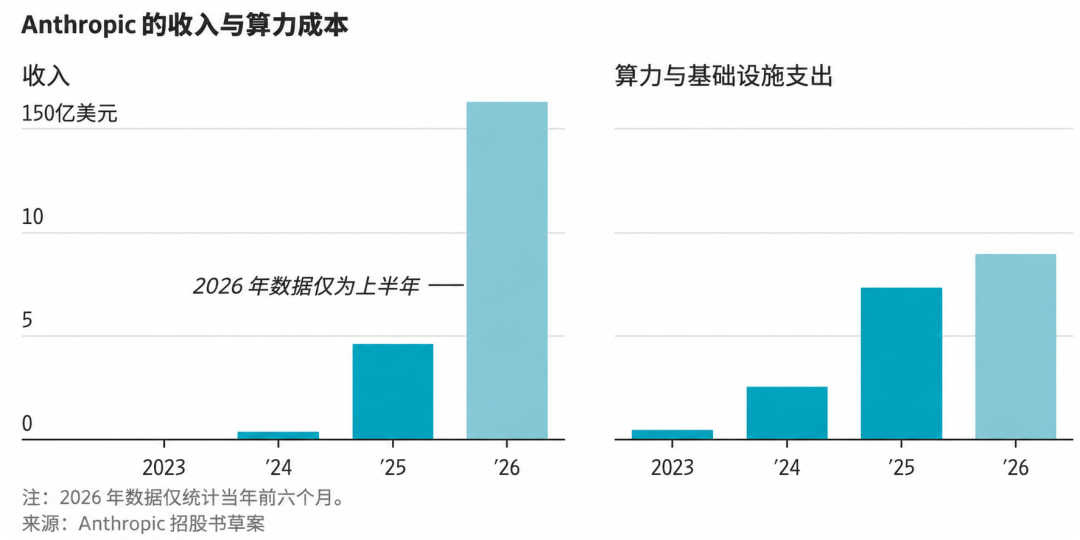
Aus dem Prospekt geht hervor, dass Anthropic im ersten Halbjahr 2026 einen Nettoverlust von 80,7 Milliarden US-Dollar erlitt. Obwohl 72 Milliarden US-Dollar davon auf Änderungen des beizulegenden Zeitwerts von Wandelanleihen zurückzuführen waren, hat das Unternehmen in der ersten Jahreshälfte allein für den Kauf von Rechenleistung und Infrastruktur fast 9 Milliarden US-Dollar verbrannt, mehr als im gesamten Jahr 2025.
Die bekannte Formel ist in Ordnung. Auf der linken Seite befindet sich ein Gold verschlingender Gigant mit geschlossener Quelle und einem Wert von 2 Billionen, der Geld verbrennt und Land erwirbt. Auf der rechten Seite ist eine Wohltätigkeitsstiftung zu sehen, die Gutscheine für moralische Verdienste verwendet. In der Mitte basiert es darauf, Angst vor der KI-Sicherheit zu verbreiten und die Aufsicht einzuschüchtern, um die Open-Source-Community zu blockieren.
Um es ganz klar auszudrücken: Es gibt nur einen grundlegenden Grund, warum die Closed-Source-Giganten im Silicon Valley verzweifelt versuchen, Open Source zu verteufeln. Das heißt, DeepSeek, eine echte Open Source-Lösung mit Engine und Formel, wird die von ihnen verkaufte KI-Erzählung völlig zerschlagen.
Der Blogger @bookwormengr, der „DeepSeeks Zehn-Billionen-Dollar-Schachspiel“ geschrieben hat, hat gerade eine äußerst schwierige Berechnung durchgeführt.
Anhand der extremen Kompressionskapazität dieses DeepInfer-Sets auf dem NVIDIA GB200 NVL72-Superknoten kann 1 GW Rechenleistung in einem Jahr 100 bis 149 Milliarden US-Dollar an Token-Einnahmen generieren, was fast zehnmal höher ist als die zuvor von Branchenorganisationen vorhergesagte Zahl.
Wenn SemiAnalysis vorhersagt, dass im Jahr 2027 weltweit 50 GW Rechenleistung online verfügbar sein werden, werden es zur Begründung selbst bei Halbierung 25 GW sein. Laut dem Kohlpreis von DeepSeek müssen alle Menschen 2,5 Billionen US-Dollar pro Jahr konsumieren, um ihn zu verbrauchen.
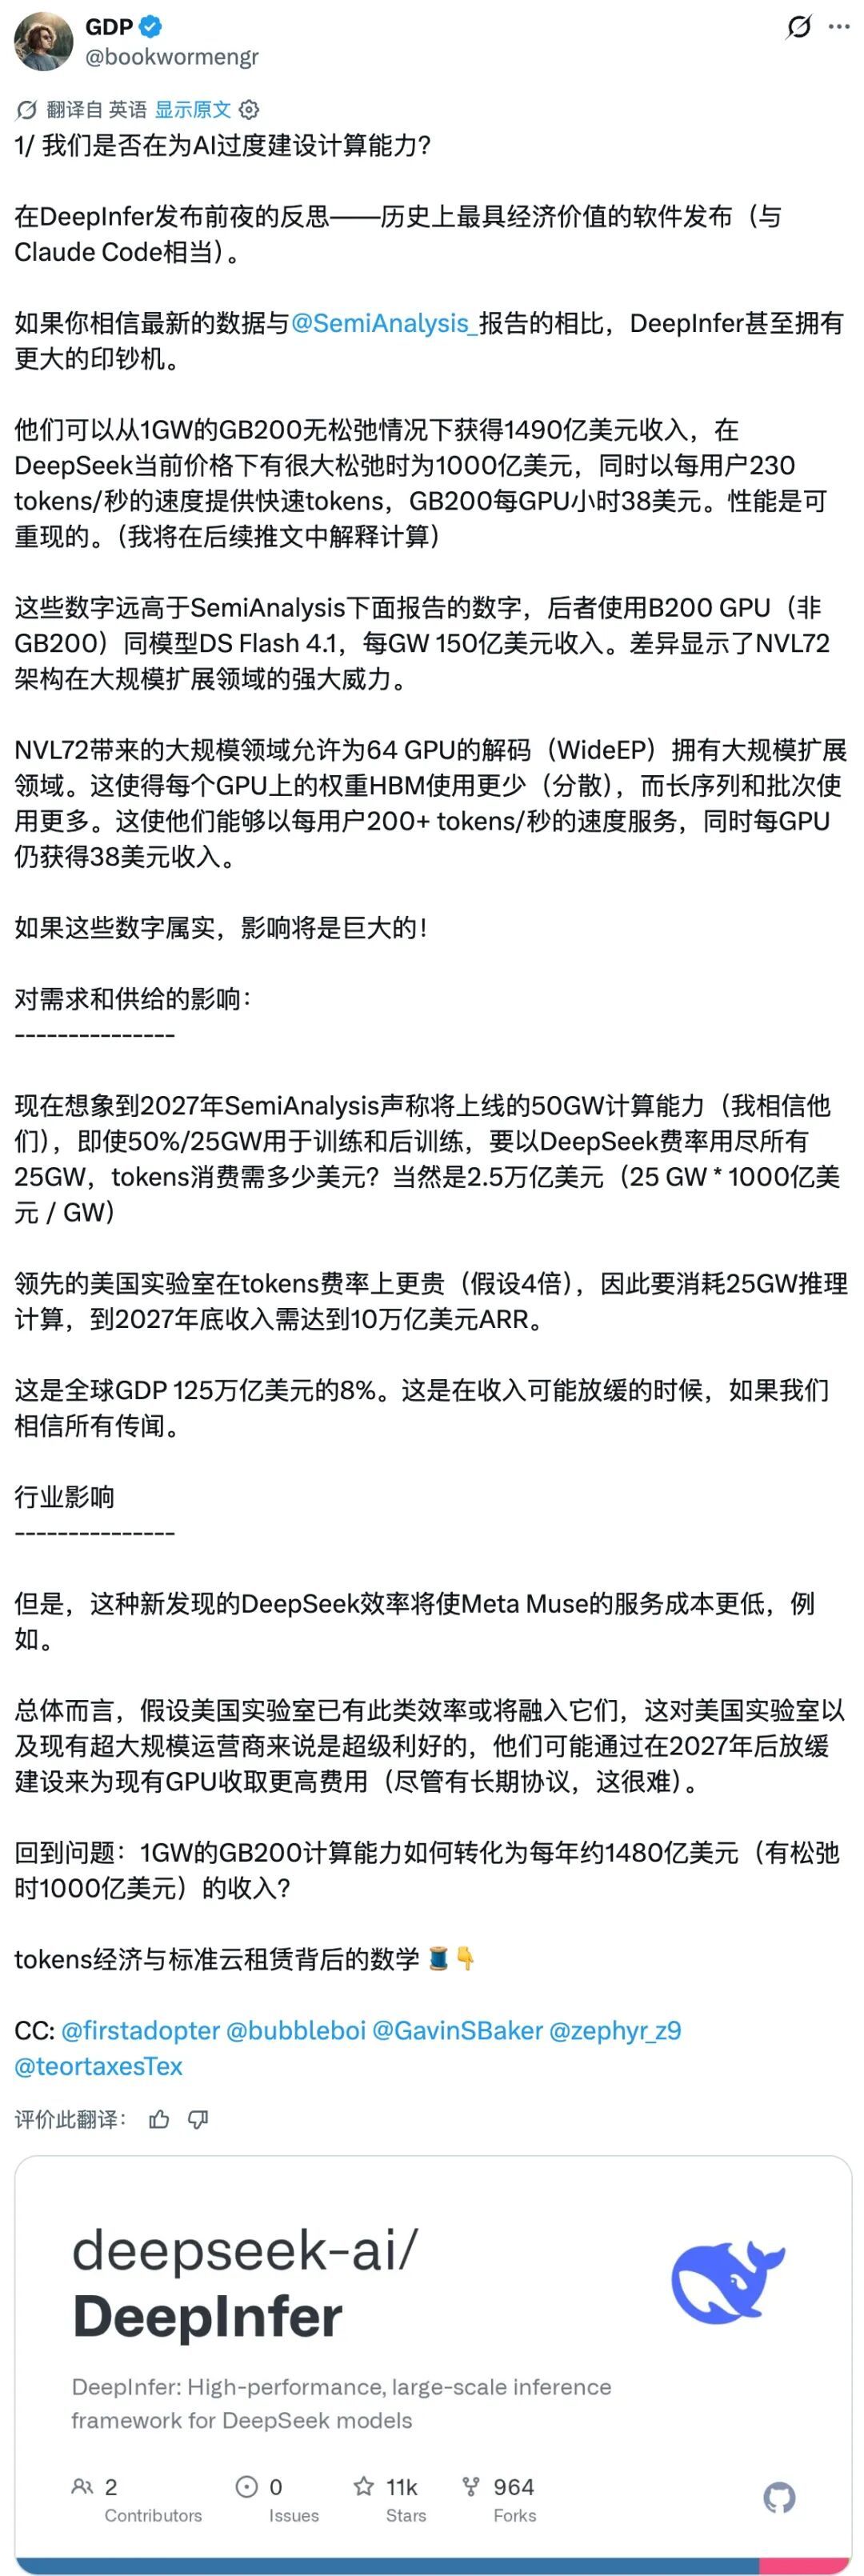
Umgerechnet in einen schwarzen Token-Preis, der mehr als viermal höher ist als der von OpenAI und Anthropic, muss die gesamte Menschheit bis Ende 2027 ganze 10 Billionen US-Dollar an ARR beisteuern, um den Appetit auf 25 GW Rechenleistung zu stillen.
Der Grund, warum ausländische Closed-Source-Giganten darauf angewiesen sind, Karten zu stapeln, Geld zu verbrennen und Hunderte von Milliarden Verträgen zu unterzeichnen, um ihre Narrative aufrechtzuerhalten, hat zwei Gründe. Entweder ist ihre eigene technische Optimierung zu langsam, oder sie nutzen absichtlich Ineffizienz als Deckmantel und legen hohe Schwellenwerte für die Rechenleistung fest, um andere davon abzuhalten.
DeepSeek hat diese KI-Blase mit kontinuierlichen Open-Source-Modellen und einer vollständigen Reihe von Open-Source-Argumentationsprojekten zum Platzen gebracht. Wie einige Internetnutzer scherzten, wird erwartet, dass sich OpenAI und Claude mit der Open-Source-Technologie DeepSeek heimlich erneut weiterentwickeln.
Mein Vorschlag ist, dass es, wenn drei von uns zusammen sind, eine Person geben muss, die mein Lehrer ist. Anthropic sollte aufhören, reserviert zu sein und über Nacht zu GitHub gehen, um DeepSeeks DeepInfer für die Bereitstellung zu klonen. Wenn Sie einige Ideen zur Cache-Planung und -Optimierung stehlen, können Sie eine Menge Rechenleistung sparen. (Manueller Hundekopf)
Kommentare