Zusammenfassung:
Die Kontroverse um die Rechtmäßigkeit generativer künstlicher Intelligenz-Trainingsdaten hat sich in letzter Zeit erneut verschärft. Aus einem Gerichtsdokument, das in der Urheberrechtsklage der New York Times entsiegelt wurde, geht hervor, dass ein leitender Forschungsdirektor bei Microsoft einmal in einer internen Diskussion beschrieb, dass die aktuelle Trainingsmethode großer Sprachmodelle möglicherweise „der größte Arbeitsdiebstahl in der Geschichte der Menschheit“ sei. Entsprechende Aussagen haben in der Branche große Aufmerksamkeit erregt.
Die diesmal veröffentlichten Bemerkungen kamen von Brent Hecht, Direktor für angewandte Wissenschaft bei Microsoft. Den neuesten öffentlichen Rechtsdokumenten zufolge bezeichnete Hecht diesen Prozess einmal als „einen erstaunlichen Diebstahl von beispiellosem Ausmaß“ und erklärte weiter, dass es sich möglicherweise um „den größten Arbeitsdiebstahl in der Geschichte der Menschheit“ handele, als er von Microsoft, OpenAI und anderen Unternehmen für künstliche Intelligenz sprach, die riesige Internetinhalte zum Trainieren von Modellen nutzten.
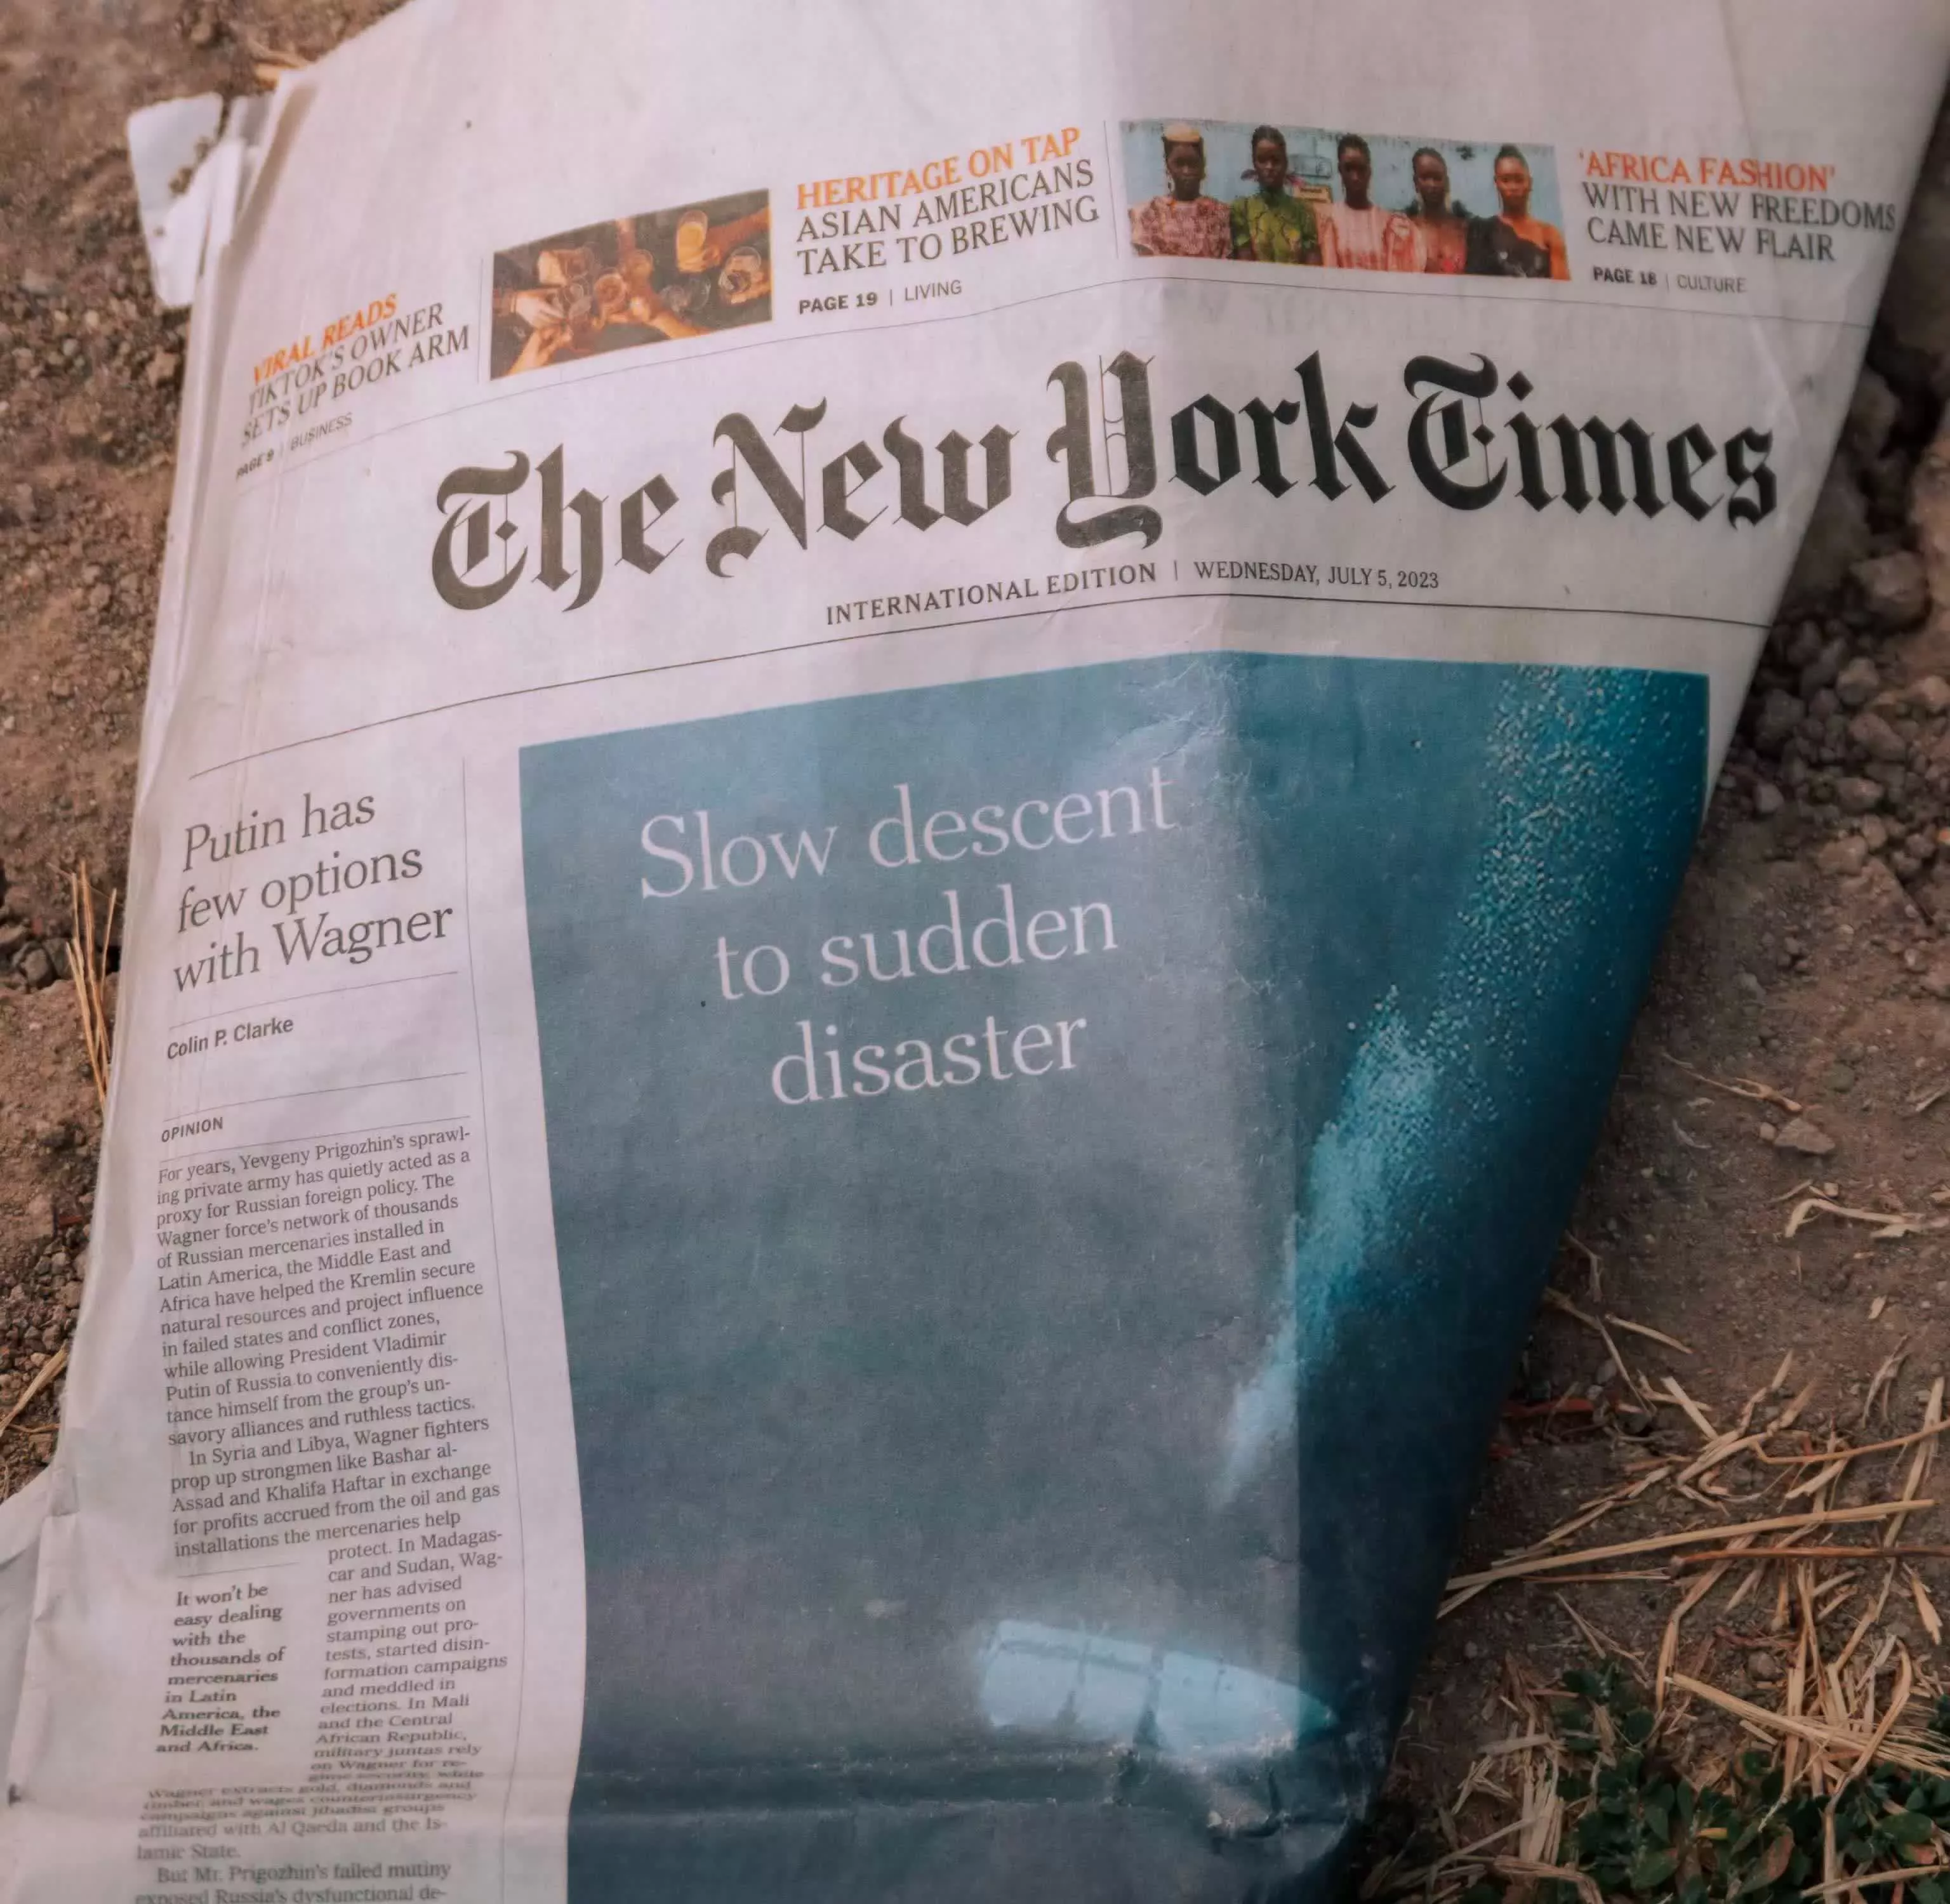
Dieser Inhalt erscheint in einer Urheberrechtsklage, die von der New York Times und anderen Nachrichtenpublikationen gegen Microsoft und OpenAI eingereicht wurde. Die Kläger gehen davon aus, dass die beiden Unternehmen Nachrichtenberichte und andere urheberrechtlich geschützte Inhalte genutzt haben, um Modelle der künstlichen Intelligenz unbefugt zu trainieren und diese zur Entwicklung kommerzieller Produkte zu nutzen.
Microsoft und OpenAI haben stets an ihrer „Fair Use“-Haltung festgehalten. Die beiden Unternehmen glauben, dass der Modellschulungsprozess dem Lesen von Büchern durch Schüler ähnelt, um sich Wissen anzueignen, und in den Bereich der fairen Nutzung fällt. Sie argumentieren auch, dass KI-generierte Inhalte das Originalmaterial so weit verändert haben, dass es sich nicht um eine direkte Kopie handelt.
Einige interne Kommunikationsaufzeichnungen in den neu entsiegelten Dokumenten scheinen jedoch in klarem Widerspruch zu dieser öffentlichen Position zu stehen.
Aus den Dokumenten geht hervor, dass Hecht einst der Meinung war, dass die beteiligten Unternehmen, wenn sie die Klage gewinnen wollten, „das Konzept der fairen Nutzung völlig verspotten“ müssten. Diese Aussage wird vom Kläger als wichtiger Beweis angesehen und dazu verwendet, die Logik der Urheberrechtsverteidigung in Frage zu stellen, an der Unternehmen der künstlichen Intelligenz seit langem festhalten.
Gleichzeitig wurden in dem Dokument auch einige interne Diskussionen von OpenAI offengelegt. Eine der Aufzeichnungen zeigt, dass OpenAI-Mitbegründer Greg Brockman zugibt, dass ChatGPT tatsächlich in der Lage war, Sätze in verwandten Artikeln vorherzusagen und fortzusetzen, als das Modell Inhalten der New York Times ausgesetzt wurde. Diese Art von Inhalten wird von Klägern verwendet, um zu beweisen, dass das Modell in der Lage ist, das Originalwerk zu reproduzieren, anstatt nur die gelernten Informationen zu abstrahieren.
Die Klageunterlagen zeigten auch, dass Hechts Bedenken hinsichtlich der langfristigen Entwicklung der Branche der künstlichen Intelligenz nicht auf die Urheberrechtsfrage selbst beschränkt sind. In einem anderen internen Präsentationsdokument schlug er einmal das sogenannte „Doomsday Loop“-Konzept vor.
Dieser Logik folgend reduzieren Antwort-Engines mit künstlicher Intelligenz nach und nach das Bedürfnis der Benutzer, Nachrichten-Websites zu besuchen, was zu einem Rückgang des Medienverkehrs und der Geschäftseinnahmen führt. Da immer mehr Content-Produktionsorganisationen ihre Rentabilität verlieren, werden auch die Quellen hochwertiger Informationen, die künstliche Intelligenzsysteme in Zukunft lernen können, abnehmen, was letztendlich dem Modell und dem gesamten Internet-Ökosystem schaden wird.
Er wies in internen Dokumenten darauf hin, dass es äußerst selten vorkomme, dass ein Produkt die wirtschaftliche Grundlage seiner Hauptlieferanten gefährde, die Branche der künstlichen Intelligenz befinde sich jedoch derzeit in dieser Situation. Da Nachrichtenorganisationen und Content-Ersteller wichtige Informationsquellen für KI-Modelle sind, ist die gesamte Content-Lieferkette gefährdet, wenn diese Gruppen betroffen sind.
Der Kläger berief sich auch auf interne Daten von Microsoft und behauptete, dass KI-Antwortsysteme wie Copilot einen erheblichen Einfluss auf den Datenverkehr einiger Nachrichten-Websites gehabt hätten. In einigen Fällen sank der Anteil der Benutzer, die auf die Seite der New York Times klickten, im Vergleich zu herkömmlichen Suchergebnissen um mehr als 90 %.
Tatsächlich ist der Streit um die Quelle von Trainingsdaten zu einer der wichtigsten rechtlichen Herausforderungen in der aktuellen Branche der künstlichen Intelligenz geworden.
OpenAI hat zuvor öffentlich erklärt, dass es eine nahezu unmögliche Aufgabe sei, fortschrittliche Systeme der künstlichen Intelligenz zu trainieren, ohne mit urheberrechtlich geschützten Inhalten in Berührung zu kommen. Auch der frühere Meta-Manager Nick Clegg äußerte sich ähnlich und glaubte, dass es bei strikter Einhaltung traditioneller Urheberrechtsregeln für viele aktuelle KI-Systeme schwierig sein werde, die Entwicklung aufrechtzuerhalten.
Gleichzeitig sehen sich viele Unternehmen, darunter Microsoft, Meta und andere Technologieunternehmen, aufgrund von Problemen mit der Quelle der Trainingsdaten weiterhin mit Kritik von außen konfrontiert. Einigen Unternehmen wurde vorgeworfen, Benutzerinhalte, Codebibliotheken, Artikel, Bilder und andere Online-Ressourcen zum Trainieren von Modellen zu verwenden, oft ohne ausdrückliche Genehmigung oder Vergütung der jeweiligen Urheber.
Während die Klage gegen die New York Times andauert, werden immer mehr interne Dokumente veröffentlicht. Brancheninsider glauben, dass diese Materialien nicht nur mit dem Ausgang des Urheberrechtsstreits zwischen Microsoft und OpenAI zusammenhängen, sondern auch die künftige globale Regulierungsrichtung in Bezug auf Schulungen im Bereich künstliche Intelligenz, Schutz des geistigen Eigentums und die Verteilung von Rechten und Interessen von Inhaltsproduzenten beeinflussen könnten.
Derzeit werden die entsprechenden Fälle noch geprüft. Unabhängig vom endgültigen Urteil wird dieser Rechtsstreit um die Rechtmäßigkeit der Ausbildung im Bereich der künstlichen Intelligenz zu einem wichtigen Meilenstein bei der Festlegung der zukünftigen Entwicklungsregeln der KI-Industrie.
Kommentare