
Zusammenfassung:
Für Windows-Benutzer, die Modelle der künstlichen Intelligenz auf ihren eigenen Computern ausführen möchten, gab es schon immer eine bestimmte Schwelle für die Installation und Konfiguration lokaler KI-Tools. Benutzer müssen nicht nur geeignete Modelldateien finden, sondern auch Aspekte wie Modellformat, Hardwarekompatibilität, Installation der Inferenz-Engine und Startparameter berücksichtigen. Heute versucht die Open-Source-Anwendung Llama für Windows, die von Entwicklern der Teams Hugging Face und llama.cpp gestartet wurde, diesen Prozess in ein paar einfache Vorgänge zu vereinfachen und es Benutzern zu ermöglichen, lokale große Sprachmodelle auf Windows-Computern herunterzuladen und auszuführen, ohne die Befehlszeile zu verwenden.
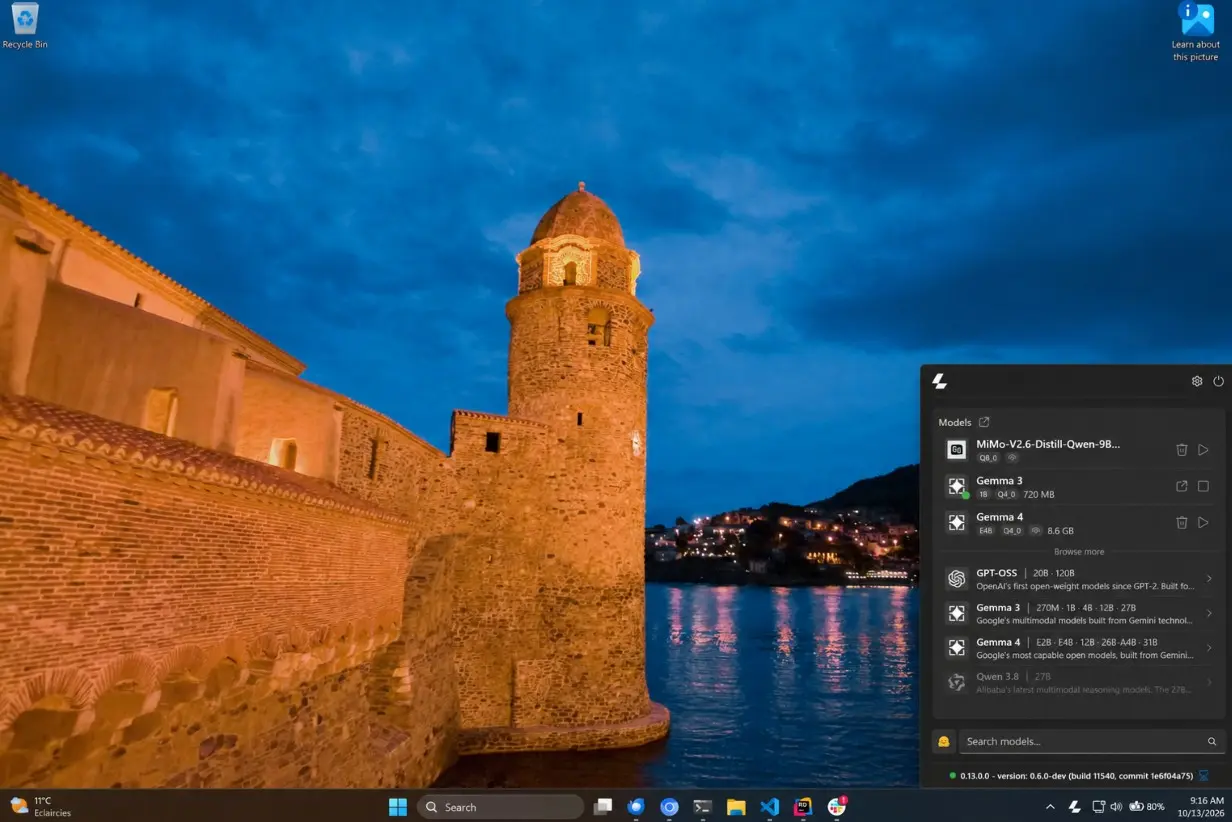
Llama für Windows erscheint im Oktober 2026 und ist das Windows-Gegenstück zur macOS-Version der Llama-Anwendung. Es handelt sich um eine kostenlose Open-Source-Windows-11-Anwendung, die auf der WinUI-3-Technologie von Microsoft basiert und hauptsächlich im Systembenachrichtigungsbereich ausgeführt wird. Nachdem Benutzer es installiert haben, können sie die Systemsteuerung über das Anwendungssymbol im Benachrichtigungsbereich der Taskleiste öffnen, ohne wie bei herkömmlicher Software ein unabhängiges Fenster beibehalten zu müssen.
Das wichtigste Merkmal dieser Anwendung ist die Möglichkeit, eine direkte Verbindung zum Hugging Face-Modelllager herzustellen. Hugging Face ist derzeit eine wichtige Hosting-Plattform für Open-Source-Modelle der künstlichen Intelligenz und vereint eine große Anzahl von Modellen und deren abgeleiteten Versionen verschiedener Entwicklungsteams. In der Vergangenheit mussten Benutzer in der Regel selbst eine geeignete Modelldatei finden, feststellen, ob das Dateiformat korrekt war, dann die entsprechende Version herunterladen und über die Inferenz-Engine starten. Für den durchschnittlichen Benutzer, der mit der Technologie der künstlichen Intelligenz nicht vertraut ist, kann dieser Vorgang recht mühsam sein.
Llama für Windows bietet eine Liste empfohlener Modelle innerhalb der Anwendung. Benutzer können die Parametergröße und den Speicherplatz des Modells überprüfen und prüfen, ob es visuelle Funktionen wie Bildverständnis unterstützt, und dann ein für ihren Computer geeignetes Modell zum Herunterladen auswählen. Nachdem Sie das Modell ausgewählt haben, klicken Sie einfach auf die entsprechende Option und die App startet automatisch den Download und zeigt den Download-Fortschritt an.
Dieses Tool verwendet hauptsächlich Quantisierungsmodelle im GGUF-Format. GGUF basiert auf dem llama.cpp-Ökosystem und hat sich zu einem der am weitesten verbreiteten Modelldateiformate für die lokale Ausführung großer Open-Source-Sprachmodelle entwickelt. Die Quantifizierungstechnologie kann den vom Modell benötigten Speicherplatz und Arbeitsspeicher reduzieren, indem sie die numerische Genauigkeit der Modellparameter verringert, wodurch Modelle, die ursprünglich höhere Hardwarekonfigurationen erfordern, die Möglichkeit erhalten, auf normalen Personalcomputern ausgeführt zu werden. Allerdings bringt die Quantisierung in der Regel auch einen gewissen Genauigkeitsverlust mit sich, und die konkreten Auswirkungen hängen vom Modell, der Quantisierungsmethode und dem Nutzungsszenario ab.
Im Hinblick auf die Modellverwaltung listet Llama für Windows die Modelle auf, die auf den Computer heruntergeladen wurden. Benutzer können die Modelle direkt laden oder entladen und über die integrierte Weboberfläche mit den Modellen kommunizieren. Die Anwendung zeigt außerdem den aktuellen Betriebsstatus des Modells an, sodass Benutzer wissen können, ob das Modell gestartet wurde, ohne den Hintergrundprozess manuell überprüfen zu müssen.
Die zugrunde liegende Inferenz-Engine kann auch automatisch von der Anwendung verwaltet werden. Llama für Windows verwendet llama.cpp als zentrale laufende Komponente. Wenn im System bereits ein verwendbarer llama.cpp-Dienst vorhanden ist, kann die Anwendung eine Verbindung zum vorhandenen Dienst herstellen. Wenn es nicht installiert ist, kann es über das offizielle Installationsprogramm installiert werden. Für den gesamten Prozess sind keine Administratorrechte erforderlich, und Benutzer müssen den Quellcode nicht selbst kompilieren oder komplexe Startparameter manuell konfigurieren.
Dieses Design senkt die Eintrittsbarriere für lokale KI, bedeutet aber nicht, dass alle Modelle auf jedem Computer reibungslos laufen können. Die tatsächliche Leistung des Modells hängt weiterhin vom Prozessor, dem Speicher, der Grafikkarte, der Videospeicherkapazität und der Größe des Modells selbst ab. Modelle mit kleineren Parametergrößen lassen sich im Allgemeinen einfacher auf einem normalen Computer ausführen, während größere Modelle möglicherweise viel Speicher oder sogar eine Workstation mit einer leistungsstarken Grafikkarte erfordern, um gute Reaktionszeiten zu erzielen.
Llama für Windows bietet außerdem eine Chat-Oberfläche, die einem Schnellstarter auf Systemebene ähnelt. Benutzer können in anderen Anwendungen die Tastenkombination Alt+Leertaste drücken, um das schwebende Chat-Fenster aufzurufen und direkt mit dem aktuell geladenen Modell zu interagieren. Das Fenster ist leichtgewichtig gestaltet und die Konversation wird nicht sofort nach dem Ausblenden geschlossen und kann bei einem erneuten Aufruf weiterhin verwendet werden. Dies bedeutet, dass Benutzer beim Schreiben von Dokumenten, beim Surfen im Internet oder beim Schreiben von Code nicht wiederholt auf eigenständige KI-Anwendungen umsteigen müssen.
Neben der Chat-Funktion für normale Benutzer berücksichtigt die Software auch die Bedürfnisse von Entwicklern. Die Anwendung kann einen lokalen Server basierend auf llama.cpp auf dem lokalen Computer starten und Modelldienste über eine mit der OpenAI-Schnittstelle kompatible API bereitstellen. Die Standarddienstadresse ist
http://localhost:9931. Entwickler können ihre Skripte, Anwendungen oder KI-Agenten lokale Modelle aufrufen lassen, ohne alle Anfragen an Remote-Cloud-Dienste senden zu müssen.
Da die Schnittstelle mit der OpenAI-API kompatibel ist, können einige Tools, die ursprünglich für die OpenAI-Schnittstelle entwickelt wurden, die Möglichkeit haben, auf lokal laufende Modelle zuzugreifen, indem sie einfach die Dienstadresse und zugehörige Konfigurationen anpassen. Schnittstellenkompatibilität bedeutet jedoch nicht, dass alle Funktionen vollständig konsistent sind. Ob es genutzt werden kann, hängt immer noch von den vom Client benötigten API-Fähigkeiten ab und davon, ob das geladene Modell die entsprechenden Funktionen unterstützt.
Dadurch ist Llama für Windows nicht nur ein lokales Chat-Tool, sondern auch eine KI-Laufplattform auf PCs. Die gleiche Modelldatei kann von mehreren Anwendungen gemeinsam genutzt werden, und Entwickler müssen nicht für jedes Programm ein separates Modell herunterladen, wodurch die wiederholte Belegung von Speicherplatz reduziert wird. Diese Architektur hat einen gewissen praktischen Wert für Benutzer, die Programmierassistenten, Dokumentenanalysetools oder andere KI-Anwendungen lokal erstellen möchten.
Im Hinblick auf den Datenschutz besteht der Hauptvorteil der lokalen Ausführung von Modellen darin, dass der Inferenzprozess nicht auf Remote-KI-Dienste angewiesen ist. Der Projektbeschreibung zufolge erfolgen vom Benutzer eingegebene Eingabeaufforderungswörter und Modellinferenzen nativ, und die App sammelt keine Telemetriedaten, analysiert keine Ereignisse und generiert keine speziellen Installationskennungen. Allerdings müssen Benutzer weiterhin eine Verbindung zum Internet herstellen, um Modelldateien herunterzuladen und Software-Updates zu erhalten. In der Projektbeschreibung wird außerdem erwähnt, dass diese Netzwerkanfragen eine standardmäßige User-Agent-Identifikation enthalten, die Informationen wie Softwareversion, Windows-Version und Prozessorarchitektur enthält. Daher bedeutet der sogenannte lokale Betrieb nicht, dass für den gesamten Installations- und Wartungsprozess überhaupt kein Netzwerk erforderlich ist, sondern dass Modellinferenz und schnelle Textverarbeitung lokal bleiben können.
Hardwarekompatibilität steht ebenfalls im Fokus dieser App. Llama für Windows unterstützt die x64- und ARM64-Plattformen von Windows 11 und bietet native Unterstützung für Windows on Arm-Geräte. Dies ist besonders wichtig für Windows-Notebooks, die mit ARM-Prozessoren ausgestattet sind, da einige lokale KI-Tools in der Vergangenheit hauptsächlich für herkömmliche x86-Computer entwickelt wurden und möglicherweise auf Simulationen angewiesen sind, die auf ARM-Geräten ausgeführt werden, oder weil entsprechende vorkompilierte Komponenten fehlen.
Das Projekt erwähnte auch die Unterstützung für die NVIDIA RTX Spark-Plattform. Die Plattform ist auf lokale KI-Computing-Anwendungen ausgerichtet und kann eine weitere Hardwareoption für Benutzer bieten, die größere Modelle in einer Desktop-Umgebung ausführen möchten. Allerdings bedeutet die Softwareunterstützung einer bestimmten Plattform nicht, dass alle Modelle eine optimale Leistung erzielen können. Die spezifischen Betriebsergebnisse hängen weiterhin von der Modellgröße, der Speicherkapazität und der Inferenzkonfiguration ab.
Llama für Windows kann über die offizielle Website von Llama bezogen werden, oder Sie können das entsprechende Installationspaket von der GitHub-Release-Seite des Projekts herunterladen. Nach der Installation können Benutzer die App öffnen, ein Modell auswählen, warten, bis der Download abgeschlossen ist, und sie dann über ein schwebendes Chat-Fenster oder eine Weboberfläche verwenden. Es ist zu beachten, dass die App derzeit für Windows 11 ist und Windows 10 nicht als unterstützte Plattform auflistet.
Im Allgemeinen erfindet Llama für Windows die laufende Technologie lokaler großer Sprachmodelle nicht neu, sondern integriert die Schritte, die ursprünglich in Modell-Warehouses, Inferenz-Engines und Befehlszeilentools verstreut waren, in eine schlanke Schnittstelle. Sein größter Wert liegt in der Senkung der Nutzungsschwelle bei gleichzeitiger Beibehaltung von Skalierbarkeitsfunktionen wie lokalen APIs und Entwickler-Workflows.
Während sich das Open-Source-Modell weiterentwickelt, wandelt sich die lokale Ausführung von KI allmählich von einem aufwändigen Projekt, das gewisse technische Erfahrung erfordert, zu einem Anwendungsszenario, das normale Computerbenutzer ausprobieren können. Ob Llama für Windows ein Mainstream-Tool werden kann, hängt von seiner Stabilität, dem Modellunterstützungsbereich und der tatsächlichen Lauferfahrung ab, aber es macht es Windows-Benutzern zumindest einfacher: Sie können damit beginnen, die Ausführung von KI-Modellen auf ihren eigenen Computern zu erkunden, ohne zuerst komplexe Befehlszeilenoperationen erlernen zu müssen.
Download-Adresse:
https://llama.app/download/windows
https://github.com/ggml-org/Llama-Windows
Kommentare