
Zusammenfassung:
Microsoft hat offiziell den selbst entwickelten künstlichen Intelligenzchip Maia 300 der dritten Generation angekündigt und plant, ihn ab 2027 in einer Produktionsumgebung einzusetzen, um KI-Denkungsaufgaben hinter Produkten und Diensten wie Copilot zu unterstützen. Microsoft sagte, dass Maia 300 im Vergleich zum derzeit führenden GPU-System voraussichtlich 40 % mehr Token pro Megawatt Leistung verarbeiten kann; In einer vollständigen Rack-Konfiguration mit 96 Beschleunigern kann der Token-Durchsatz auf Rack-Ebene bis zu siebenmal so hoch sein wie der der Maia 200 der vorherigen Generation.
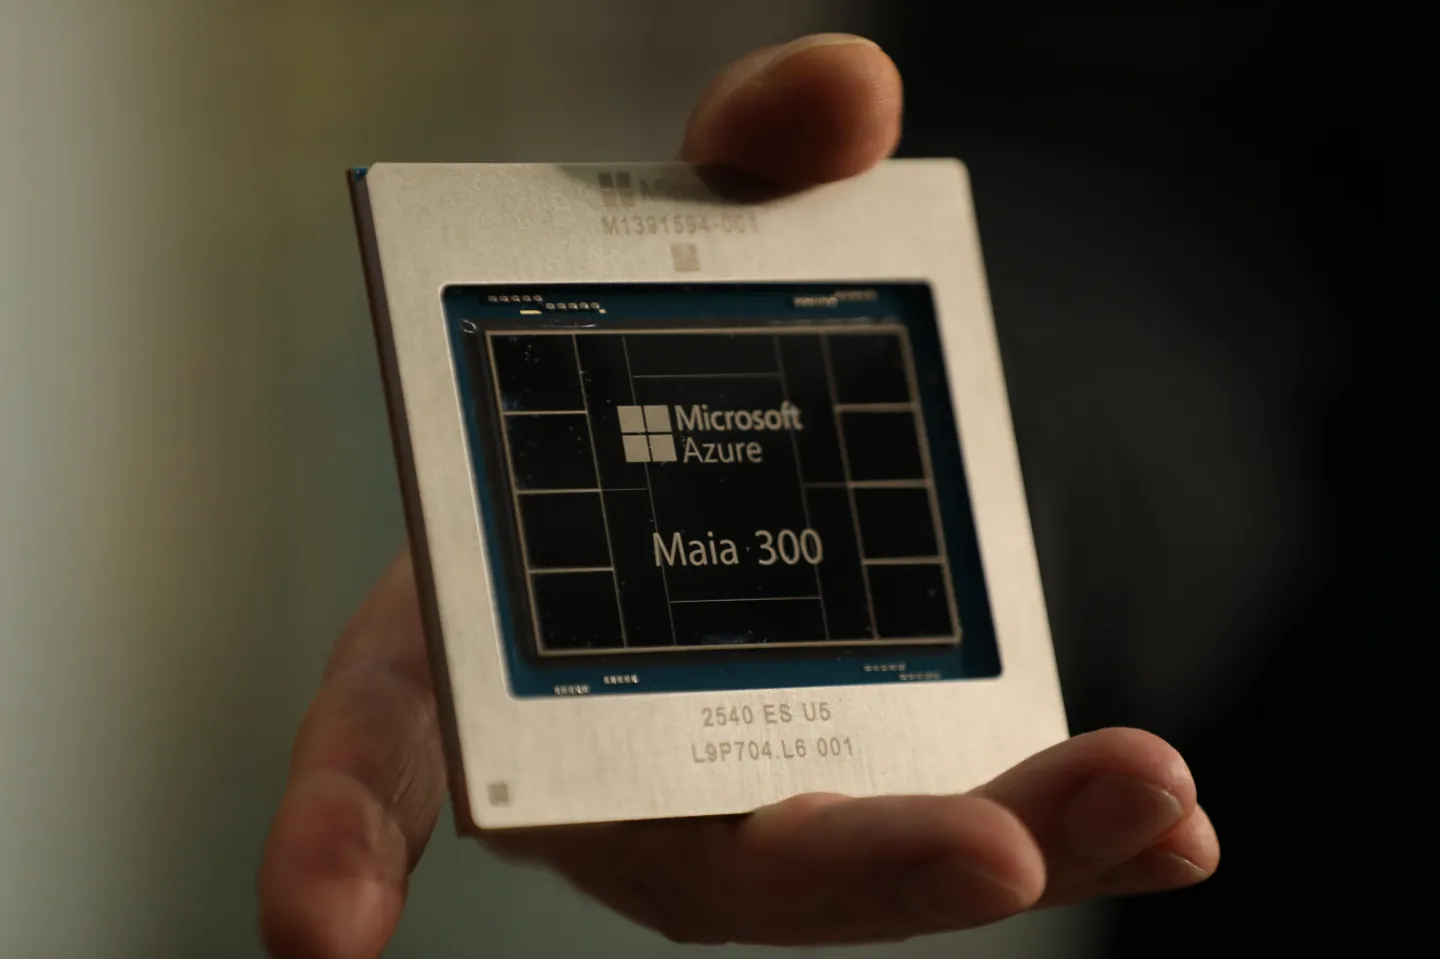
Diese Veröffentlichung markiert die weitere Investition von Microsoft in selbst entwickelte KI-Chips. Da die Nutzung künstlicher Intelligenzdienste weiter zunimmt, hofft Microsoft, durch selbst entwickelte Beschleuniger die Betriebskosten zu senken, die Energieeffizienz zu verbessern und die Abhängigkeit von GPUs von Anbietern wie Nvidia und AMD zu verringern.
Scott Guthrie, Executive Vice President des Cloud-Computing-Geschäfts von Microsoft, sagte, dass das Unternehmen plant, den Einsatzumfang der Chips der Azure Maia-Serie ab 2027 auf das Multi-Gigawatt-Niveau zu erweitern und sie zum wichtigsten KI-Inferenzsystem für Microsoft-Produkte und -Dienste zu machen.
Dieses Ziel bedeutet, dass Microsoft hofft, selbst entwickelte Chips schrittweise von einem Teil der bestehenden Infrastruktur zu einer Kerncomputerplattform aufzurüsten, die seine eigenen KI-Dienste unterstützt. Dies bedeutet jedoch nicht, dass Microsoft den Kauf von GPUs von Nvidia oder AMD komplett einstellen wird. Microsoft wird wahrscheinlich weiterhin mehrere Hardwareplattformen für Trainings- und Inferenzaufgaben verwenden, die unterschiedliche Rechenkapazitäten erfordern.
Maia 300 ist das Produkt der dritten Generation der Maia-Serie von Microsoft und gleichzeitig der Chip der nächsten Generation, der nach der Ankündigung von Maia 200 im Januar dieses Jahres auf den Markt kam. Maia 200 wird derzeit für KI-Workloads in mehreren Microsoft-Produktionsumgebungen verwendet, darunter Microsoft Copilot, GitHub Copilot, Microsoft Foundry und die von Microsoft selbst entwickelten Modelle für künstliche Intelligenz.
Guthrie sagte, dass Maia 200, gemessen an den Betriebsindikatoren der tatsächlichen KI-Dienste, bereits eine der leistungsstärksten KI-Infrastrukturen innerhalb von Microsoft sei. Die Maia 300 der neuen Generation wurde speziell für sich ständig ändernde KI-Arbeitslasten entwickelt, insbesondere für solche, die lange Kontextschlüsse, Echtzeitgespräche, die sehr latenzempfindlich sind, und KI-Agentenaufgaben bewältigen müssen, die kontinuierlich mehrere Schritte ausführen.
Diese Anwendungen stellen andere Anforderungen an die Hardware als herkömmliche KI-Inferenz.
Da umfangreiche Sprachmodelle nach und nach in Programmierassistenten, Unternehmensautomatisierung und der Ausführung komplexer Aufgaben eingesetzt werden, wird der Kontext, den KI-Systeme verarbeiten müssen, immer länger und eine einzelne Aufgabe umfasst immer mehr Modellaufrufe und Werkzeugoperationen. Für Cloud-Dienstanbieter müssen neben der Leistung des Modells selbst auch die Antwortlatenz, die Anzahl gleichzeitiger Anforderungen, die Speicherkapazität und die tatsächlichen Kosten jeder Inferenz berücksichtigt werden.
Daher liegt der Designschwerpunkt von Maia 300 nicht nur auf der Steigerung der Spitzenrechenleistung, sondern auch auf der Verbesserung der Gesamteffizienz in einer realen Geschäftsumgebung, die kontinuierlich läuft. Microsoft hofft, die Chip-Architektur gezielt optimieren zu können, um sie für die Rechenlast besser geeignet zu machen, die durch Inferenzmodelle und KI-Agenten der neuen Generation entsteht.
Im Hinblick auf die Chipherstellung übernimmt Maia 300 den fortschrittlichen N2P-Prozess von TSMC und führt eine kernbasierte Designarchitektur ein. Im Vergleich zu herkömmlichen Designs, die verschiedene Funktionen auf einem einzigen großen Chip integrieren, kann die Kernchiparchitektur Funktionen wie Computer, Speichercontroller sowie Ein- und Ausgabe in verschiedene Module unterteilen und diese dann entsprechend ihren jeweiligen Eigenschaften entwerfen.
Das Hardware- und Infrastrukturteam von Microsoft Azure gab an, dass dieses Design es ermöglicht, mehr Siliziumfläche im Chip für die Rechenleistung zu nutzen und gleichzeitig verschiedenen Funktionsmodulen die Übernahme von Technologien zu ermöglichen, die besser für ihre eigenen Anforderungen geeignet sind.
Diese Idee hat praktische Bedeutung. Für KI-Beschleuniger ist die Recheneinheit wichtig, aber auch die Art und Weise, wie Daten zwischen Recheneinheit, Speicher und externen Geräten übertragen werden, wirkt sich auf die Gesamtleistung aus. Wenn die Recheneinheit auf das Eintreffen von Daten warten muss, kann sie ihre Leistung auch bei hoher theoretischer Rechenleistung nicht voll ausschöpfen.
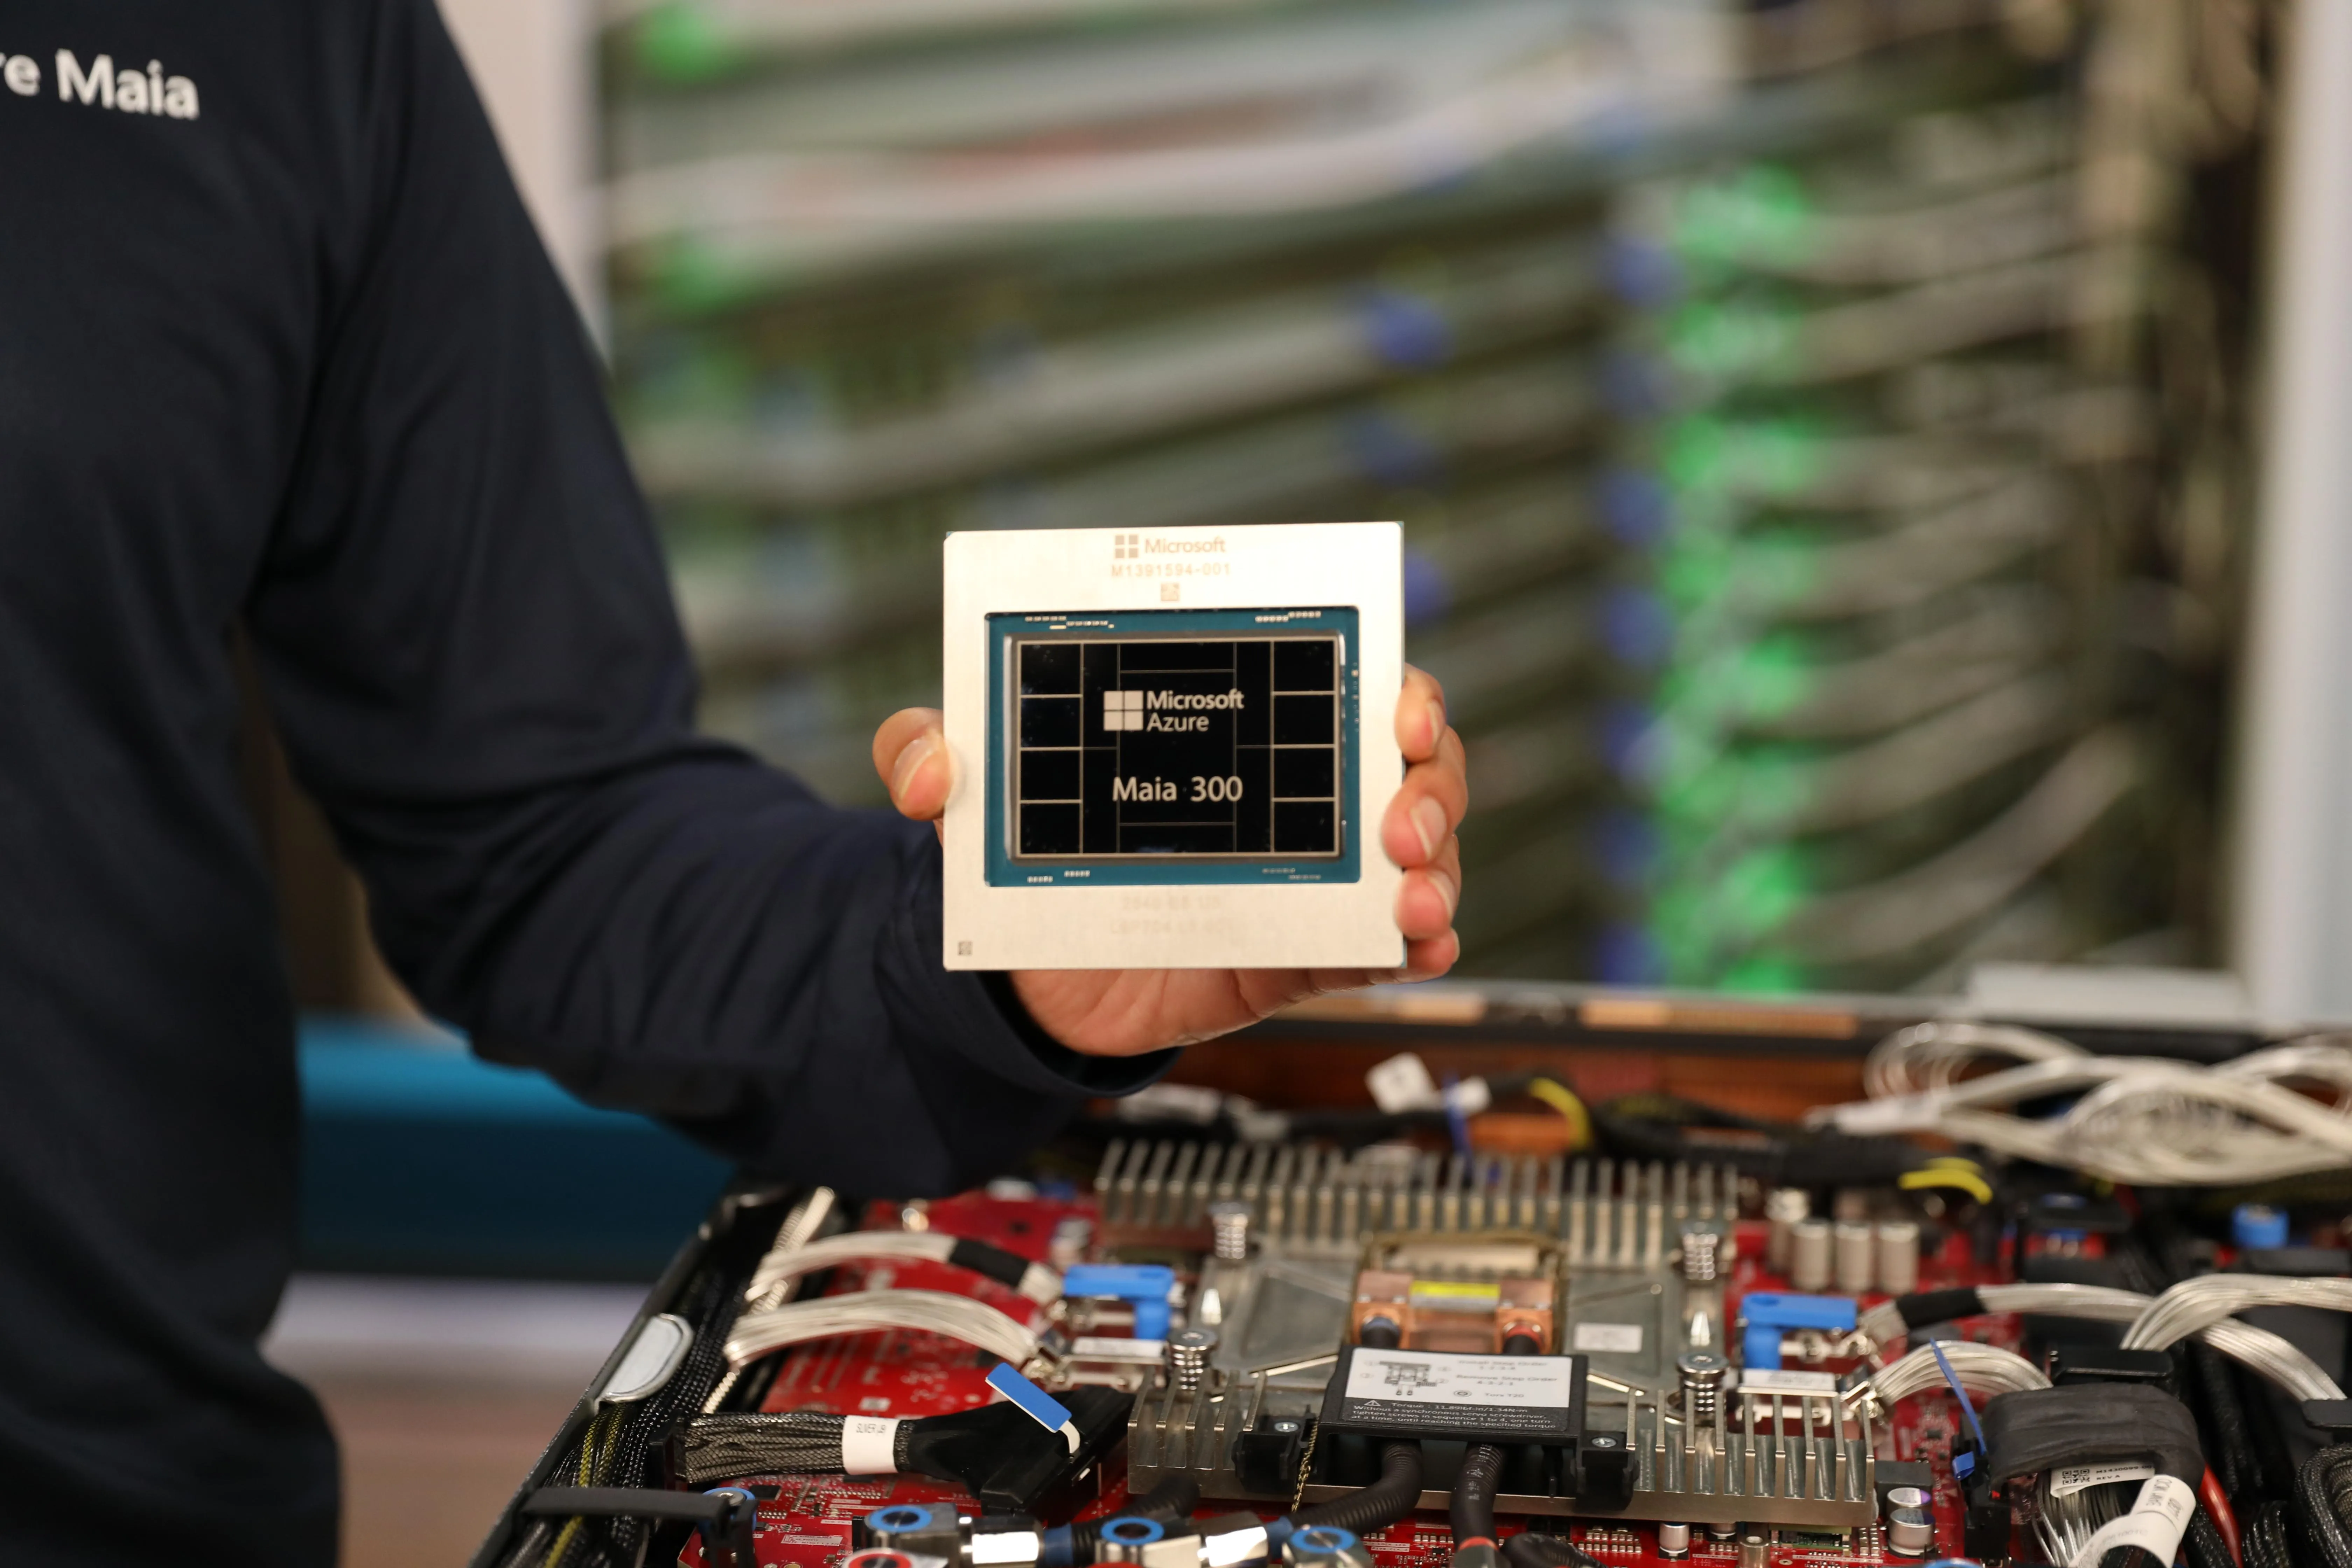
Durch die getrennte Optimierung von Rechenleistung, Speichersteuerung sowie Eingabe- und Ausgabefunktionen hofft Microsoft, die Gesamteffizienz der Ressourcennutzung des Chips zu verbessern und ein besseres Gleichgewicht zwischen Leistung, Stromverbrauch und Herstellungskosten zu erreichen.
Der Einsatz fortschrittlicher Prozesse wird auch dazu beitragen, die Transistordichte und die Energieeffizienz zu verbessern, aber die endgültige Leistung des Chips hängt immer noch von mehreren Faktoren wie Mikroarchitektur, Speichersubsystem, Verbindungsdesign und Softwareoptimierung ab. Die von Maia 300 veröffentlichten Leistungsdaten stammen derzeit hauptsächlich aus der eigenen Einführung von Microsoft, und der tatsächliche Effekt muss noch anhand verschiedener Modelle, Arbeitslasten und Bereitstellungsbedingungen bewertet werden.
Im Bereich der KI-Argumentation ist der Token-Durchsatz einer der wichtigen Indikatoren zur Messung der Systemeffizienz. Token ist die grundlegende Dateneinheit, die von großen Sprachmodellen bei der Textverarbeitung verwendet wird und normalerweise einem Wort, einem Wortfragment oder einer anderen Texteinheit entspricht. Wie viele Token das System pro Zeiteinheit verarbeiten kann, wirkt sich direkt darauf aus, wie viele Benutzer es gleichzeitig bedient und welche Rechenressourcen zur Erledigung der Aufgabe erforderlich sind.
Microsoft geht davon aus, dass der Maia 300 40 % mehr Token pro Megawatt verarbeiten kann als führende GPU-Systeme. Dies bedeutet, dass Microsoft bei gleichem Energiebudget voraussichtlich mehr KI-Anfragen verarbeiten oder den Stromverbrauch senken und gleichzeitig die gleichen Servicefunktionen bereitstellen kann.
Für Cloud-Service-Anbieter mit großen Rechenzentren kann diese Effizienzsteigerung einen erheblichen wirtschaftlichen Mehrwert bringen. KI-Rechenzentren müssen nicht nur teure Beschleuniger kaufen, sondern auch die Kosten für Stromversorgung, Kühlung, Netzwerkausrüstung und Infrastrukturbau tragen. Da die Modellnutzung weiter zunimmt, werden Stromversorgung und Rechenzentrumskapazität zu wichtigen Faktoren, die den Ausbau von KI-Diensten einschränken.
Die Token-Effizienz pro Megawatt ist jedoch nicht der einzige Indikator zur Messung von KI-Chips. Die Parameterskala, die Kontextlänge, die Genauigkeitseinstellungen und die Inferenzmethoden verschiedener Modelle wirken sich alle auf die Testergebnisse aus. Um Produkte wie Maia 300 und NVIDIA-GPUs umfassend zu vergleichen, müssen auch Latenz, Modellkompatibilität, Software-Ökosystem, Bereitstellungskosten und Stabilität im tatsächlichen Geschäft berücksichtigt werden.
Microsoft kündigte außerdem einen attraktiveren Indikator an: In einer vollständigen Rack-Konfiguration bestehend aus 96 Beschleunigern kann der Token-Durchsatz auf Rack-Ebene von Maia 300 bis zu siebenmal so hoch sein wie der von Maia 200.
Diese Zahl zeigt, dass Microsoft nicht nur die Effizienz eines einzelnen Chips verbessern möchte, sondern auch die Rechenleistung des gesamten Racks optimieren möchte. Es beschreibt jedoch den Durchsatz auf Rack-Ebene unter einer bestimmten Konfiguration. Dies bedeutet nicht, dass der Maia 300 bei allen Aufgaben siebenmal schneller ist als der Maia 200, und es kann auch nicht direkt abgeleitet werden, dass sich die Leistung jedes Chips im gleichen Verhältnis verbessert hat.
Für Cloud-Computing-Plattformen ist die Leistung auf Rack-Ebene besonders wichtig. Reale Einsätze bestehen typischerweise aus einer großen Anzahl von Beschleunigern, wobei die Chips Daten über Hochgeschwindigkeitsverbindungen austauschen und gemeinsam Modellanfragen verarbeiten. Selbst wenn ein einzelner Chip leistungsstark ist, kann das gesamte System dennoch eingeschränkt sein, wenn die Verbindungsbandbreite, die Speicherkapazität oder die Planungseffizienz nicht ausreichen.
Daher versucht Microsoft, eine Gesamtoptimierung vom Chip-Design über die Rack-Konfiguration bis hin zur Software und Modell-Betriebsumgebung durchzuführen, anstatt einfach nur die theoretische Rechenleistung des Prozessors zu verfolgen.
Microsoft AI-Chef Mustafa Suleyman sagte, das Unternehmen müsse beginnen, von unten in den gesamten Technologie-Stack zu investieren, einschließlich des Chip-Designs. Er glaubt, dass Microsoft, wenn KI-Dienste ein so großes Ausmaß erreichen, über eine eigene Plattform verfügen und die gemeinsame Gestaltung und Optimierung von Chips und selbst entwickelten Modellen ermöglichen muss.
Er betonte insbesondere, dass es eine wichtige Aufgabe für das Microsoft AI-Team ist, die von Microsoft selbst entwickelten KI-Modelle auf Maia-Chips laufen zu lassen.
Diese Aussage verrät ein weiteres Ziel von Microsofts Entwicklung selbst entwickelter Chips: Hardware, Modelle und Cloud-Dienste zu einer engeren Zusammenarbeit zu kombinieren.
Herkömmliche Cloud-Dienstanbieter können KI-Modelle durch den Kauf von Allzweck-GPUs bereitstellen. Wenn sie jedoch ihre eigenen Beschleuniger entwerfen können, können sie die Recheneigenschaften, Speicheranforderungen und Inferenzprozesse ihrer eigenen Modelle optimieren. Im Gegenzug kann das Modellteam die Modellstruktur und Betriebsmethode entsprechend der Chiparchitektur anpassen und so die Gesamteffizienz verbessern.
Google und Amazon investieren seit vielen Jahren in selbst entwickelte KI-Chips. Google verfügt über eine Reihe von TPU-Beschleunigern und Amazon hat Chips wie Trainium entwickelt, um seine eigenen Cloud-Computing- und künstlichen Intelligenzdienste zu unterstützen. Microsoft hat die Maia-Serie auf den Markt gebracht, um seine Infrastrukturkapazitäten vor diesem Wettbewerbshintergrund zu stärken.
Für Microsoft besteht der strategische Wert selbst entwickelter Chips nicht nur darin, die Beschaffungskosten zu senken, sondern auch darin, die Autonomie der Lieferkette zu verbessern, die Energienutzung von Rechenzentren zu optimieren und eine größere Kontrolle über das Hardware-Design zu haben, wenn KI-Modelle und -Dienste schnell iteriert werden.
Derzeit pflegt Microsoft noch eine enge Zusammenarbeit mit NVIDIA und NVIDIA-GPUs spielen weiterhin eine wichtige Rolle im Bereich KI-Training und -Inferenz. Die gleichzeitige Entwicklung der Maia-Serie durch Microsoft bedeutet nicht, dass sich die Beziehung zwischen den beiden Parteien zwangsläufig grundlegend ändern wird, sondern spiegelt wider, dass große Cloud-Dienstleister ihre Abhängigkeit von einer einzigen Hardwareplattform durch selbst entwickelte Chips und Multi-Vendor-Strategien reduzieren.
Microsoft hofft auch, durch den Einsatz selbst entwickelter Chips die Wettbewerbsfähigkeit seiner KI-Modelle zu verbessern. Suleiman sagte, dass die Maia-Plattform ein wichtiger Teil des KI-Technologiesystems von Microsoft sei und dem Unternehmen dabei helfen könne, seine eigenen Modelle weiterzuentwickeln und seine Wettbewerbsfähigkeit gegenüber Konkurrenten wie Google DeepMind, OpenAI und Anthropic zu verbessern.
Da sich KI-Modelle allmählich von einfachen Textgenerierungstools zu Agentensystemen entwickeln, die Tools aufrufen und komplexe Vorgänge ausführen können, nimmt auch die Bedeutung der Hardware-Infrastruktur zu. Langkontextschlussfolgerungen und mehrstufige Aufgabenausführung erfordern häufig längere Rechenprozesse und eine große Anzahl von Modellaufrufen. Nur durch ein besseres Gleichgewicht zwischen Leistung, Latenz und Kosten können Unternehmen ihre Dienste nachhaltig skalieren.
Maia 300 wurde als Reaktion auf diesen Trend entwickelt. Microsoft hofft, durch höheren Durchsatz und Energieeffizienz die Ausführung von mehr KI-Aufgaben zu geringeren Kosten zu ermöglichen und gleichzeitig Computerunterstützung für Copilot, GitHub Copilot und zukünftige KI-Agentendienste bereitzustellen.
Damit Maia 300 jedoch wirklich zur Hauptkraft der KI-Infrastruktur von Microsoft wird, muss es noch den Prozess von der Chipherstellung über die Systemintegration bis hin zur groß angelegten Bereitstellung durchlaufen. Microsoft plant, im Jahr 2027 mit der Produktion zu beginnen und den Umfang der Bereitstellung schrittweise zu erweitern. Bis dahin werden sich die tatsächliche Produktionskapazität, die Systemstabilität, die Softwareanpassung und die Integration in bestehende Rechenzentren des Chips auf seinen endgültigen Anwendungsbereich auswirken.
Insgesamt zeigt die Einführung von Maia 300, dass Microsoft KI-Chips aus Hilfsinfrastrukturprojekten zu einem Kernbestandteil seiner eigenen Strategie für künstliche Intelligenz erhebt. Durch die Nutzung der fortschrittlichen Prozesse, des granularen Kerndesigns und der Optimierung auf Systemebene für Inferenz-Workloads von TSMC hofft Microsoft, die KI-Dienstfunktionen, die es pro Stromeinheit bereitstellen kann, zu verbessern und seine Abhängigkeit von externen GPU-Lieferanten zu verringern.
Wenn Microsoft den Produktionseinsatz von Maia 300 wie geplant im Jahr 2027 ausweiten und die erwarteten Effizienzsteigerungen im realen Geschäft erzielen kann, wird diese Chipserie voraussichtlich zu einem wichtigen Werkzeug für das Unternehmen, um die Kosten für KI-Computing zu kontrollieren und den Serviceumfang zu erweitern. Aber seine langfristige Wettbewerbsfähigkeit hängt letztlich von der tatsächlichen Betriebsleistung ab und davon, ob Microsoft ein nachhaltiges und effektives kollaboratives Optimierungssystem zwischen Hardware, Modellen und Software etablieren kann.
Kommentare