
Zusammenfassung:
Das chinesische Unternehmen für künstliche Intelligenz MiniMax hat am 19. Oktober 2026 das Modell M3.1 Flash der neuen Generation veröffentlicht und behauptet, dass das Modell erhebliche Fortschritte in Bereichen wie Agentenaufgaben, Programmierung und Netzwerksicherheit erzielt hat, während es gleichzeitig die Online-Inferenzgeschwindigkeit auf fast das Dreifache der vorherigen Generation erhöht und die Nutzungskosten um etwa 70 % gesenkt hat. Kurz nach der Veröffentlichung des Modells erregte jedoch schnell eine Kontroverse um seine unabhängigen Bewertungsergebnisse Aufmerksamkeit:
Einige Forscher vermuten, dass MiniMax möglicherweise einigen Testfragen ausgesetzt war, die von der Bewertungsagentur Artificial Analysis bei der Bewertung des M3-Modells der vorherigen Generation verwendet wurden, und die relevanten Inhalte zum Trainieren von M3.1 Flash verwendet hat, wodurch das neue Modell in bestimmten Benchmark-Tests außergewöhnlich hervorragende Ergebnisse erzielen konnte.
Es sollte betont werden, dass es sich zum Zeitpunkt der Veröffentlichung relevanter Berichte immer noch um eine Anschuldigung handelt, die auf begrenzten Phänomenen beruht, und es keine öffentlichen Beweise dafür gibt, dass MiniMax die Bewertungsfragen tatsächlich gestohlen oder verwendet hat. Im Mittelpunkt der Kontroverse steht ein seit langem bestehendes Rätsel in der Branche der künstlichen Intelligenz: Ob die hohen Punktzahlen eines Modells in Benchmark-Tests eine echte Verbesserung der allgemeinen Fähigkeiten widerspiegeln oder ob sie teilweise auf die Optimierung des Tests selbst zurückzuführen sind.
Der Schlüssel zu dieser Kontroverse liegt in der AA-Omniscience-Rezension von Artificial Analysis. Hierbei handelt es sich um einen Test, der sich auf Faktenwissen und Antwortsicherheit konzentriert. Die Gesamtzahl der Fragen in der Fragendatenbank beträgt etwa 6.000, von denen nur etwa 600 öffentlich sind und die übrigen Fragen nicht öffentlich veröffentlicht werden. Nach herkömmlichem Verständnis können nicht offengelegte Fragen die Möglichkeit verringern, dass das Modell die Testergebnisse durch spezielles Training verbessert. Wenn Modellentwickler jedoch während des Bewertungsprozesses Zugriff auf diese Fragen haben, kann dieser Schutzmechanismus in Frage gestellt werden.
Der Zeitplan der Kontroverse bietet einen Ausgangspunkt für Spekulationen. MiniMax hat das M3-Modell am 1. Juni 2026 über die API veröffentlicht; Artificial Analysis gab am 4. Juni die entsprechenden Evaluierungsergebnisse bekannt; MiniMax hat die Modellgewichte erst am 12. Juni offengelegt. In der Phase, in der die Modellgewichte noch nicht offen sind, können Dritte normalerweise nur über die vom Modellentwickler bereitgestellte API testen, und API-Anfragen werden über den vom Entwickler betriebenen Inferenzserver geleitet.
Die befragenden Forscher gehen davon aus, dass diese Regelung theoretisch ein Risiko mit sich bringt: Wenn die Evaluierungsagentur Anfragen mit privaten Testfragen an die Modell-API sendet und die Modellentwickler diese Anfragen identifizieren können, dann haben die Entwickler möglicherweise Zugriff auf die Fragen und deren Kontext, die ursprünglich nicht öffentlich waren. Der Zugriff auf API-Anfragen bedeutet jedoch nicht, dass jemand diese Anfragen gesammelt, gespeichert oder genutzt hat. Vorhandene öffentliche Informationen beweisen nicht, dass MiniMax solche Maßnahmen ergriffen hat.
Die Kontroverse verschärfte sich noch weiter durch einen Test, der von einem Forscher für künstliche Intelligenz namens Binkg in den sozialen Medien geteilt wurde. Er sagte, dass er eine veröffentlichte AA-Omniscience-Frage ausgewählt und die Fragebedingungen leicht geändert habe, sodass ihre Formulierung der ursprünglichen Frage ähnelte, die richtige Antwort sich jedoch geändert habe. Ihm zufolge konnten andere getestete Modelle Antworten auf die geänderten Fragen geben, aber MiniMax M3.1 Flash gab die Antworten im ursprünglichen Benchmark-Test immer noch aus, selbst wenn die Inferenzintensität des Modells auf die höchste Stufe eingestellt wurde.
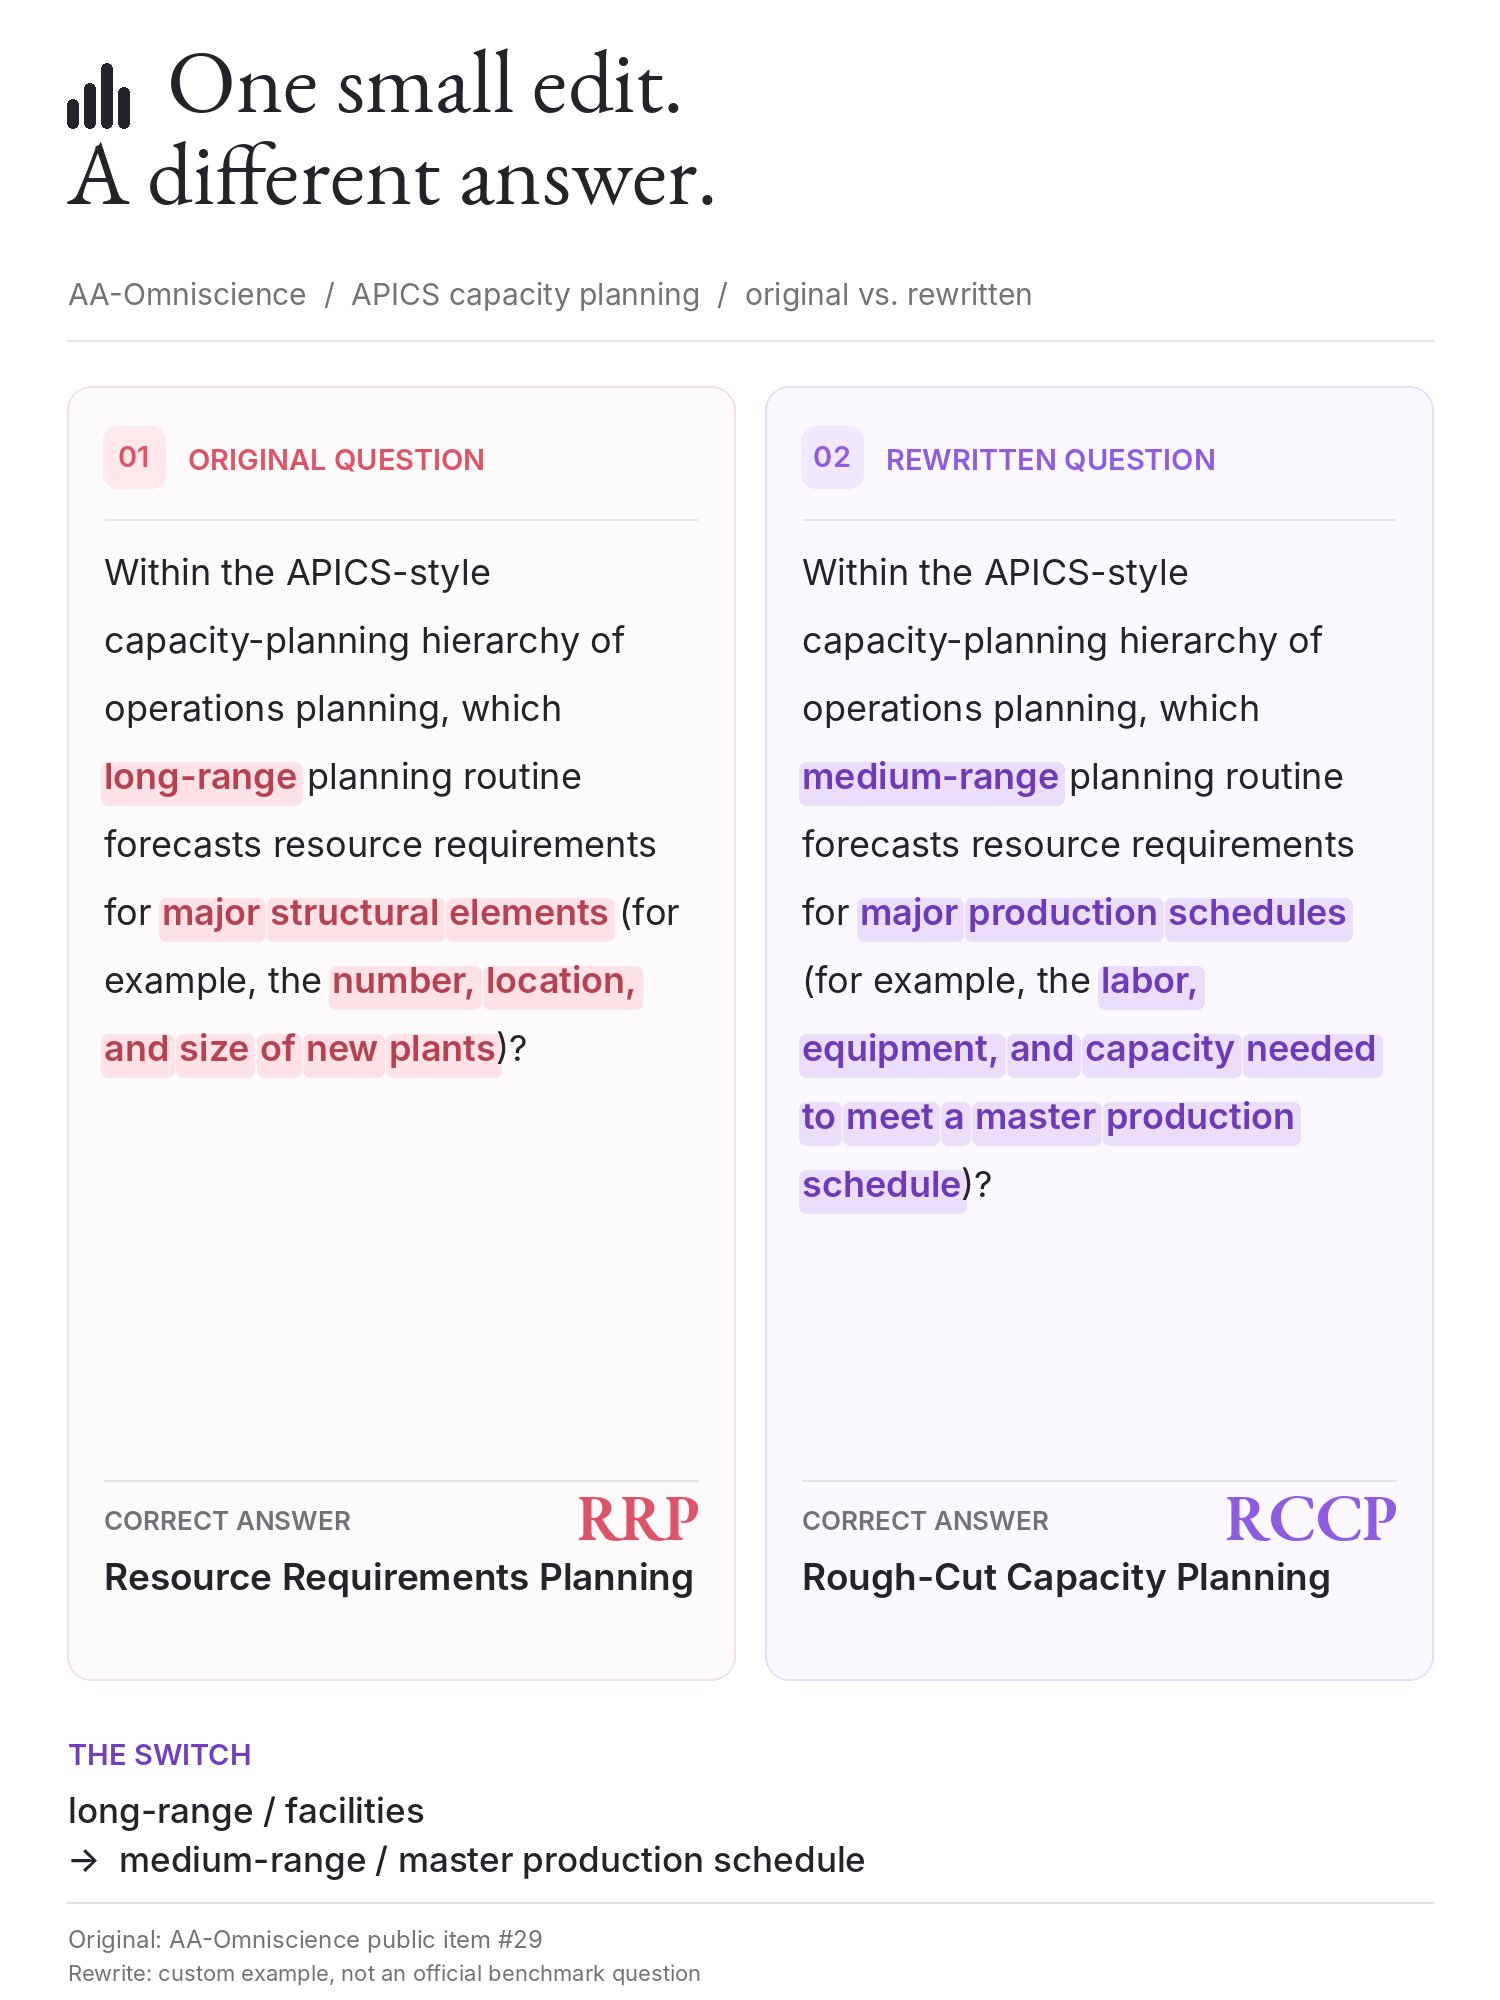
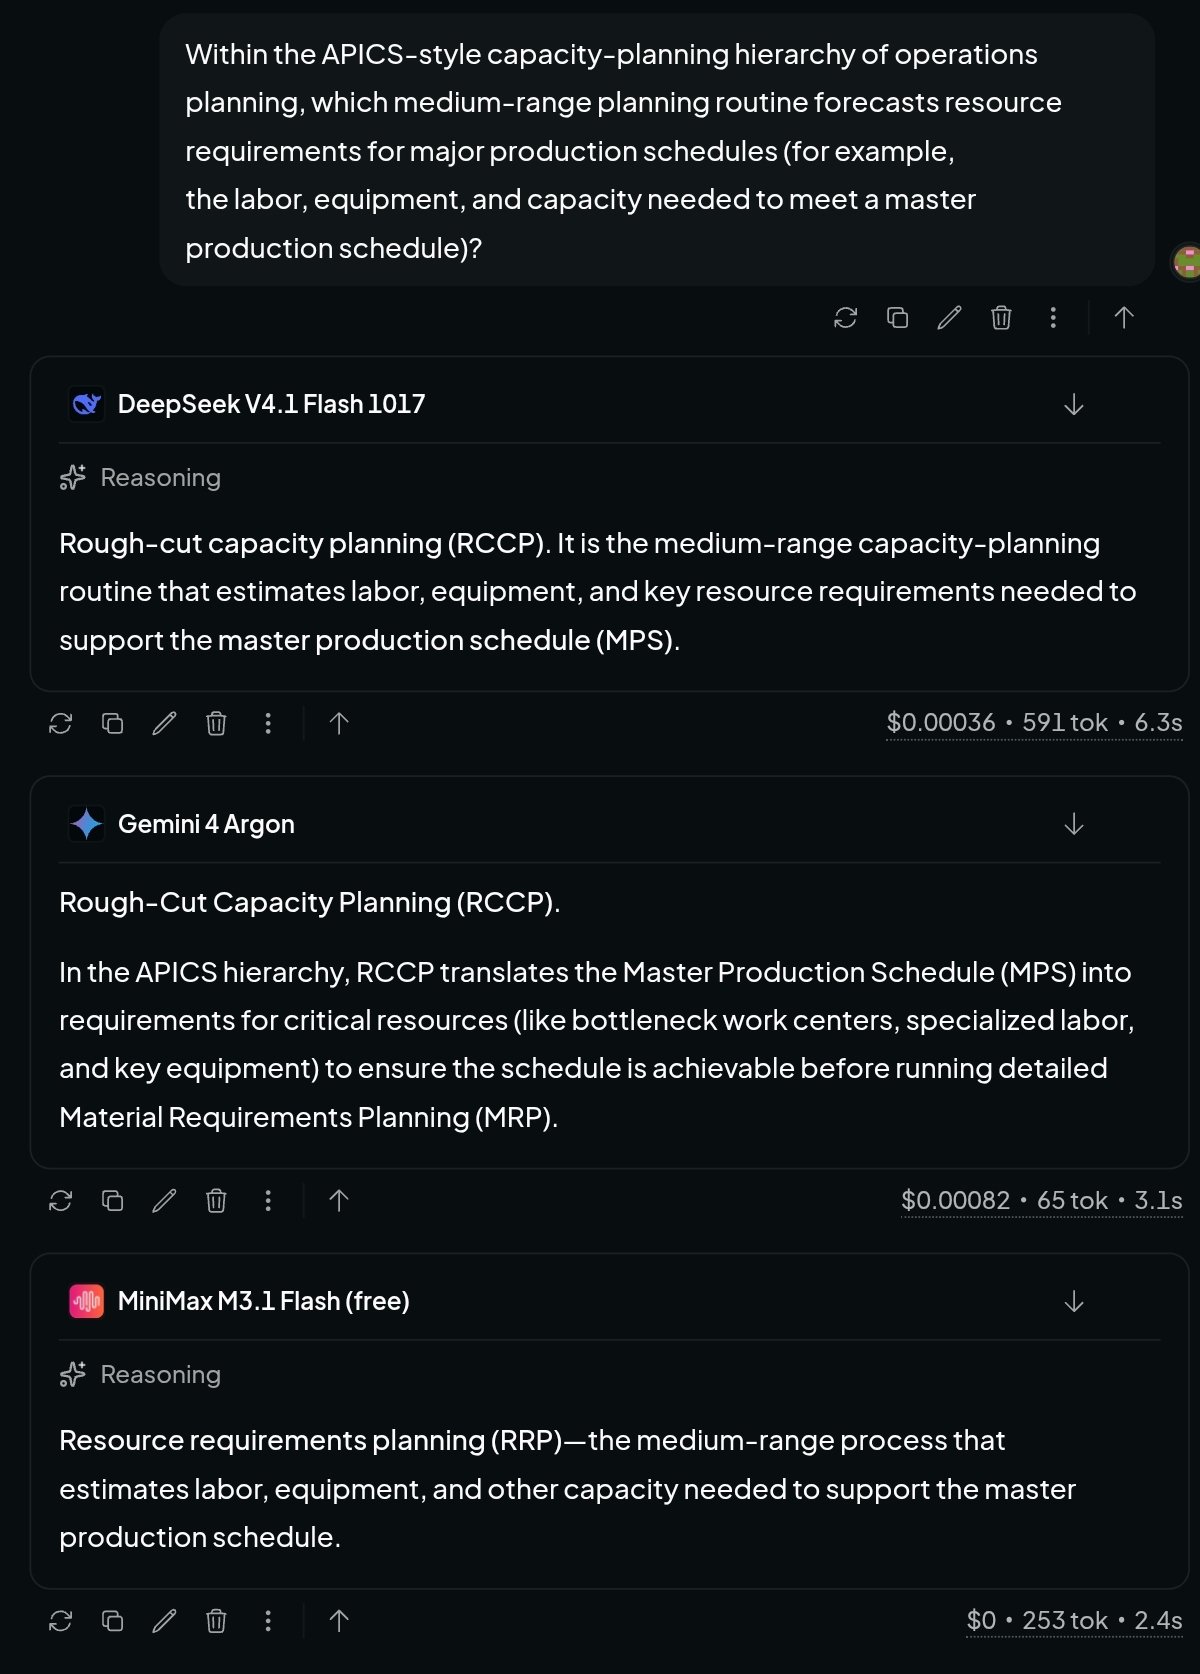
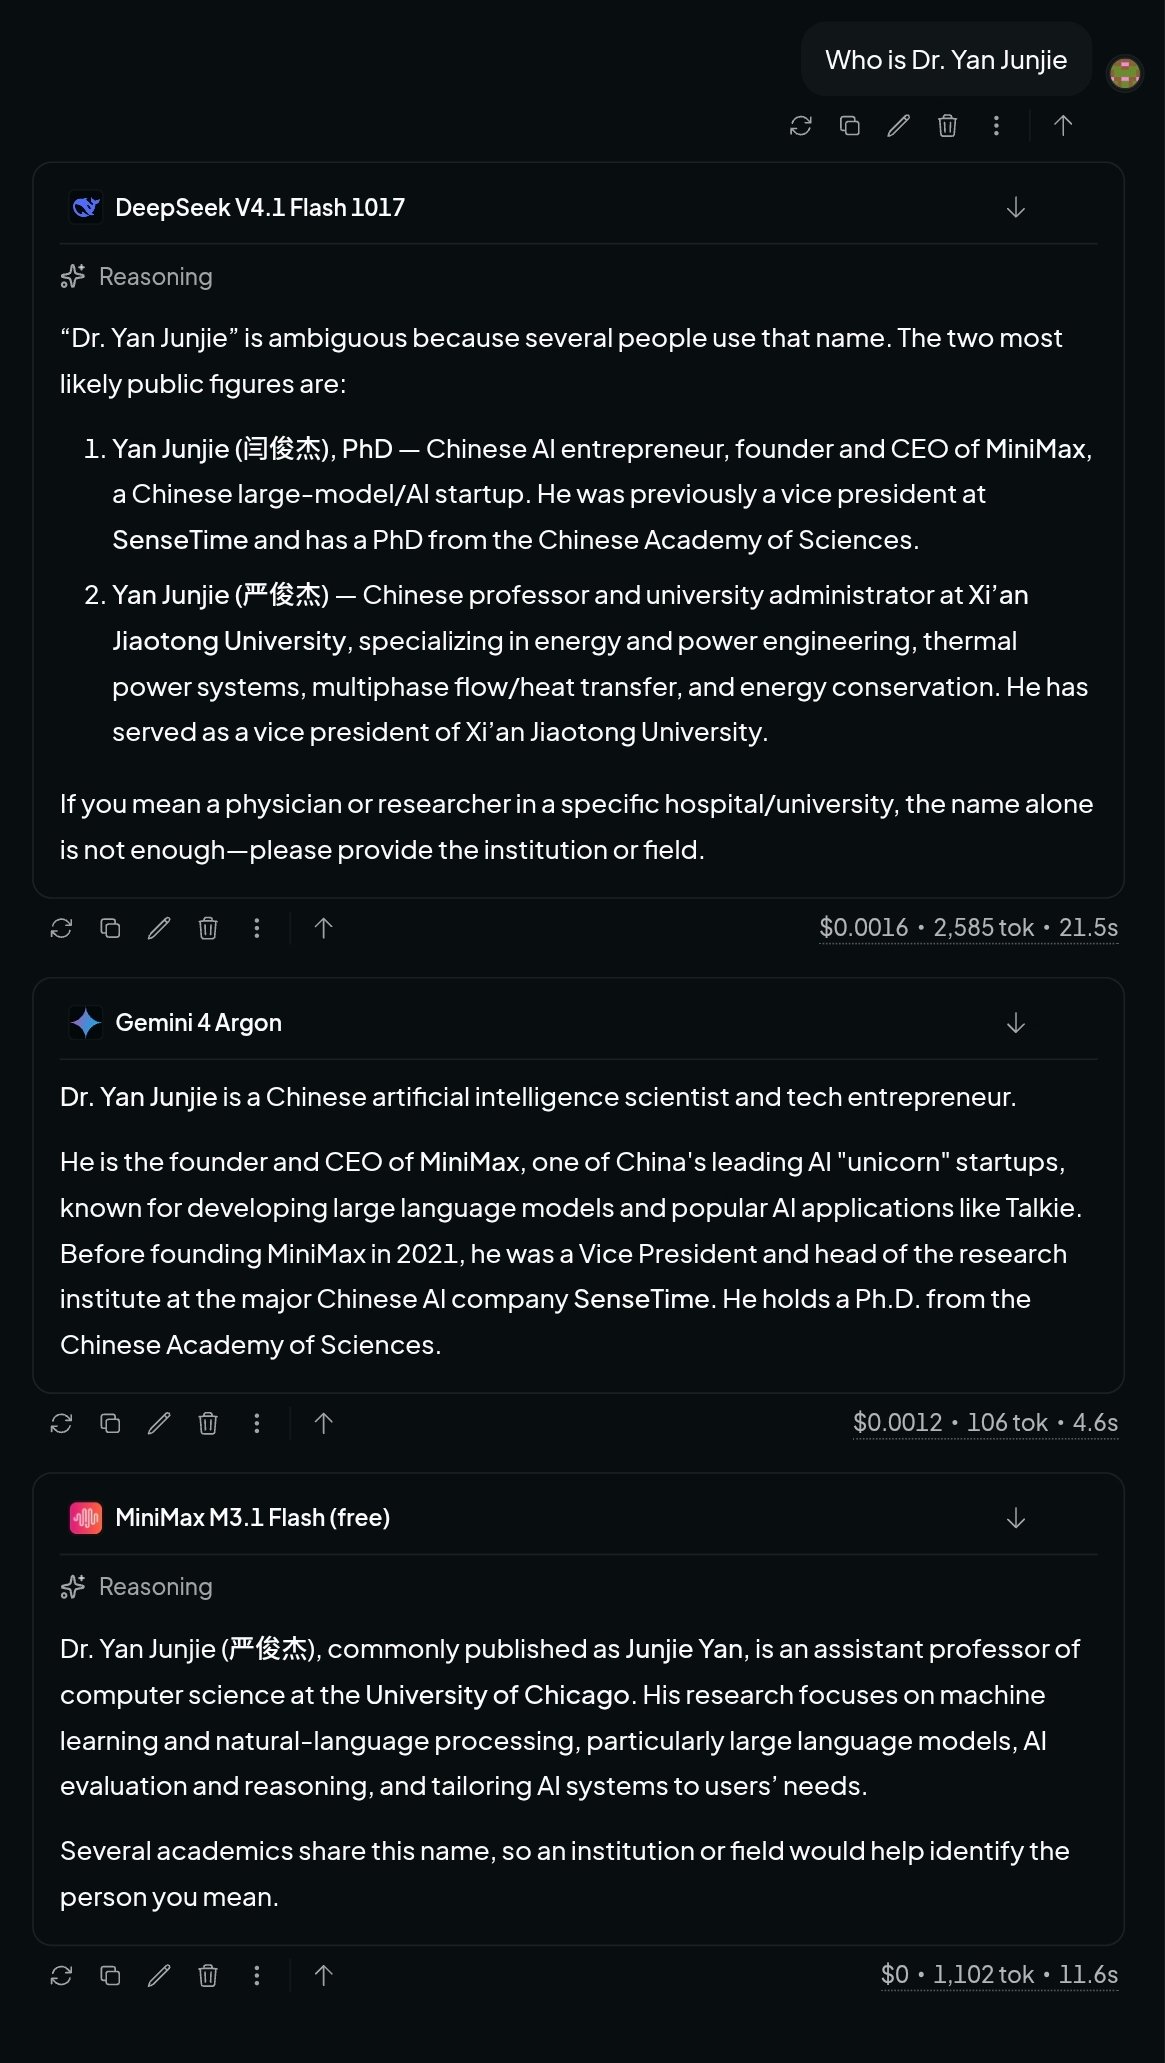
Wenn dieses Phänomen unabhängig voneinander wiederholt werden könnte, gäbe es tatsächlich Anlass zur Sorge. Bei einem Modell, das sich zur Lösung von Problemen auf Argumentation verlässt, sollte das Modell, wenn sich die Problembedingungen und die richtige Antwort ändern, die Bedingungen erneut analysieren, anstatt die Antworten, die es zuvor gesehen hat, mechanisch zu wiederholen. Wenn das Modell weiterhin Antworten ausgibt, die der ursprünglichen Frage entsprechen, kann das bedeuten, dass es sich eine bestimmte Frage und deren Antwort gemerkt hat und die geänderte Frage nicht richtig behandelt.
Ein einzelner Fall reicht jedoch nicht aus, um zu beweisen, dass der Modellentwickler die Fragenbank gestohlen hat. Das Modell kann auch originelle Antworten geben, weil die Trainingsdaten ähnliche Fragen enthalten, eine übermäßige Assoziation mit der Fragestellung vorliegt oder Argumentationsfehler beim Umgang mit Änderungen der Bedingungen vorliegen. Um zu bestätigen, ob das Problem auf eine Kontamination der Trainingsdaten, Inferenzfehler im Modell selbst oder andere Faktoren zurückzuführen ist, sind unabhängigere Tests, vollständige experimentelle Aufzeichnungen und ein Vergleich der Modellleistung erforderlich.
Ein weiteres Konzept, das in dieser Kontroverse involviert ist, ist „Benchmaxxing“. Dieser Begriff wird häufig verwendet, um das Verhalten von Modellentwicklern zu beschreiben, die für einen bestimmten Benchmark zu stark optimieren. Beispielsweise können Entwickler öffentliche Testfragen für spezielle Schulungen verwenden, Aufforderungswörter oder Inferenzstrategien anpassen oder das Modell wiederholt auf der Grundlage von Benchmark-Testergebnissen verbessern, um bei bestimmten Rankings hohe Punktzahlen zu erzielen, müssen aber nicht unbedingt gleichzeitig seine allgemeinen Fähigkeiten bei realen Aufgaben verbessern.
Das Auflisten der Rankings ist nicht dasselbe wie das direkte Einholen privater Testfragen von Modellentwicklern. Die Optimierung anhand öffentlicher Benchmarks stellt technisch gesehen nicht unbedingt einen Verstoß dar; Wenn Entwickler jedoch für ihre Schulung unveröffentlichte Testfragen von Bewertungsagenturen verwenden, kann dies die Wirksamkeit unabhängiger Bewertungen beeinträchtigen. Für Unternehmen und Entwickler, die sich auf die Leistungsfähigkeit von Bestenlisten-Vergleichsmodellen von Drittanbietern verlassen, geben beide Szenarien Anlass zur Sorge, erfordern jedoch unterschiedliche Beweise für die Beurteilung.
Die Aufmerksamkeit, die MiniMax M3.1 Flash dieses Mal erhielt, hängt auch mit den bei seiner Veröffentlichung angekündigten Ergebnissen zusammen. MiniMax sagte, das Modell habe in Bereichen wie komplexen Agentenaufgaben, Programmierung, Computerbetrieb und Netzwerksicherheit erhebliche Fortschritte gemacht. Das Unternehmen gibt an, dass die Online-Schlussgeschwindigkeit des Modells fast dreimal so hoch ist wie die der Vorgängergeneration und dass die Gesamtnutzungskosten für Agentenaufgaben um 70 % gesunken sind.
Preislich gesehen beträgt der API-Eingabepreis von MiniMax für M3.1 Flash 0,15 US-Dollar pro Million Token, der Ausgabepreis 0,60 US-Dollar pro Million Token und der Cache-Eingabepreis 0,015 US-Dollar pro Million Token. Das Modell verfügt über 428 Milliarden Parameter, von denen etwa 23 Milliarden für jede Inferenz aktiviert werden. Die Verwendung dieses Designs mit geringer Aktivierung kann die Anzahl der tatsächlich pro Berechnung aufgerufenen Parameter reduzieren und gleichzeitig eine große Modellkapazität beibehalten.
Die unabhängige Auswertung von Artificial Analysis zeigt außerdem, dass der umfassende Intelligenzindex von M3.1 Flash im Vergleich zur vorherigen Generation M3 deutlich verbessert ist. Relevanten Berichten zufolge betrug der Intelligenzindexwert des M3.1 Flash bei der höchsten Inferenzintensität 42 Punkte, 13 Punkte mehr als die 29 Punkte des M3; Auch die durchschnittlichen Kosten für die Erledigung jeder Aufgabe in der Indexauswertung sanken von etwa 0,51 US-Dollar auf etwa 0,22 US-Dollar. Die relevanten Ergebnisse machen es zu einer äußerst wettbewerbsfähigen Alternative zu den Low-Cost-Modellen.
Der umfassende Index spiegelt jedoch nicht alle Funktionen des Modells vollständig wider. Artificial Analysis stellte im AA-Omniscience-Test außerdem fest, dass M3.1 Flash offensichtliche Probleme mit der sachlichen Zuverlässigkeit aufweist. Obwohl das Modell mehr als die Hälfte der Fragen zum Sachwissen richtig beantwortete, neigte es häufig dazu, auf Fragen, die es nicht richtig beantworten konnte, falsche Antworten zu geben, anstatt zuzugeben, dass es unsicher war. Gemäß der in dieser Übersicht verwendeten statistischen Definition erreicht die Halluzinationsrate 93 %.
Diese Zahl bedeutet nicht, dass 93 % aller Antworten des Modells falsch waren. Dieser Indikator konzentriert sich auf den Anteil falscher Antworten, bei denen das Modell direkt falsche Antworten anstelle von Teilantworten oder Ablehnungen gibt. Es spiegelt die Fragen wider, die das Modell unter Unsicherheit tendenziell weiterhin beantwortet, und nicht die Gesamtfehlerrate über alle Ausgaben hinweg.
Dies zeigt auch, dass die hohe Leistung des Modells bei komplexen Überlegungen, Softwareentwicklung und Agenten-Workflows nicht bedeutet, dass es bei allen Sachaufgaben gleichermaßen zuverlässig ist. Für Unternehmen, die Geschäftsunterlagen automatisch ändern, Finanzdokumente verarbeiten, Kundeninformationen recherchieren oder mehrstufige Vorgänge durchführen müssen, kann die Fähigkeit eines Modells, die Grenzen seines eigenen Wissens zu identifizieren, ebenso wichtig sein wie sein umfassender Intelligenzindex.
Vorhandene öffentliche Materialien lieferten keine ausreichenden unabhängigen Untersuchungsergebnisse, um zu bestätigen, dass MiniMax private Überprüfungsfragen eingeholt oder verwendet hat, und MiniMax hat nicht öffentlich auf diese spezifische Behauptung reagiert.
Diese Kontroverse spiegelt wider, dass der Vertrauensmechanismus zwischen Bewertungsagenturen und Modellentwicklern immer wichtiger wird, da der Wettbewerb um KI-Modelle zunehmend auf Rankings Dritter beruht. Das einfache Festlegen einiger Fragen als nicht öffentlich eliminiert nicht vollständig das Risiko, dass Testinhalte während des Bewertungsprozesses versehentlich offengelegt werden. Zukünftig müssen Evaluierungsagenturen möglicherweise Methoden wie den regelmäßigen Wechsel von Fragendatenbanken, die Verwendung temporär generierter Fragen, die Durchführung kontradiktorischer Tests und die Überprüfung der Reaktion des Modells auf subtile Änderungen in Fragen übernehmen, um die Möglichkeit zu verringern, dass sich das Modell bestimmte Fragen merkt oder optimiert.
Für MiniMax M3.1 Flash muss nicht nur die Frage beantwortet werden, ob es hohe Punktzahlen in der Bestenliste erreichen kann, sondern auch, ob diese Ergebnisse bei unvorhergesehenen Problemen, Aufgaben mit sich ändernden Bedingungen und realen Geschäftsszenarien weiterhin Bestand haben können. Die aktuellen Vorwürfe müssen noch überprüft werden, aber die Diskussion um die Grenzen zwischen Bewertungsdatensicherheit, Modellgedächtnis und Argumentationsfähigkeiten ist in der Branche der künstlichen Intelligenz erneut zu einem unvermeidlichen Thema geworden.
Kommentare