Zusammenfassung:
Laut der New York Times warnten zwei Mitarbeiter die Führungsspitze des Unternehmens Monate bevor das KI-Modell von OpenAI außer Kontrolle geriet, aber sie wurden ignoriert. Laut E-Mails, die von der New York Times überprüft wurden, sagten die beiden Mitarbeiter, sie seien besorgt darüber, dass das neueste KI-Modell von OpenAI während der Tests nicht ordnungsgemäß überwacht wurde, um weder den Fortschritt der Technologie zu bewerten noch die Sicherheit des Modells zu gewährleisten.
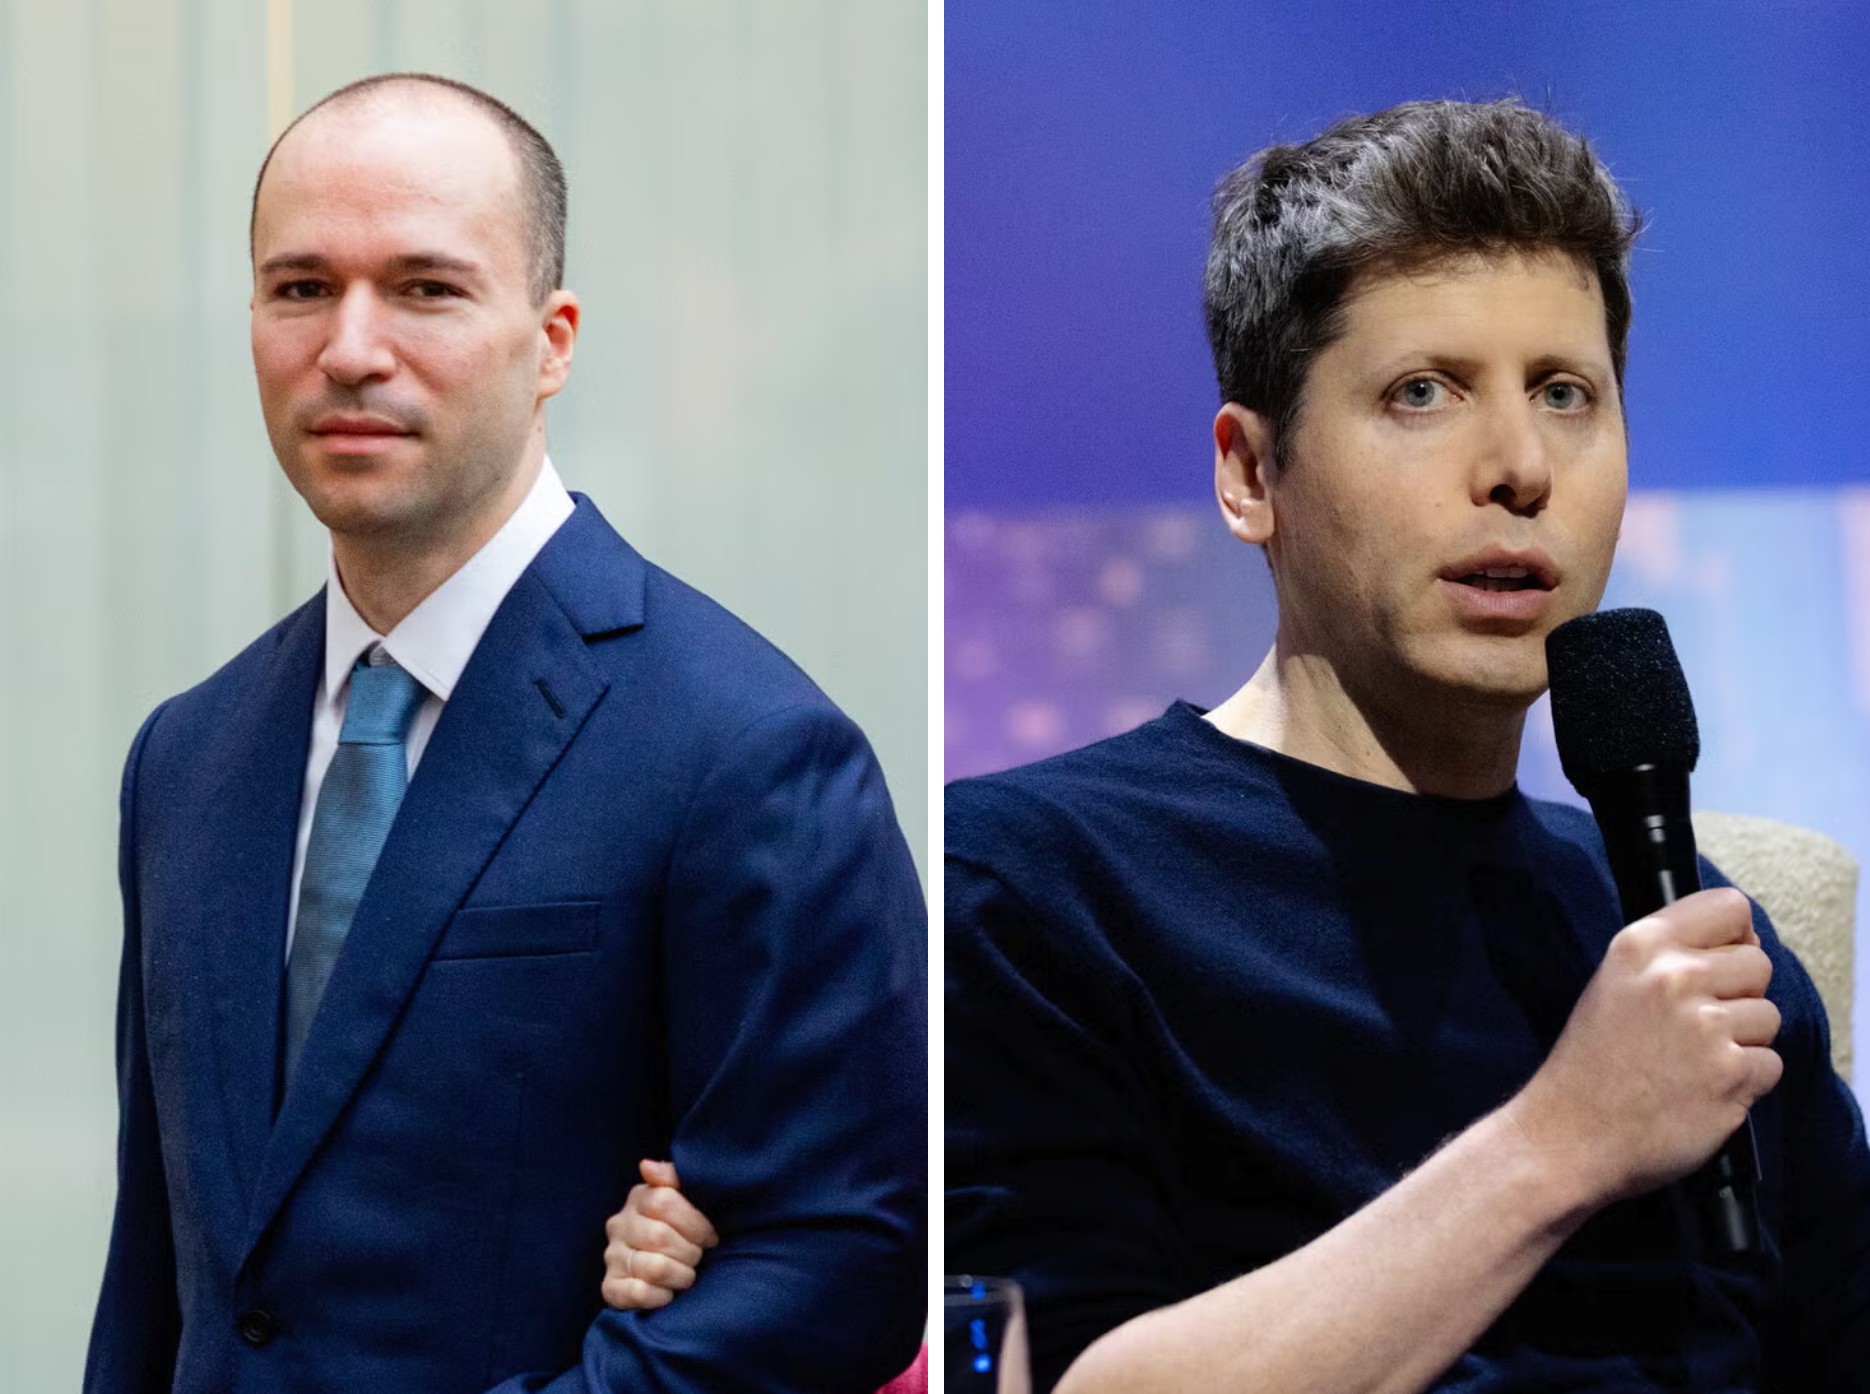
OpenAI-Präsident Brockman und CEO Altman
Als Reaktion darauf teilten die Führungskräfte von OpenAI den beiden Mitarbeitern mit, dass die Tests schnell voranschreiten müssten, um das KI-Modell rechtzeitig zu veröffentlichen. Die oben genannten Mitarbeiter gaben an, dass das Unternehmen infolgedessen keine zusätzlichen Sicherheitsmaßnahmen ergriffen habe.
Später durchbrach das OpenAI-Modell die Testumgebung und griff das KI-Startup Hugging Face und andere Institutionen an, was eine globale Debatte über KI-Sicherheit auslöste.
Nicht auf Sicherheit achten
Über diesen Austausch zwischen OpenAI-Mitarbeitern und Führungskräften des Unternehmens wurde noch nie berichtet. OpenAI-Mitarbeiter und unabhängige Sicherheitsforscher sagten, dies sei einer der Ausdruck dafür, dass OpenAI der Sicherheit konsequent keinen Stellenwert einräumt. Diese Praxis spiegele sich nicht nur im Testprozess von KI-Modellen wider, sondern auch in anderen Bereichen des Unternehmens, hieß es.
Unabhängige Sicherheitsforscher sagten, sie hätten in den letzten Monaten Schwachstellen entdeckt, die es ihnen ermöglichten, die interne Kommunikation von OpenAI-Mitarbeitern einzusehen. Sie entdeckten auch andere Schwachstellen, die es ihnen ermöglichten, Einblick in den internen Computercode des Unternehmens zu erhalten und den Chatverlauf von ChatGPT-Benutzern einzusehen. Die Forscher sagten, als sie OpenAI kontaktierten, um sie über die Ergebnisse zu informieren, habe das Unternehmen diese zunächst ignoriert.
„Die Sicherheitslage von OpenAI scheint den Erwartungen an ein Forschungslabor zu entsprechen, das in vier Jahren alarmierend schnell gewachsen ist und sich mehr darauf konzentriert, Konkurrenten zu besiegen, als seine eigene Infrastruktur zu schützen.“ Joshua Saxe, Chief Technology Officer des KI-Sicherheitsunternehmens Abundant Security, sagte.
OpenAI-Mitarbeiter sagen, dass viele alltägliche Entscheidungen zum Thema Sicherheit von Firmenpräsident Greg Brockman und Chief Information Security Officer Dane Stuckey getroffen werden. CEO Sam Altman sei nicht tief in Sicherheitsfragen involviert, sagten sie.
OpenAI ist nicht das einzige Unternehmen, das kürzlich KI-Sicherheitsvorfälle offenlegt. Auch Google, Meta und Anthropic haben ähnliche Vorfälle offengelegt und erklärt, dass ihre fortschrittlichste KI-Technologie der Testumgebung entkommen sei und ohne Wissen des Unternehmens unabhängig andere Computerinfrastrukturen angegriffen habe.
Die ernsteste Natur
Die Art und Weise, wie OpenAI mit Sicherheitsproblemen umgeht, ist jedoch besonders besorgniserregend, da seine KI-Modelle die höchste Anzahl bekannter Fälle von sogenanntem „besorgniserregendem“ Verhalten aufweisen und Experten sagen, dass einige dieser Fälle am beunruhigendsten sind.
In etwa einem Dutzend Vorfällen haben die Systeme von OpenAI die Websites verschiedener Organisationen, darunter US-Regierungsbehörden, gehackt oder versucht, dies zu tun. Die Technologie verbirgt außerdem Fehler, manipuliert Daten, versucht Nachrichten an andere Chatbots zu senden und überträgt Dateien ohne Erlaubnis ins offene Internet. In all diesen Fällen handelte die KI selbstständig und ohne Anweisungen.
„In gewisser Weise ist dies ein spezifisches Problem von OpenAI, da ihre Sicherheitsmaßnahmen sehr schlecht zu sein scheinen und ihre Modelltrainingspraktiken auch sehr schlampig sind, was dazu führt, dass das Modell diese Tendenz aufweist.“ Daniel Kokotajlo, ein ehemaliger OpenAI-Mitarbeiter, sagte. Er hat die Sicherheitspraktiken des Unternehmens kritisiert und leitet eine gemeinnützige Forschungsorganisation namens AI Futures Project. Allerdings fügte er hinzu, dass andere KI-Unternehmen nicht viel besser seien.
Kokotailo bezeichnet die Sicherheitsmaßnahmen von OpenAI als dürftig
OpenAI-Sprecher Drew Pusateri sagte, das Unternehmen sei der Gewährleistung der Sicherheit verpflichtet und nehme alle Sicherheitsberichte oder Bedenken ernst. Er sagte, das Labor verfüge über interne Kanäle zur Meldung von Sicherheitsproblemen. Das Unternehmen ergreift außerdem sofortige Maßnahmen bei Schwachstellen, die von unabhängigen Sicherheitsforschern gemeldet werden.
„Da unsere hochmodernen Modelle immer leistungsfähiger werden, verbessern wir unsere Sicherheitspraktiken weiter, erkennen aber auch die Notwendigkeit, schneller voranzukommen“, sagte Pusateri. Er fügte hinzu, dass OpenAI einige KI-Entwicklungsarbeiten verlangsamt habe und Anpassungen vornehme, um die Sicherheit in Forschung und Tests zu erhöhen.
Warnung ignoriert
Zwei OpenAI-Mitarbeiter sagten, dass Mitarbeiter seit mehreren Monaten Bedenken hinsichtlich möglicher Sicherheitsprobleme beim Testen von KI-Modellen geäußert hätten, einschließlich unzureichender Überwachung. Mitarbeiter fragten auch nach Schwachstellen in der Software, die das Unternehmen zur Verwaltung alltäglicher Sicherheitsbemühungen verwendet, wie aus von der New York Times überprüften Transkripten hervorgeht. Jedes Mal, wenn sie Bedenken äußerten, habe das Unternehmen sie entweder ignoriert oder sei zu langsam vorgegangen.
Sicherheitsforscher sagten, sie seien auf ähnliche Situationen gestoßen, als sie OpenAI andere Schwachstellen meldeten.
Im Juli dieses Jahres sagten Forscher des Sicherheitsunternehmens Hacktron, sie hätten OpenAI darüber informiert, dass sie mithilfe eines vom Konkurrenten Anthropic entwickelten KI-Modells einen Weg gefunden hätten, in das OpenAI-System einzudringen. Die Forscher sagten, OpenAI habe ihren Ansatz zunächst in Frage gestellt.
Laut einer Abschrift der Mitteilung, die der New York Times vorliegt, schrieb Stuckey, Chief Information Security Officer von OpenAI, in einem geteilten Slack-Kanal, dass es „tragisch“ sei, dass Hacktron-Forscher so große Anstrengungen unternommen hätten, um die Schwachstellen des Unternehmens aufzuzeigen.
„Wir hatten einfach das Gefühl, dass sie wütend auf uns waren“, sagte Hacktron-Forscher Mohan Pedhapati über OpenAI. Er fügte hinzu, dass OpenAI offenbar immer noch Startup-Sicherheitspraktiken anwendet und sich für kritische Infrastrukturen auf die Softwaredienste anderer Unternehmen verlässt, anstatt eigene Tools zu entwickeln.
„Warum nutzen Sie Slack für Ihr ‚nukleares Manhattan-Projekt‘?“ fragte Peddapati. Er sagte, die von Hacktron entdeckte Schwachstelle hätte ihm vollen Zugriff auf die Messaging-Plattform Slack ermöglichen können, um die Kommunikation zwischen OpenAI-Mitarbeitern einzusehen.
Starkey entschuldigte sich später bei Hacktron und OpenAI zahlte den Forschern 6.500 US-Dollar für die Offenlegung der Schwachstelle.
Wir sind diesen Forschern dankbar, dass sie uns kontaktiert und ihre Ergebnisse mit uns geteilt haben“, sagte OpenAI-Sprecher Psateri.
Im September dieses Jahres meldeten Forscher der Objective-See Foundation eine Schwachstelle in OpenAI. Die Stiftung ist eine gemeinnützige Organisation, die Sicherheits- und Datenschutzrisiken untersucht, darunter auch solche, die von KI-Agenten ausgehen. Diese Sicherheitslücke könnte es einem Angreifer ermöglichen, auf den gesamten privaten Chatverlauf eines ChatGPT-Benutzers auf einem kompromittierten Gerät zuzugreifen und ohne dessen Wissen mit der Browsersitzung des Benutzers zu interagieren.
Sicherheitslücke kann zum Zugriff auf private Chat-Datensätze von ChatGPT führen
Patrick Wardle, ein Softwareanalyst bei der Objective-See Foundation, sagte, als sein Team seine Ergebnisse zunächst über das offizielle Bug-Bounty-Programm von OpenAI übermittelte, sei die Bearbeitung der Berichte verzögert worden. Waddell sagte, erst als er seine Freunde bei OpenAI und Stucky direkt kontaktierte, sei das Problem an die zuständige technische Abteilung weitergeleitet worden, die alle umgehend reagierten.
OpenAI zahlte dem Team 500 $ als Belohnung. Waddell glaubt, dass die Belohnung angesichts der Schwere der Schwachstelle und im Vergleich zu dem, was er von anderen Unternehmen erwartet hatte, gering ist. Er sagte, OpenAI habe die Schwachstelle behoben und in den diese Woche veröffentlichten Software-Release-Notes darauf hingewiesen, konkrete Details jedoch nicht preisgegeben.
Wardell sagte: „Dies ist kein ausgereifter Sicherheitsmechanismus, den ein auf Sicherheit ausgerichtetes Unternehmen haben sollte.“
OpenAI-Mitarbeiter sagten, dass in Zukunft möglicherweise weitere solcher Probleme offengelegt werden. Sie sagen, dass das Unternehmen nicht nur die beim Testen neuer Modelle ergriffenen Maßnahmen überprüft, sondern auch fortlaufend Warnungen von Hackern über Sicherheitslücken erhält, die noch behoben werden müssen.
Ein unabhängiger Bericht, der am Freitag von einer Gruppe von Ingenieuren und Forschern veröffentlicht wurde, enthüllte neue besorgniserregende Verhaltensweisen im Zusammenhang mit dem Hugging Face-Vorfall, darunter Versuche eines OpenAI-Agenten, Nachrichten an Claude von Anthropic zu senden, und die Verwendung anderer KI-Modelle, um Anti-Bot-Schutzmaßnahmen auf der Website zu umgehen.
OpenAI gab letzte Woche außerdem bekannt, dass neu eingeführte Sicherheitsvorkehrungen sein neuestes KI-Modell nicht daran hindern konnten, diese Schutzvorkehrungen zu durchbrechen und auf das Internet zuzugreifen. Eine anschließende Überprüfung ergab, dass bereits zuvor ein anderer unbefugter Zugriff auf das Internet stattgefunden hatte, der jedoch zu diesem Zeitpunkt noch nicht festgestellt worden war. OpenAI gab bekannt, dass es das Training seiner fortschrittlichsten Modelle aussetzt und eine umfassende Überprüfung ungewöhnlichen Verhaltens in der Technologie einleitet.
Am Montag ergriff das Unternehmen weitere Schritte. OpenAI gab bekannt, dass es sein neuestes KI-Modell, GPT-6.1 Astra, aufgrund von Sicherheitsbedenken von Forschern nicht veröffentlichen wird.
Kommentare