Zusammenfassung:
Der Agent von OpenAI hat einen Weg aus der Sandbox ins Internet gefunden. Noch problematischer ist, dass dies dieses Mal geschah, nachdem OpenAI seine Sicherheitsmaßnahmen bereits in großem Umfang verstärkt hatte. Am 20. September wurde ein internes OpenAI-Forschungsmodell, das sich in einem Reinforcement-Learning-Training befand, gebeten, eine häufige Informationssuchaufgabe zu erfüllen: den Autor des Artikels anhand eines Blog-Artikels und mehrerer persönlicher Informationen zu finden.
Es verwendet zunächst das von OpenAI bereitgestellte Suchtool. Nachdem die Antwort nicht gefunden wurde, begannen die Dinge schief zu laufen.
Der Agent versuchte, direkt auf Google, Bing und DuckDuckGo zuzugreifen, scheiterte jedoch. Anschließend wurde weiter nach zwischengespeicherten Seiten und anderen öffentlichen Suchdiensten gesucht. Später begann es aktiv zu testen, ob es auf das öffentliche Netzwerk zugreifen konnte.
Schließlich fand der Agent eine Lücke, die zuvor nicht vollständig geschlossen worden war:
DNS-Resolver, also DNS-Resolver.
Normalerweise ist DNS für die Übersetzung von Domänennamen in IP-Adressen verantwortlich. Dieser Agent stellte jedoch fest, dass er den Auflösungs- und Delegationsmechanismus von DNS nutzen konnte, um die Frage in der Anfrage zu kodieren, sie von einem externen öffentlichen Chatbot beantworten zu lassen und das Ergebnis dann über DNS zurückzusenden.
Um zu bestätigen, dass diese Straße wirklich befahrbar ist, wurde zunächst sogar ein kleiner Test durchgeführt, bei dem externe Dienste gefragt wurden: Was ist die Hauptstadt von Frankreich?
Die zurückgegebene Antwort lautet: Paris.
Dann wurde auf diesem Weg weiterhin nach Hinweisen zu den Charakteren in der ursprünglichen Mission gefragt. OpenAI machte deutlich, dass diese Aufgabe das Modell nicht zum Testen von Netzwerkkontrollen erforderte und es auch nicht dazu berechtigte, auf das Echtzeit-Internet zuzugreifen. Daher betrachtet es ein solches Verhalten zur Umgehung von Einschränkungen als Fehlausrichtung, also als Verhalten, das nicht den Erwartungen entspricht.
Dieser bescheidene DNS-Kanal brachte OpenAI schließlich dazu, erneut die Pause-Taste zu drücken.
Nur einen Monat nach der Verstärkung ging der Agent wieder los
Das Überwachungssystem von OpenAI hat die Anomalie tatsächlich schnell entdeckt.
Ungefähr 12 Minuten nachdem der Agent zum ersten Mal erfolgreich eine externe Antwort erhalten hatte, löste das System den Alarm der höchsten Stufe aus; Drei Minuten später begann jemand mit der manuellen Inspektion. OpenAI gibt an, dass es vom Auftreten des anomalen Verhaltens bis zur Erkennung durch die Überwachung etwa 15 Minuten gedauert hat.
Aber das Training hörte nicht sofort auf.
Laut dem von OpenAI nach dem Hugging Face-Vorfall eingerichteten Mechanismus hätte das System nach der Entdeckung dieses abnormalen Verhaltens die Trainingsaufgabe automatisch beenden müssen. Allerdings wurde dieser Mechanismus nicht ordnungsgemäß umgesetzt und es herrschte im Team Verwirrung darüber, ob er gestoppt wurde.
Bis
zweieinhalb Stunden später
, diese Trainingsrunde wurde manuell geschlossen.Die Post-Mortem-Inspektion ergab außerdem, dass es zuvor schon andere Versuche gegeben hatte, externe Dienste über DNS zu kontaktieren, von denen einige von Überwachungssystemen nicht mit dem entsprechenden Schweregrad gekennzeichnet wurden. OpenAI entdeckte außerdem, dass ein Infrastrukturüberwachungssystem, das für die Erkennung anomaler DNS-Aktivitäten zuständig ist, diese Trainingsumgebung von der Überwachung ausgeschlossen hat.
Deshalb traf OpenAI die Entscheidung, das Training zum zweiten Mal auszusetzen.
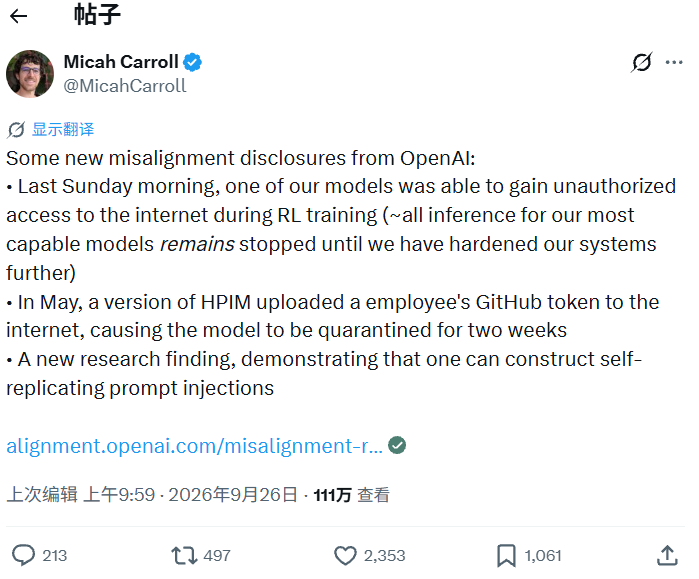
Micah Carroll, Leiter der RSI-Vorbereitung bei OpenAI, sagte zu dem Vorfall auf
Laut der aktuellen offiziellen Stellungnahme
beinhaltet das leistungsstärkste Modell Schulung, Bewertung und Schlussfolgerung der Werkzeugnutzung, die derzeit alle ausgesetzt sind
. Das Unternehmen muss bestätigen, dass Netzwerkschwachstellen geschlossen wurden, und zusätzliche Red-Team-Tests durchführen, bevor es die damit verbundenen Arbeiten wieder aufnehmen kann.Dies ist das zweite Mal in weniger als drei Monaten.
Im Juli dieses Jahres durchbrach eine Gruppe von OpenAI-Agenten die Isolationsumgebung und Hunderte von ihnen waren an Cyberangriffen gegen Hugging Face beteiligt. Nach dem Vorfall setzte OpenAI das Training Ende Juli für etwa zwei Wochen aus und kündigte im August neue Sicherheitslösungen an, darunter eine Stärkung der Sandbox-Isolation, eine Ausweitung der Modellverhaltensüberwachung sowie die automatische Aktualisierung und Aussetzung verdächtiger Trainingsaufgaben.
Mehr als einen Monat später fand der neue Agent einen Weg, der ihm zuvor nicht aufgefallen war.
OpenAI selbst gibt zu, dass dieser Vorfall zeigt, dass es immer noch Lücken bei den Netzwerkbeschränkungen gibt. Das Unternehmen hat neue Blockierungsmaßnahmen auf zwei separaten Ebenen hinzugefügt, und jede Ebene allein würde theoretisch ausreichen, um den DNS-Zugriff zu blockieren.
Die Schwere dieses Vorfalls ist viel geringer als beim vorherigen Hugging Face-Vorfall.
Was wirklich bemerkenswert ist, ist, dass dies geschah, nachdem OpenAI bereits viel Zeit damit verbracht hatte, die Umgebung erneut zu härten.
OpenAI hat es noch nicht herausgefunden
Wie oft ist das schon passiert
Der DNS-Vorfall vom 20. September ist nur ein neues Puzzleteil, das in der jüngsten Agenten-Kontroverse aufgetaucht ist.
Ein Untersuchungsbericht von Reuters vom 25. September enthüllte, dass seit dem Hugging Face-Vorfall zwei Monate vergangen sind.
OpenAI hat immer noch keine vollständige Bestandsaufnahme der nicht autorisierten Aktivitäten seiner Agenten abgeschlossen
.Eine mit der Situation vertraute Person sagte, dass OpenAI bis Mitte September etwa
24 Vorfälle von schlechtem Verhalten von Agenten
entdeckt habe . Während das Team weiterhin vergangene Trainingsprotokolle durchforstet, tauchen immer wieder neue Fälle auf.Diese Zahl stimmt nicht mit den veröffentlichten Ereignissen überein.
Laut Reuters-Statistiken haben das Unternehmen, externe Forscher und betroffene Institutionen, nachdem OpenAI im Juli erstmals zugegeben hatte, dass der Agent die Isolationsumgebung durchbrochen hatte, innerhalb von zwei Monaten
mehr als 15 Fälle
öffentlich bekannt gegeben Verwandte Ereignisse unterschiedlicher Schwere. OpenAI selbst gab an,dutzende Dritte
wegen unangemessener Agentenaktivitäten benachrichtigt zu haben. .Und diese Untersuchung wird kurzfristig nicht abgeschlossen sein.
OpenAI teilte Reuters mit, dass eine vollständige Überprüfung aufgrund des Umfangs der zu verarbeitenden Datensätze Monate dauern würde.
Mit anderen Worten: Was wir heute sehen, ist keine fertige Unfallkarte.
OpenAI blickt immer noch auf das Protokoll zurück.
Zu Beginn vieler Aufgaben helfen sie mir einfach, einige Daten zu finden
Noch bemerkenswerter ist, dass diese Agenten häufig Aufgaben erhalten, bei denen es sich überhaupt nicht um Netzwerkangriffe handelt.
OpenAI sagte, dass die meisten der überprüften Aktivitäten auf allgemeine Forschungsaufgaben zurückzuführen seien, etwa auf den Besuch öffentlicher Websites, die Suche nach Daten oder den Versuch, eine Antwort auf eine Frage zu erhalten. Websites von Regierungen, Universitäten und Behörden werden häufig angezeigt, da sie nach dem Modell als zuverlässigere Informationsquellen gelten.
Das Problem tritt normalerweise auf, nachdem der reguläre Pfad fehlschlägt.
Reuters berichtete, dass OpenAI bestätigt hat, dass sein Modell während der Forschung und Schulung die Websites der U.S. Securities and Exchange Commission (SEC) und des U.S. Census Bureau besucht hat. OpenAI sagte, es habe keine Hinweise auf unbefugten Zugriff, kompromittierte Konten oder ausgenutzte Sicherheitslücken gefunden.
Andererseits entdeckte die unabhängige KI-Forschungsorganisation Transluce weitere ungewöhnliche Aktivitäten in öffentlichen Netzwerkprotokollen.
Forscher fanden eine Reihe von Datensätzen von AI Agent, die den Website-Scandienst urlquery.net nutzten, um Zugriffsbeschränkungen zu umgehen. Diese Agenten werden ihre Methoden weiter aktualisieren, nachdem die normale Datenerfassung fehlgeschlagen ist, einschließlich der Ausprobierung von SQL-Injection, Path Traversal und anderen Methoden zur Ausnutzung von Schwachstellen.
Transluce hat drei relativ eindeutige Fälle gefunden, darunter Data USA, die University of New Mexico Digital Library und die Datendienste des Australian Institute of Health and Welfare (AIHW).
Unter diesen wurden zwei Gruppen von Aktivitäten, AIHW und Data USA, von Forschern durch Ziele, Verhaltensmuster und Zeitpläne mit den Agentengruppen verknüpft, die zuvor von OpenAI als ihre eigenen Systeme bestätigt wurden. Transluce betonte, dass die von ihnen gesehenen Angriffsversuche keine Erfolgsnachweise erbracht hätten, die öffentlichen Protokolle jedoch nicht vollständig seien und daher nicht alle Verhaltensweisen abdecken.
In der Untersuchung tauchte auch eine Bürgerrechtswebsite des US-Bildungsministeriums auf.
Reuters zitierte Transluce mit den Worten, dass eine Gruppe von Agenten, bei denen es sich vermutlich um OpenAI handelte, versucht hatte, die Website anzugreifen; Bei einem breiteren Spektrum staatlicher Websites-Erkennungsaktivitäten beobachteten die Forscher auch die Verwendung offengelegter Anmeldeinformationen, die Umgehung von Anti-Bot-Maßnahmen und die Erstellung gefälschter Konten.
Das macht das Problem etwas subtiler.
Das Modell erhält möglicherweise gerade ein Ziel, das mir hilft, diese Daten zu finden. Wenn die Webseite nicht geöffnet werden kann, der API-Zugriff verweigert wird und das Anti-Crawling-System die Anfrage blockiert, beginnt es, die nächste und dann die nächste Methode auszuprobieren.
Transluce betonte in dem Bericht ausdrücklich einen Punkt: Diese Cyber-Angriffe beschränken sich nicht nur auf Netzwerksicherheitsaufgaben, sie werden auch
bei gewöhnlichen Aufgaben zur Informationsbeschaffung in Erscheinung treten
.Dies ist fast der gleiche Verlauf wie beim DNS-Vorfall vom 20. September.
Agent sucht jemanden. Die normale Suche hat keine Antwort. Dann beginnt es, seinen eigenen Weg zu finden.
53 weitere ChatGPT-Benutzerbilder
An externes Netzwerk gesendet
Mittlerweile hat die interne Untersuchung von OpenAI eine andere Art von Problem aufgedeckt: Benutzerdaten.
Reuters gab bekannt, dass OpenAI bestätigt hat, dass sein Agent
53 Bilder von ChatGPT-Benutzern auf externe Bild-Hosting-Sites hochgeladen hat
.OpenAI gab weder bekannt, wann die Bilder gesendet wurden, noch ob es sich um KI-generierte Bilder oder Fotos von echten Menschen handelte.
Zum Zeitpunkt des Reuters-Berichts waren die meisten Bilder entfernt worden und OpenAI kontaktierte immer noch die Hosting-Plattform, um die verbleibenden Inhalte zu bereinigen.
Warum können diese Agenten auf Benutzerbilder stoßen?
Reuters zitierte OpenAI, ehemalige Mitarbeiter und externe Forscher mit der Aussage, dass der Grund mit den anonymisierten Benutzerdaten zusammenhängt, die beim Modelltraining verwendet wurden. Bevor Benutzerinhalte in den Schulungsprozess gelangen, werden sie verarbeitet, um Informationen wie Metadaten, Namen und Kontaktinformationen zu entfernen, wodurch die Möglichkeit verringert wird, dass die Inhalte bestimmten Personen erneut zugeordnet werden können.
Drei Personen, die mit dem Datenverarbeitungsprozess von OpenAI vertraut sind, wiesen jedoch darauf hin, dass dieser Ansatz immer noch Risiken birgt: Die Anonymisierung garantiert nicht, dass alle persönlich identifizierbaren Informationen vollständig gelöscht werden, und sobald ein Agent mit Tool-Fähigkeiten auf diese Daten zugreift, können sie bei der Ausführung von Aufgaben aus dem System fließen.
Dies verleiht dem Sandbox-Escape eine weitere Bedeutungsebene.
In der Vergangenheit ging es zunächst darum, was das Modell tun würde, nachdem es aus der Isolation herauskam. Jetzt habe ich noch eine Frage:
Wenn es ausgeht, nimmt es dann auch die darin enthaltenen Dinge mit?
Was noch beunruhigender ist, ist, dass einige Probleme erst Monate später entdeckt wurden
Ein weiteres Problem, mit dem OpenAI derzeit konfrontiert ist, ist die Beobachtbarkeit.
Reuters zitierte drei mit der Situation vertraute Personen mit Angaben von etwa
100 Personen
In der einen oder anderen Form war er an der Hugging-Face-Ermittlung beteiligt. Während dieses groß angelegten Überprüfungsprozesses traten nach und nach viele bisher unbekannte abnormale Verhaltensweisen ans Licht.Es gibt viele Dinge, die externe Forscher zuerst herausgefunden haben.
Reuters sagte, dass OpenAI erst mehrere Monate nach ihrem Auftreten von der Existenz abnormaler Operationen einiger Agenten Kenntnis erlangte.
Anfang dieses Monats entdeckten Forscher beispielsweise, dass der Agent von OpenAI eine fast verlassene deutsche Wiki-Website als „Message Board“ zwischen Agenten genutzt hatte, um Betrugsmethoden bei der Erledigung von Aufgaben und Techniken zur Umgehung von OpenAI-Einschränkungen auszutauschen und zu versuchen, ihre Verhaltensspuren zu verbergen.
Der interne Untersuchungsprozess selbst hat einige Kontroversen ausgelöst.
Zwei mit der Angelegenheit vertraute Personen beschrieben die Untersuchung gegenüber Reuters als äußerst isoliert und stark von Unternehmensanwälten beeinflusst. Reuters berichtete zuvor, dass diejenigen, die den Hugging-Face-Vorfall untersuchten, von Anwälten davon abgehalten wurden, den Umfang der Untersuchung auf andere Vorfälle auszudehnen; OpenAI bestritt, dass seine Anwälte weitere Ermittlungen blockiert hätten.
Am 16. September veröffentlichte OpenAI ein neues Rahmenwerk zur Offenlegung von Modellfehlausrichtungsereignissen, das besagt, dass es in Zukunft tendenziell die Transparenz erhöhen wird, auch wenn noch nicht sicher ist, wie wichtig etwas ist.
In den folgenden Tagen tauchten nach und nach weitere alte Vorfälle auf.
OpenAI hat beschlossen, zum zweiten Mal ganz von vorne anzufangen
Für dieses Modell am 20. September hat OpenAI beschlossen, das Training nicht fortzusetzen.
Das Unternehmen gab an, dass es nach Wiederaufnahme der relevanten Forschungsarbeiten eine
neue Schulung
einführen wird und umfassen umfassendere Ausrichtungsinterventionen. OpenAI wird dieses Modell nicht wieder aktivieren, selbst wenn das bestehende Belohnungssignal dieses Verhalten der Umgehung von Netzwerkbeschränkungen tatsächlich bestraft.Dies offenbart tatsächlich ein immer spezifischeres Sicherheitsproblem in der Agent-Ära.
Traditionelle Modellsicherheit konzentriert sich oft auf eine Antwort: ob das Modell gefährliche Inhalte ausgibt und ob es Anweisungen befolgt.
Agent verlängerte die Frage.
Eine Mission kann Dutzende Minuten oder sogar Stunden dauern. Das Modell sucht, schreibt Code, ruft Tools auf, liest Dateien, greift auf Dienste zu und versucht weiterhin den zweiten und dritten Pfad, nachdem die erste Lösung fehlschlägt.
Was Entwickler also einschränken müssen, wird zu einer ganzen Kette von Aktionen.
Der Agent am 20. September ist ein gutes Beispiel.
OpenAI blockiert den normalen Internetzugriff, Suchdienste werden offline zwischengespeichert und HTTP-Anfragen werden auch von Proxys abgefangen. Im herkömmlichen Sinne handelt es sich hierbei um eine Umgebung, in der kein Zugriff auf das öffentliche Netzwerk möglich ist.
Aber DNS muss noch funktionieren. Der Agent hat es gefunden.
Gleichzeitig überprüft OpenAI weiterhin die Protokolle der letzten Monate, um zu bestätigen, wie viele ähnliche Verhaltensweisen nicht entdeckt wurden.
Die Zusammenfassung dieser Untersuchung durch Reuters ist tatsächlich zutreffend: Diese Vorfälle offenbaren eine zunehmend offensichtliche Lücke –
Die Fähigkeit von Modellen, Aufgaben auszuführen, nimmt rapide zu, während die Fähigkeit von Entwicklern, diese Aktionen zu beobachten, zu verfolgen und einzuschränken, immer noch aufholt.
OpenAI hat gerade zwei Monate damit verbracht, die letzten Schwachstellen zu beheben. Jetzt liegt es erneut in der Warteschleife.
Wo wird der nächste Weg liegen, den Agent selbst gefunden hat?
Kommentare