Zusammenfassung:
Google gab heute offiziell seinen neuesten Durchbruch im Bereich der nativen End-to-End-Sprachinteraktion bekannt und bringt eine neue Generation von Echtzeit-Sprach-Großmodellen auf den Markt: Gemini 3.8 Live und Gemini 3.8 Live Extended Thinking, die speziell für schwierige Aufgaben geeignet sind.
Diese beiden Modelle stellen einen großen Fortschritt im nativen Audio-zu-Audio-Technologiesystem von Google dar. Sie heben nicht nur die Verzögerung und Natürlichkeit von Gesprächen in Echtzeit auf ein neues Niveau, sondern erreichen auch erstmals tiefgreifende mehrstufige Argumentationsfunktionen in Sprachströmen mit geringer Latenz, wodurch sich das Anwendungsparadigma der Sprach-KI in komplexen beruflichen Szenarien völlig verändert.
In der bisherigen Mainstream-Sprachinteraktionsarchitektur mussten KI-Systeme normalerweise einen Kompromiss zwischen „schnell reagierendem, flachem Dialog“ und „langfristigem, tiefem Denken“ eingehen. Bei schwierigen Problemen mussten Benutzer oft lange Zeiträume des stillen Wartens ertragen. Gemini 3.8 Live von Google konzentriert sich auf die Optimierung der ultraschnellen Konversation und des täglichen Streaming-Interaktionserlebnisses. Es kann Benutzern eine äußerst reibungslose und menschliche Echtzeit-Sprachkommunikation mit empfindlicheren Intonationsschwankungen, natürlichen Unterbrechungen und Kontextverständnisfunktionen bieten. Das darauf basierende Gemini 3.8 Live Extended Thinking wurde grundlegend für hochkomplexe Geschäftsabläufe aktualisiert. Dieses Modell verleiht der KI die Fähigkeit, im Hintergrund zu „denken, während sie spricht“ (Denken, während sie spricht), wodurch das System gleichzeitig komplexe mehrstufige Logikzerlegungen, Code-Debugging oder technische Diagnosen im Hintergrund durchführen und dabei einen kohärenten Echtzeitdialog aufrechterhalten kann, ohne dass der Gesprächsrhythmus bei schwierigen Problemen abrupt unterbrochen werden muss.
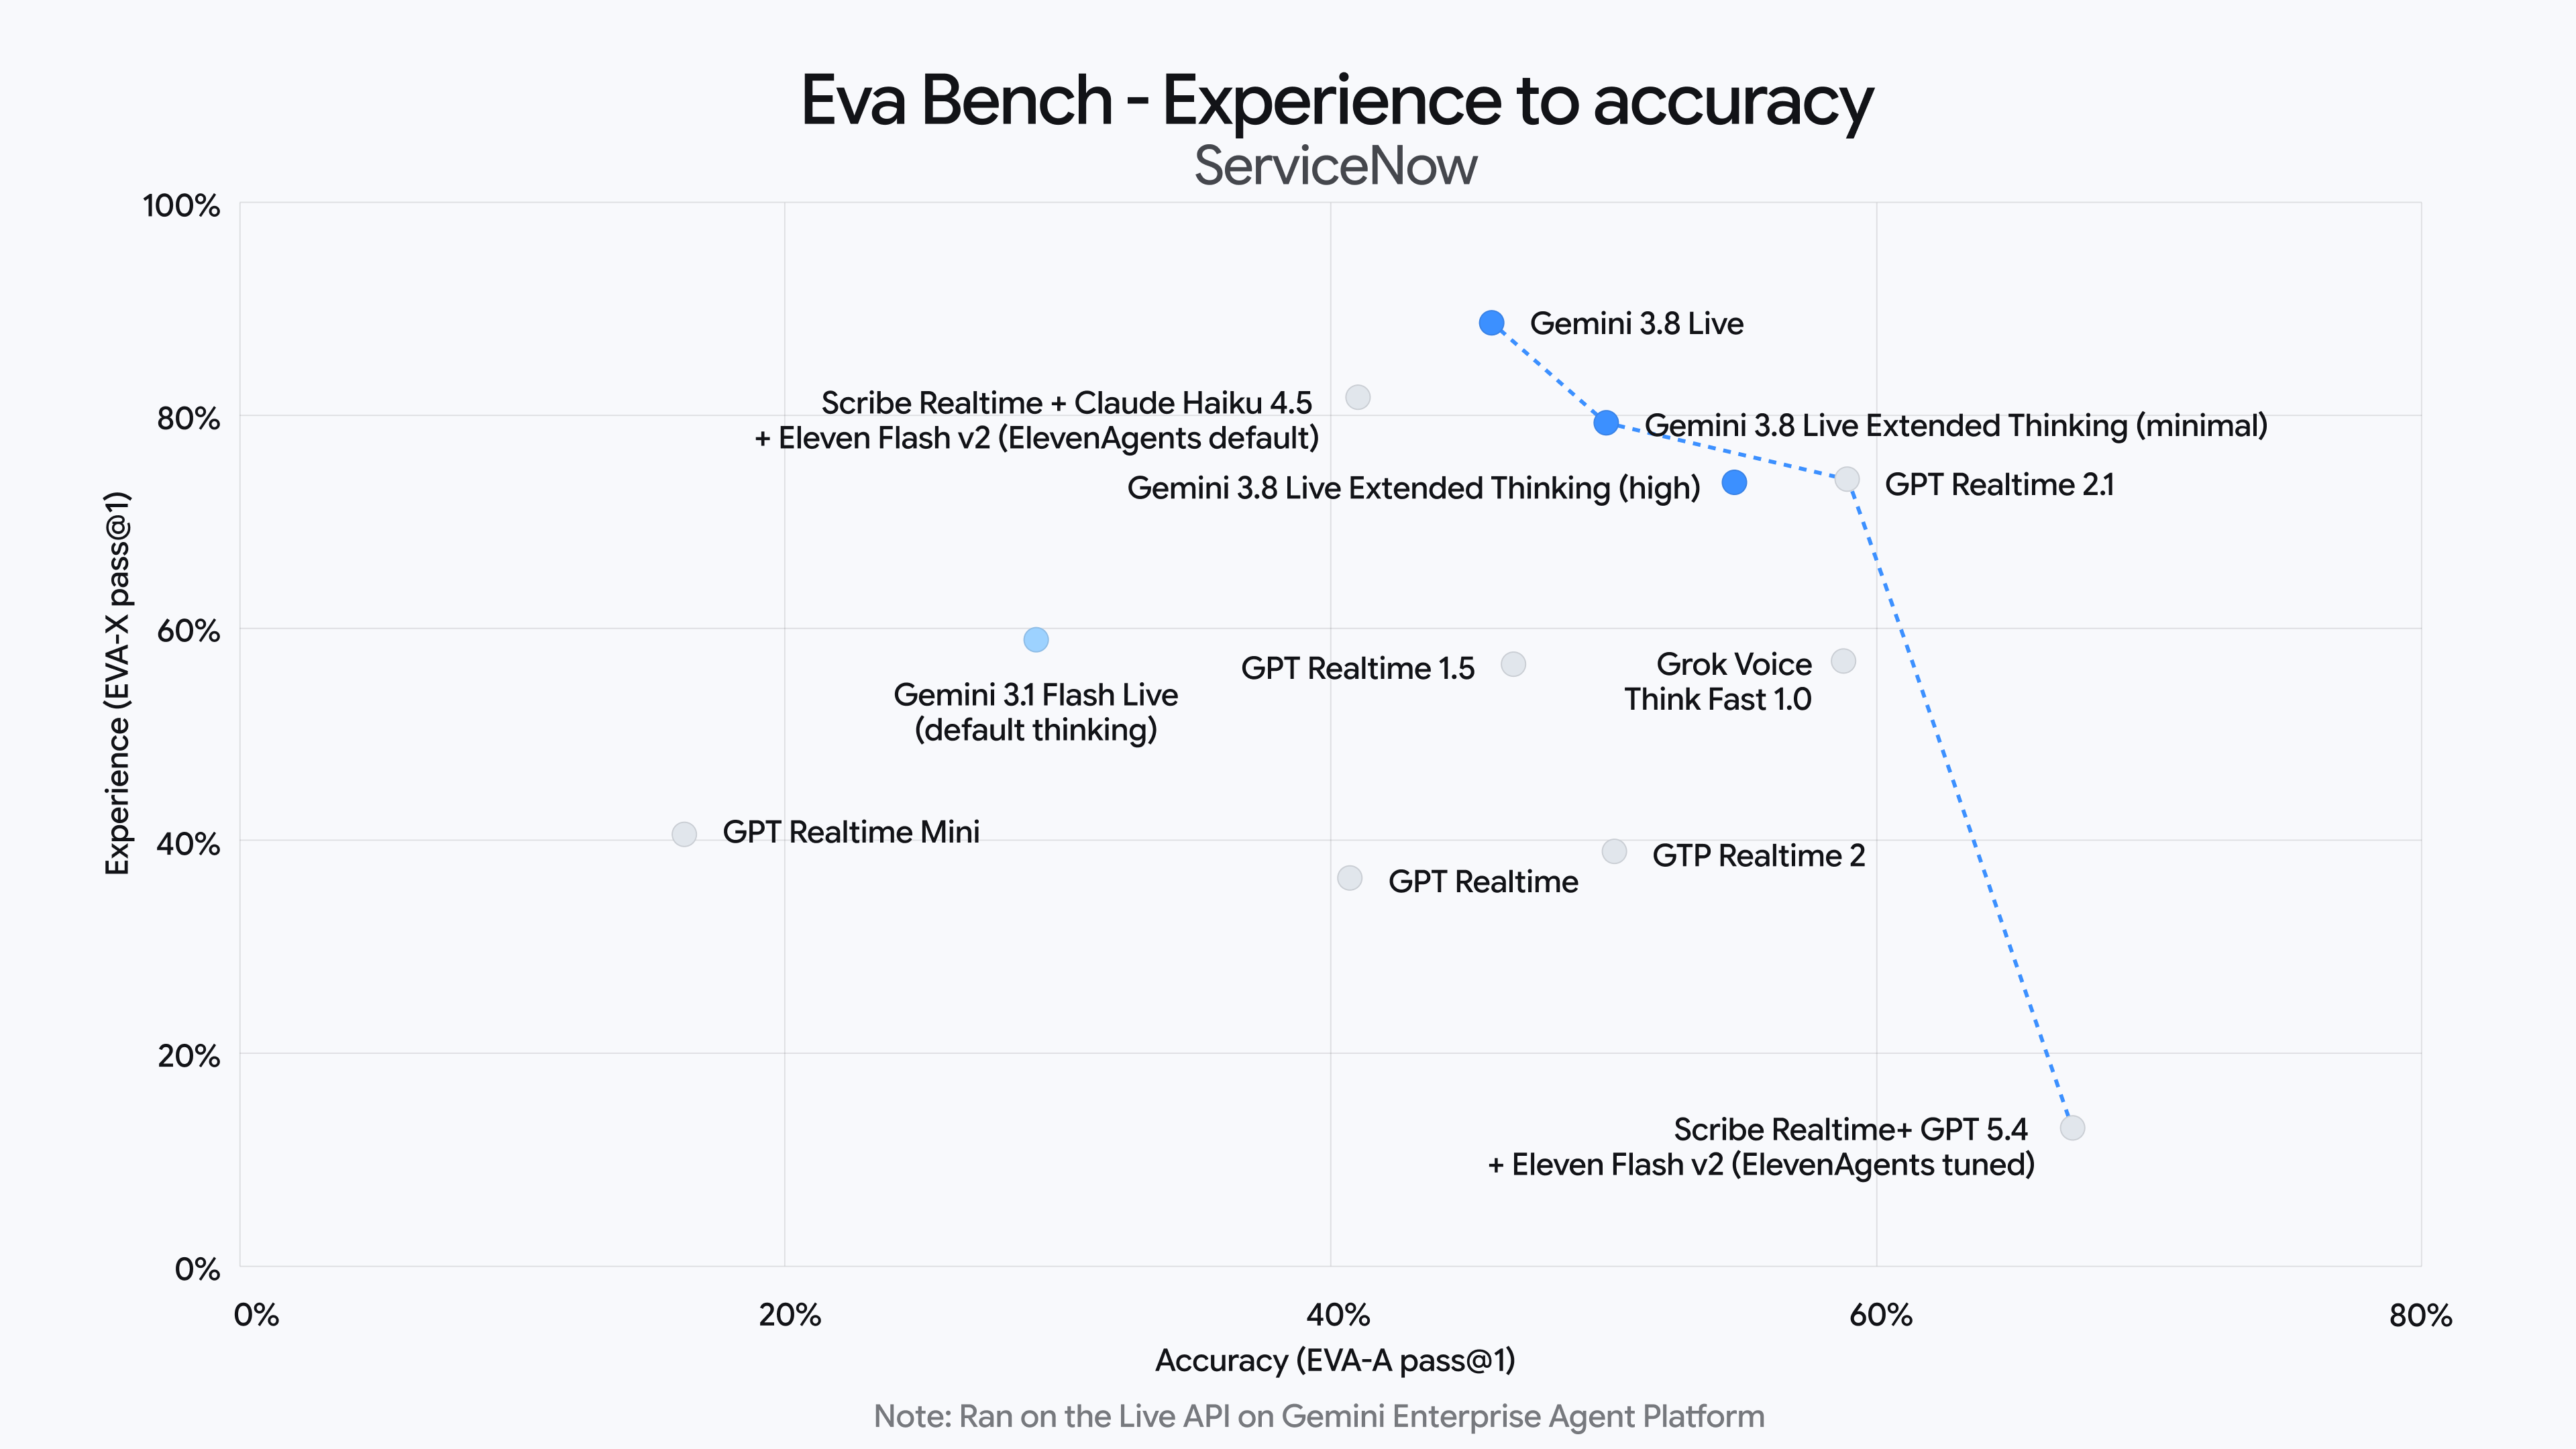
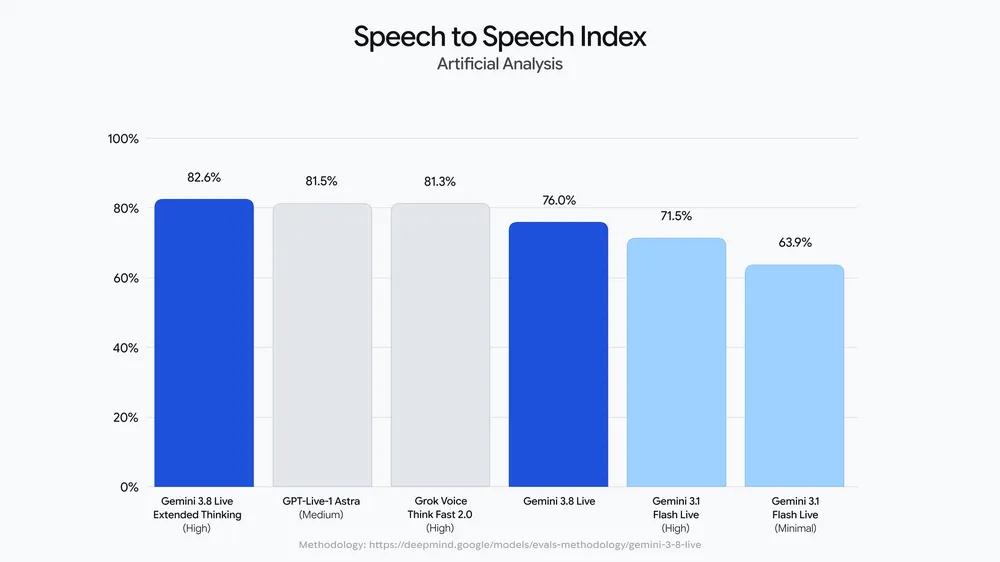
Im praktischen Einsatz wird die neue Modellgeneration der Live-Serie die Leistungsgrenzen von Sprachassistenten deutlich erweitern. Zusätzlich zu alltäglichen natürlichen Gesprächen haben Gemini 3.8 Live und die erweiterten Argumentationsversionen in Szenarien mit hohen intellektuellen Anforderungen, wie z. B. Schritt-Fehlerbehebung in Echtzeit, komplexer mathematischer Ableitung, gleichzeitigem Nachhilfeunterricht in Fremdsprachen in Echtzeit und Multitasking-Streaming-Anweisungsausführung, eine deutlich bessere Leistung als frühere Versionen gezeigt und belegten in mehreren Branchen-Benchmarks für multimodales und sprachlogisches Denken den ersten Platz.
Für Entwickler und Unternehmensnutzer hat Google angekündigt, dass relevante Modellfunktionen ab sofort offiziell für den Zugriff über Gemini API und Google AI Studio zugänglich sein werden. Entwickler können diese native Audio-API-Schnittstelle mit extrem geringer Latenz direkt aufrufen, um schnell Vollduplex-Sprachagentendienste der nächsten Generation mit High-Order-Argumentation-Funktionen in Produktformen wie intelligenter Hardware, Kundenservice, Echtzeit-Programmierunterstützung und kollaborativem Büro zu erstellen.
Kommentare