Zusammenfassung:
XAI, Elon Musks Unternehmen für künstliche Intelligenz, baut seine Rechenzentrumsgröße weiter aus und plant, in den nächsten Jahren mehr als 1,2 Millionen Nvidia-KI-GPUs einzusetzen. Während das Colossus-Rechenzentrum weiter wächst, hofft xAI, das Grok-Modell der nächsten Generation über eine groß angelegte Computerinfrastruktur trainieren und ausführen zu können und einen intensiveren KI-Infrastrukturwettbewerb mit Konkurrenten wie OpenAI zu starten.
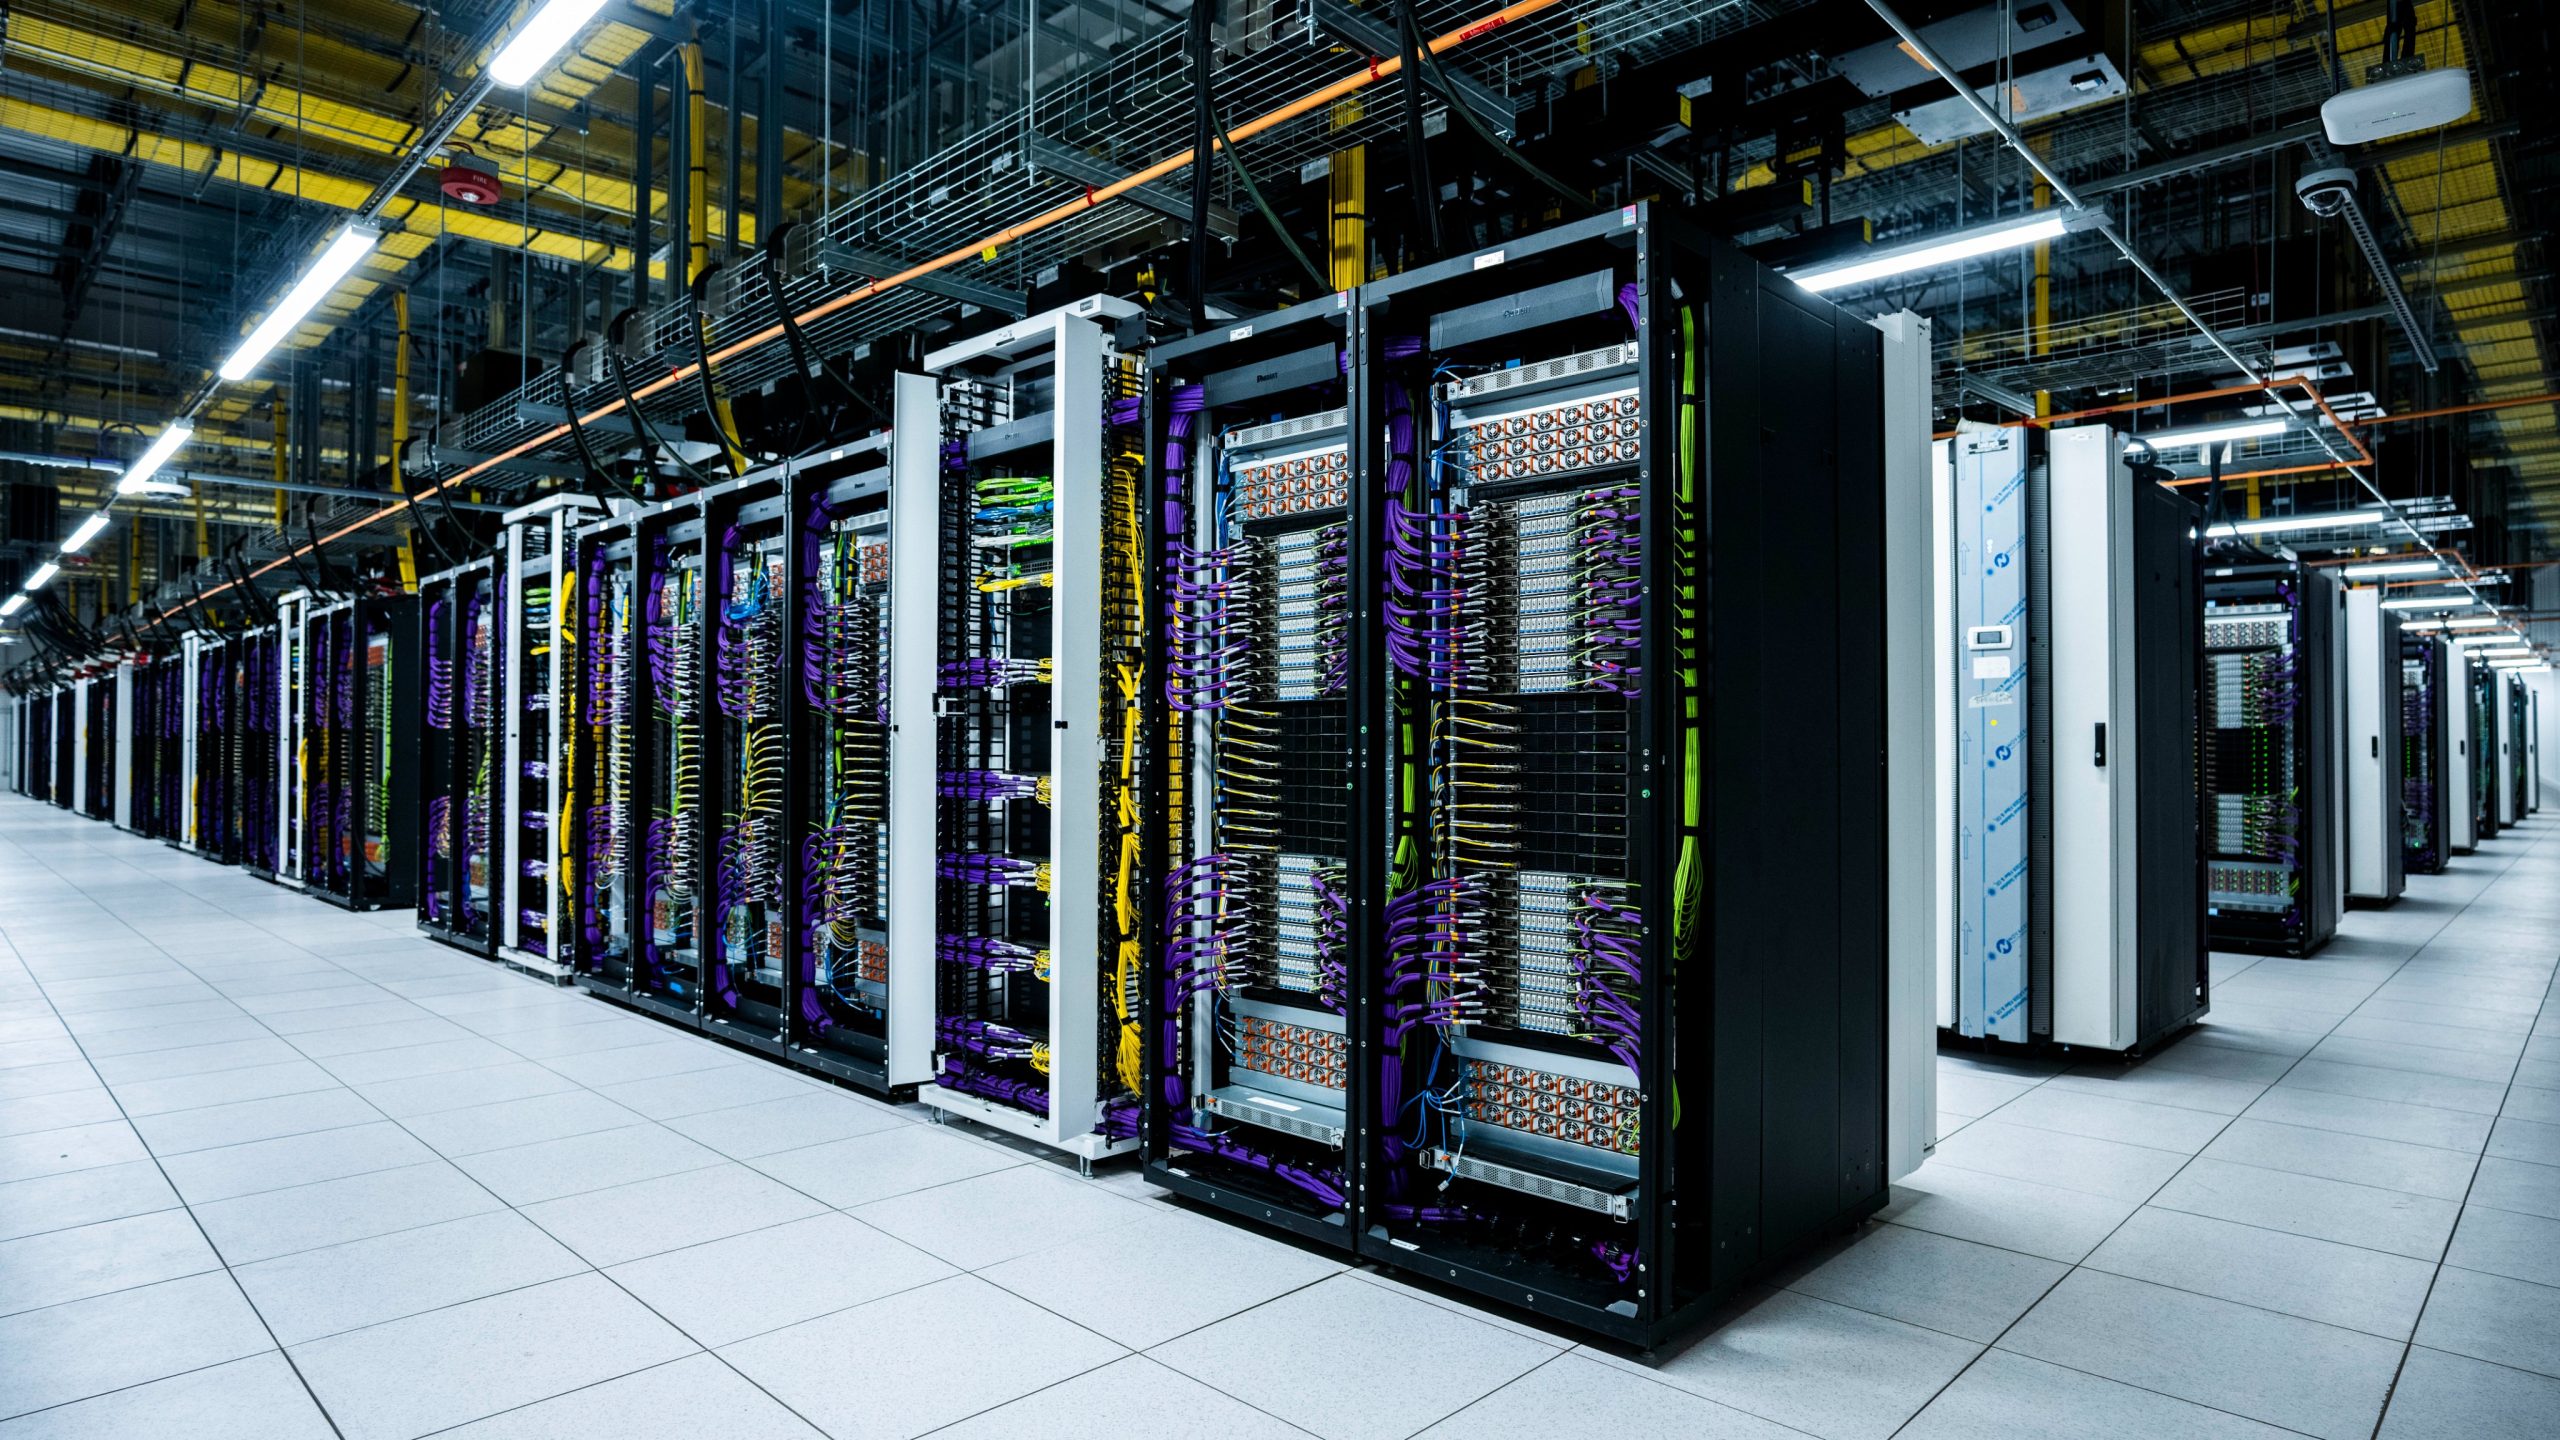
xAIs derzeit größtes KI-Infrastrukturprojekt ist das Colossus-Rechenzentrum in Memphis, Tennessee, USA. Der Bau des Projekts beginnt im Jahr 2024 und die erste Phase, Colossus 1, ist bereits in Betrieb. Musk hat Colossus zuvor als „Rechenleistungs-Superfabrik“ von xAI bezeichnet, deren Hauptziel darin besteht, so schnell wie möglich eine große Anzahl von GPUs zentral bereitzustellen.
Colossus verwendete zunächst NVIDIA H100-GPUs. Der zuvor angekündigte Umfang der ersten Phase beträgt etwa 200.000 H100. Mit der anschließenden Erweiterung hat das Rechenzentrum damit begonnen, fortschrittlichere GPUs der Blackwell-Serie hinzuzufügen. Die neuesten Informationen zeigen, dass Colossus 1 zusätzlich zum ursprünglichen H100 auch etwa 30.000 Nvidia GB200 einsetzt, sodass die aktuelle Anzahl der GPUs in Colossus 1 etwa 230.000 erreicht hat.
xAIs zweite Phase, Colossus 2, ist sogar noch größer. Das Projekt befindet sich ebenfalls in Memphis und plant den Einsatz von mehr als 500.000 NVIDIA-GPUs. Nach aktuellen Plänen wird Colossus 2 eines der weltweit größten KI-Rechenzentrumsprojekte werden und seine Rechenleistung die von herkömmlichen Supercomputern bei weitem übertreffen.
Wenn alle Colossus 1-, Colossus 2- und nachfolgenden Bauprojekte einbezogen werden, wird die Anzahl der NVIDIA-GPUs, die xAI in Zukunft einsetzen will, etwa 1,2 Millionen oder mehr erreichen. Diese Zahl bedeutet nicht, dass alle diese GPUs installiert wurden, sondern entspricht vielmehr dem Gesamtumfang der zukünftigen Erweiterungspläne für das Rechenzentrum von xAI.
Die radikale Ausweitung der Anzahl der GPUs durch xAI steht in direktem Zusammenhang mit der schnell wachsenden Nachfrage nach Rechenleistung für das KI-Modelltraining. Die Parameterskala, die Trainingsdaten und der Reinforcement-Learning-Prozess großer Sprachmodelle erfordern immer mehr Rechenressourcen, und die für das Modelltraining und die Inferenz erforderliche Rechenleistung entwickelt sich vom Maßstab traditioneller Rechenzentren zum Maßstab von Supercomputing-Clustern.
In diesem Fall ist der Besitz einer großen Anzahl von GPUs für KI-Unternehmen zu einer wichtigen Grundlage für die Erweiterung ihrer Modellfunktionen geworden. Musk hat wiederholt betont, dass xAI seine Rechenkapazitäten so schnell wie möglich erweitern und seine Abhängigkeit von Cloud-Computing-Plattformen Dritter durch den Aufbau eigener Supercomputing-Cluster verringern muss.
Die Baugeschwindigkeit von Colossus ist auch ein wichtiges Merkmal der xAI-Infrastrukturstrategie. Das Rechenzentrum der ersten Stufe wurde auf der Grundlage einer verlassenen Industrieanlage renoviert und von xAI in kurzer Zeit durch eine große Anzahl vorgefertigter Geräte, parallelen Bau und schnellen Einsatz von GPUs zu einer großen KI-Trainingsanlage mit Hunderttausenden GPUs ausgebaut.
xAI erweitert außerdem weiterhin die Rechenzentrumsbau- und Stromversorgungskapazitäten von Colossus. Aufgrund des extrem hohen Stromverbrauchs moderner KI-GPUs geht es beim Ausbau von Rechenzentren nicht nur darum, die Anzahl der Server zu erhöhen. Außerdem müssen sie gleichzeitig eine große Menge an Strom-, Kühlungs-, Netzwerk- und Speicherinfrastruktur aufbauen.
xAI hatte bereits zuvor Probleme mit der Stromversorgung. Der Stromverbrauch von Colossus 1 erreicht Hunderte Megawatt und mit der weiteren Steigerung der Anzahl der GPUs wird auch sein Energiebedarf deutlich steigen. Um die spätere Expansion zu unterstützen, hat xAI nach neuen Energiequellen gesucht und eine entsprechende Stromerzeugungs- und -verteilungsinfrastruktur aufgebaut.
Da NVIDIA Blackwell und nachfolgende GPUs der Rubin-Serie schrittweise auf den Markt kommen, wird das Rechenzentrum von xAI weiterhin Hardware-Upgrades erfahren. Im Vergleich zum H100 kann die neue GPU-Generation eine höhere KI-Rechenleistung bieten, allerdings steigt auch der Stromverbrauch einer einzelnen GPU. Daher müssen zukünftige große KI-Rechenzentren gleichzeitig die Probleme der Rechendichte und der Energieversorgung lösen.
Musk erklärte außerdem zuvor, dass xAI plant, die Gesamtleistungskapazität des Rechenzentrums um 2027 deutlich zu erhöhen und die Rechenleistung auf ein Vielfaches ihres bisherigen Umfangs zu erweitern. Relevante Pläne zeigen, dass die Gesamtleistung der zukünftigen xAI-Rechenzentren mehrere Gigawatt oder sogar 10 Gigawatt erreichen könnte.
Eine solch riesige Infrastruktur bedeutet, dass xAI versucht, eine KI-„Superfabrik“ aufzubauen, die der großer Cloud-Computing-Unternehmen ähnelt. GPU-Server, Netzwerkgeräte, Speichersysteme, Stromversorgungsanlagen und Flüssigkeitskühlsysteme werden zu einem riesigen Rechencluster zusammengefasst, um KI-Modelle wie Grok zu trainieren und auszuführen.
Diese Strategie macht auch den Wettbewerb zwischen xAI und OpenAI immer direkter. OpenAI hat in den letzten Jahren auch im großen Stil KI-Rechenzentren aufgebaut und eine groß angelegte Infrastrukturpartnerschaft mit NVIDIA aufgebaut. NVIDIA hat Pläne angekündigt, OpenAI mit mindestens 10 GW an KI-Systemen auszustatten, was Millionen von GPUs entspricht, und plant, schrittweise bis zu 100 Milliarden US-Dollar in OpenAI mit Infrastrukturbereitstellung zu investieren.
Der Plan von OpenAI bedeutet, dass die KI-Industrie mit „Rechenzentren auf Gigawatt-Ebene“ als grundlegende Wettbewerbseinheit in eine neue Phase eintritt. In der Vergangenheit konzentrierte sich der Wettbewerb zwischen KI-Unternehmen mehr auf Modellalgorithmen, Talente und Daten, doch mittlerweile ist die Computerinfrastruktur selbst zu einem wichtigen Faktor bei der Bestimmung der Geschwindigkeit und des Umfangs des Modelltrainings geworden.
xAI entscheidet sich für den Bau eines eigenen großen Colossus-Rechenzentrums, das es dem Unternehmen ermöglicht, den GPU-Einsatz, die Netzwerkstruktur, die Rechenzentrumssoftware und die Schulungsinfrastruktur direkter zu steuern. Für Unternehmen, die kontinuierlich große Modelle trainieren müssen, kann dieser Ansatz die Abhängigkeit von externen Cloud-Plattformen verringern und es Ingenieurteams gleichzeitig ermöglichen, Hardware und Software für ihre eigenen Modelle zu optimieren.
Allerdings ist die Größenordnung von 1,2 Millionen GPUs immer noch ein zukünftiges Ziel und nicht die Zahl, die xAI derzeit eingesetzt hat. Die Geschwindigkeit des Rechenzentrumsbaus, der GPU-Versorgung, der Stromversorgung, der Kühleinrichtungen, der Netzwerkausrüstung und der Kapitalinvestitionen wirken sich alle auf die endgültige Bereitstellungsgeschwindigkeit aus. Daher können die tatsächliche Anzahl der ausgeführten GPUs und die Abschlusszeit noch variieren.
Unabhängig davon, ob die endgültigen Zahlen die derzeit geplante Größenordnung erreichen können, hat der von xAI gebaute Colossus gezeigt, dass der KI-Infrastrukturwettbewerb in eine neue Phase eintritt. Da OpenAI, Google, Meta, Microsoft und andere KI-Unternehmen Rechenzentren auf Gigawatt-Niveau bauen, wird sich der Wettbewerb zwischen KI-Modellen in Zukunft weitgehend zu einem Wettbewerb zwischen Rechenzentrumsgröße, Stromversorgung und erweiterten GPU-Erfassungsfunktionen entwickeln.
Kommentare