
Zusammenfassung:
Forscher der Maynooth University in Irland haben einen neuen DNA-Computertyp entwickelt, der nicht auf herkömmlichen Siliziumchips und der kontinuierlichen Zufuhr elektrischer Energie basiert, sondern die Interaktion zwischen DNA-Molekülen nutzt, um mathematische Operationen durchzuführen. Das System ist in der Lage, Operationen wie Addition, Subtraktion, Multiplikation und Division durchzuführen und hat in Experimenten erfolgreich komplexe Berechnungen mit 100-Bit-Daten durchgeführt.
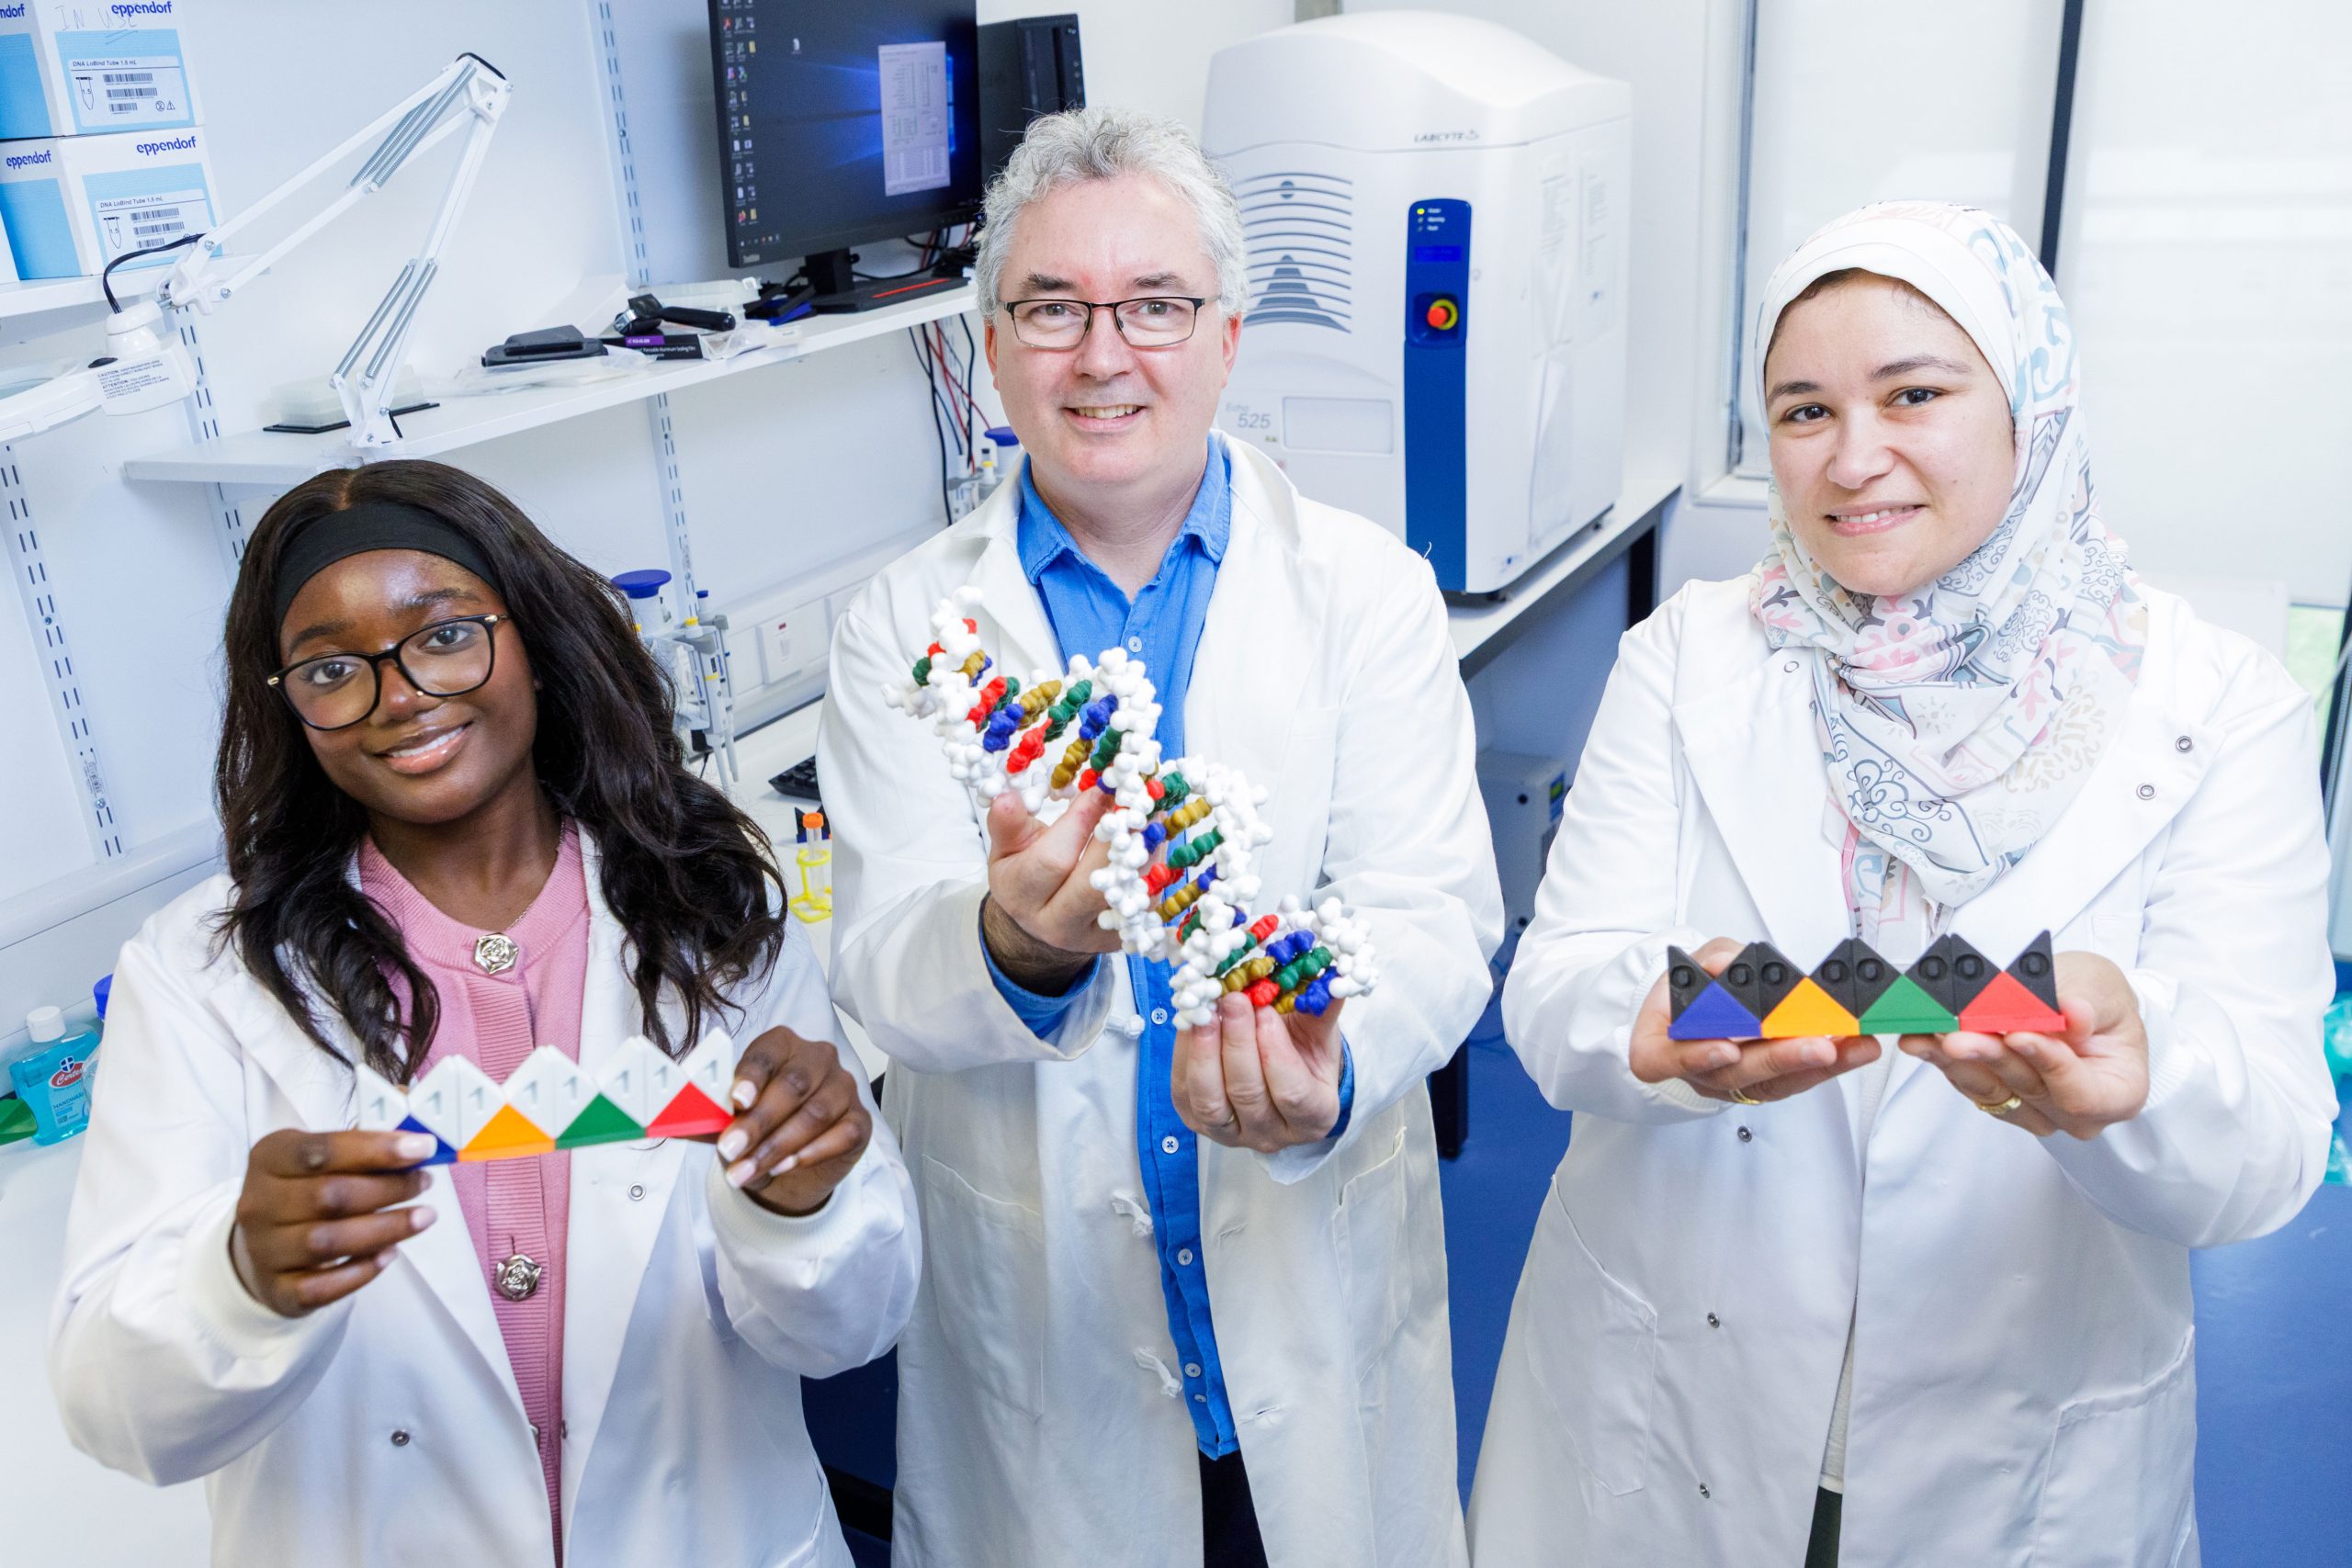
Die Forscher sagten, dass das System nicht nur wiederverwendet werden kann, sondern sich auch auf die Interaktion der Moleküle selbst verlassen kann, um Berechnungen nach dem Start abzuschließen, was neue Forschungsrichtungen für zukünftige Niedrigenergie-Computing, langfristige Datenspeicherung und biomedizinische Anwendungen bietet.
Dieses Forschungsergebnis wurde in der internationalen Fachzeitschrift Nature veröffentlicht. Das Forschungsteam nennt dieses System einen Scaffolded DNA Computer (SDC) und beschreibt es als eines der komplexeren und schnelleren molekularen Computersysteme, über die bisher berichtet wurde.
Im Gegensatz zu herkömmlichen Computern, die binäre Informationen über die Schaltzustände von Transistoren verarbeiten, nutzen DNA-Computer die chemischen Eigenschaften von Nukleinsäuremolekülen, um Informationen zu verarbeiten. Forscher entwerfen vorab die Sequenzen verschiedener DNA-Fragmente, sodass sich diese Moleküle nach bestimmten Regeln miteinander verbinden und letztendlich eine molekulare Struktur bilden können, die die Berechnungsergebnisse darstellen kann.
Das gesamte System sieht nicht wie ein Computer im herkömmlichen Sinne aus. Es erfordert weder ein Motherboard, einen Prozessor oder eine Grafikkarte noch die große Anzahl von Hochgeschwindigkeits-Schalttransistoren, die in herkömmlichen elektronischen Computern zu finden sind. Während des Experiments müssen die Forscher lediglich Wasser, Salz, kurze DNA-Fragmente und ein längeres DNA-Gerüst in einem Reagenzglas mischen und durch leichtes Erhitzen und anschließendes Abkühlen kann der Berechnungsprozess gestartet werden.
Unter ihnen fungieren längere DNA-Stränge als Gerüste und kurze DNA-Fragmente werden nach vorgefertigten Regeln mit ihnen kombiniert. Wenn sich die Temperatur ändert, verbinden und ordnen sich die Moleküle weiter und bilden nach und nach eine stabilere Struktur. Die endgültige molekulare Anordnung entspricht der Lösung des Berechnungsproblems.
Professor Damian Woods vom Hamilton Institute der Maynooth University sagte, dass eine Schlüsselinnovation dieser Technologie darin besteht, dass das System auf natürliche Weise die entsprechende Antwort finden kann, ohne dass für jeden Berechnungsschritt kontinuierlich Energie zugeführt werden muss.
Diese Berechnungsmethode nutzt die Prinzipien der Thermodynamik. Wenn DNA-Moleküle interagieren, haben unterschiedliche Bindungsmethoden unterschiedliche Energiezustände. Durch die rationale Gestaltung von DNA-Sequenzen und Gerüststrukturen können Forscher dafür sorgen, dass die molekulare Anordnung, die die richtige Antwort darstellt, einem günstigeren Energiezustand entspricht, sodass das gesamte System während des Selbstorganisationsprozesses allmählich zu diesem Zustand tendiert.
Mit anderen Worten: Anstatt den Prozessor zu bitten, Berechnungen Schritt für Schritt gemäß einer Reihe elektronischer Anweisungen wie bei herkömmlichen Programmen durchzuführen, kodieren Forscher die Berechnungsregeln im Voraus in DNA-Moleküle und lassen die Moleküle sich dann auf ihre eigenen chemischen Wechselwirkungen verlassen, um Ergebnisse zu finden, die den Regeln entsprechen.
Diese Methode eignet sich besonders für die Untersuchung von Berechnungen auf molekularer Ebene. Eine große Anzahl von DNA-Molekülen kann gleichzeitig in derselben Lösung interagieren, sodass das System über potenzielle Parallelverarbeitungsfähigkeiten verfügt. Allerdings bedeutet die große Anzahl an Molekülen nicht, dass alle Berechnungen sofort abgeschlossen werden können. Die endgültige Geschwindigkeit hängt immer noch von mehreren Zusammenhängen wie molekularen Reaktionen, Strukturaufbau und Ergebnisablesung ab.
Um die tatsächlichen Fähigkeiten des Systems zu überprüfen, entwarf und testete das Forschungsteam zehn verschiedene Berechnungsprogramme mit einer Vielzahl mathematischer Operationen, einschließlich Berechnungsaufgaben bis zur 100-Bit-Datenskala.
In einem einfachen Experiment hat der DNA-Computer die Operation 10 plus 3 erfolgreich abgeschlossen, die etwa 30 Sekunden dauerte. Bei einem herkömmlichen Computer würde diese Berechnung fast augenblicklich abgeschlossen sein, aber bei einem System, das zur Vervollständigung der Berechnung auf der Selbstorganisation von Molekülen beruht, zeigt dieses Ergebnis seine Fähigkeit, einfache Rechenaufgaben zu bewältigen.
In einem weiteren, komplexeren Experiment forderten die Forscher das System auf, Zahlen im Bereich von etwa 11 Millionen bis 34 Millionen hinzuzufügen. Aufgrund des größeren Berechnungsumfangs benötigt das System letztendlich bis zu etwa 14 Stunden, um Ergebnisse zu erhalten.
Diese Experimente zeigen, dass DNA-Computer Probleme bewältigen können, die weitaus komplexer sind als die einfache Addition einstelliger Zahlen, es besteht jedoch immer noch eine große Lücke zwischen ihrer Rechengeschwindigkeit und herkömmlichen Siliziumchips. Die Forscher versuchen nicht, es als direkten Ersatz für gewöhnliche Computer zu bauen, sondern hoffen, eine andere Möglichkeit zu finden, das Material selbst für die Informationsverarbeitung zu nutzen.
Assistenzprofessor Abir Eshra, der an der Forschung beteiligt war, sagte, dass die Reaktionsgeschwindigkeit dieses Systems nicht so schnell sei wie die von Siliziumchips, seine Leistung jedoch Vorteile im Vergleich zu anderen zuvor entwickelten DNA-Computern habe. Sie betonte, dass das Ziel der Forschung nicht darin bestehe, DNA-Computer dazu zu bringen, herkömmliche elektronische Computer in allen Aufgaben zu übertreffen, sondern die potenziellen Vorteile des Molekularrechnens in Bezug auf Energieverbrauch und Parallelverarbeitung zu nutzen.
Neben der Rechenleistung ist auch die Wiederverwendbarkeitsleistung des Systems eines der wichtigen Ergebnisse dieser Forschung. Experimente haben gezeigt, dass dasselbe DNA-Rechnersystem kontinuierlich bis zu 25 verschiedene Rechenaufgaben ausführen kann, ohne das System jedes Mal komplett neu aufbauen zu müssen.
Für molekulares Computing ist die Wiederverwendbarkeit wichtig. Einige frühe DNA-Berechnungsmethoden verbrauchten große Mengen an molekularem Material, was es schwierig machte, das ursprüngliche System nach Abschluss einer Berechnung weiter zu verwenden. Wenn für jeden Vorgang eine große Anzahl von DNA-Molekülen neu hergestellt werden muss, erhöhen sich die Kosten und die praktische Anwendungsschwierigkeit der entsprechenden Technologie erheblich.
Das vom Team der Maynooth University entwickelte System kann in kontinuierlichen Berechnungen wiederverwendet werden und bietet so die Möglichkeit, in Zukunft eine praktischere Molekular-Computing-Plattform zu etablieren. Allerdings befindet sich die Forschung noch im Laborstadium und die Stabilität des Systems bei komplexeren Aufgaben, längeren Läufen und groß angelegten Einsätzen muss weiter überprüft werden.
Hintergrund dieser Forschung ist der Energiedruck, der durch den anhaltenden Anstieg des globalen Computer- und Datenspeicherbedarfs entsteht.
Modelle der künstlichen Intelligenz, Cloud-Computing-Dienste und große Rechenzentren erfordern für den kontinuierlichen Betrieb eine große Anzahl von Prozessoren. Da der Umfang der Computeraufgaben immer weiter zunimmt, ist der Energieverbrauch traditioneller elektronischer Computersysteme zu einem immer wichtigeren Thema in der industriellen Entwicklung geworden.
Woods wies darauf hin, dass Computer und Datenspeicherung einen erheblichen Teil des irischen Stromverbrauchs ausmachen. Er glaubt, dass Menschen lange Zeit dazu neigten, Computer mit Siliziumchips und elektronischen Schaltkreisen gleichzusetzen, dabei aber ignorierten, dass es in der Natur noch andere Systeme gibt, die Informationen verarbeiten können.
Das Gehirn ist ein Beispiel. Das menschliche Gehirn ist in der Lage, komplexe Informationsverarbeitungsaufgaben mit weitaus geringerem Stromverbrauch zu erledigen als viele moderne Computersysteme. Obwohl DNA-Computing nicht auf die gleiche Weise funktioniert wie das Gehirn, hoffen Forscher, durch die Erforschung physikalischer und chemischer Prozesse, die sich vom herkömmlichen elektronischen Computing unterscheiden, neue Computerarchitekturen zu finden.
Auch die DNA selbst weist eine extrem hohe Informationsdichte auf. Es besteht aus vier Grundnukleotiden, die Informationen in unterschiedlicher Anordnung kodieren. Theoretisch kann DNA große Datenmengen in einem extrem kleinen Volumen speichern und wird daher seit langem als potenzielles Medium für die künftige Datenspeicherung mit hoher Dichte angesehen.
DNA-Speicherung und DNA-Computing sind jedoch zwei verwandte, aber unterschiedliche Forschungsrichtungen. Bei der DNA-Speicherung geht es vor allem darum, digitale Informationen in Nukleinsäuresequenzen zu kodieren und diese bei Bedarf zuverlässig zu lesen. DNA-Computing versucht, die Wechselwirkungen zwischen Molekülen zu nutzen, um logische oder mathematische Operationen direkt auszuführen. Der Schwerpunkt dieser Forschung liegt auf Letzterem und bietet auch eine Grundlage für die zukünftige Erforschung von Systemen, die Computer und Speicherung kombinieren.
Forscher glauben, dass diese Technologie in Zukunft für bestimmte Szenarien eingesetzt werden könnte, in denen eine langfristige Aufbewahrung von Informationen erforderlich ist, die Energieversorgung begrenzt ist oder die Parallelverarbeitungsfähigkeiten von Molekülen vollständig genutzt werden können. Wenn beispielsweise in einigen langfristigen Datenspeichersystemen die Informationserhaltung in einen Teil der Rechenaufgabe integriert werden kann, besteht die Möglichkeit, die Abhängigkeit von herkömmlichen elektronischen Geräten zu verringern.
In der weiteren Zukunft könnte Molecular Computing auch mit biomedizinischer Forschung kombiniert werden. Da DNA selbst ein Informationsmolekül in lebenden Organismen ist, hoffen Forscher zu untersuchen, ob ähnliche molekulare Systeme verwendet werden können, um bestimmte Aufgaben innerhalb von Zellen oder in biologischen Umgebungen auszuführen, beispielsweise zur Identifizierung bestimmter molekularer Signale im Zusammenhang mit Krankheiten.
Wenn solche Systeme in Zukunft realisiert werden, sollen sie Forschern bei der Entwicklung neuer molekularer Sensoren helfen oder es bestimmten Biomolekülen ermöglichen, auf ihre Umgebung zu reagieren. Der aktuelle DNA-Computer ist jedoch immer noch ein experimentelles System, das im Reagenzglas läuft, was nicht bedeutet, dass es Wissenschaftlern gelungen ist, einen vollständigen DNA-Computer in menschliche Zellen zu implantieren.
Aus technischer Sicht gibt es mit dieser Technologie noch viele zu lösende Probleme. Erstens erfordert der DNA-Molekülaufbau geeignete Temperaturen, Lösungsbedingungen und Molekülkonzentrationen, und Forscher müssen sicherstellen, dass verschiedene Versuchsreihen konsistente Ergebnisse liefern können. Zweitens muss das System nach Abschluss der Berechnung auch die Molekülstruktur mit geeigneten Methoden lesen und die Ergebnisse in Informationen umwandeln, die von Menschen oder anderen Computergeräten verwendet werden können.
Für groß angelegte Anwendungen ist es außerdem wichtig, die Geschwindigkeit komplexer Berechnungen zu verbessern, Fehler zu reduzieren, die Kosten für DNA-Materialien zu senken und wiederholbare Vorbereitungsprozesse zu etablieren. Selbst wenn Moleküle Operationen durchführen können, ohne dass eine konstante Leistung erforderlich ist, kann der Prozess des Erhitzens, Vorbereitens und Auslesens der experimentellen Ausrüstung dennoch Energie verbrauchen. Daher besteht die genauere Bedeutung dieser Forschung darin, einen molekularen Rechenmechanismus zu demonstrieren, der keine kontinuierliche Elektrizität benötigt, um den Berechnungsprozess voranzutreiben, und nicht darin, zu beweisen, dass der gesamte experimentelle Prozess überhaupt keine Energie benötigt.
Das DISCO-Projekt, an dem das Forschungsteam beteiligt war, das DNA Basic Storage and Computing Infrastructure Project, hofft, Methoden zur Nutzung von DNA für die Informationsspeicherung und -verarbeitung weiterzuentwickeln. Das Projekt wurde vom Europäischen Innovationsrat mit rund 4 Millionen Euro gefördert und von Woods geleitet.
Die Forscher sagten, dass es sich bei der aktuellen Arbeit um explorative Grundlagenforschung handele und noch große Unsicherheit hinsichtlich der zukünftigen Anwendungsrichtung bestehe. DNA-Computer werden kurzfristig nicht die herkömmlichen Prozessoren in PCs, Smartphones oder Rechenzentren für künstliche Intelligenz ersetzen, könnten aber eine andere Möglichkeit bieten, bestimmte spezielle Computeraufgaben umzusetzen.
Das wirklich Wichtige an dieser Forschung ist, dass sie zeigt, dass Computer nicht ausschließlich auf Transistoren und kontinuierlich mit Strom versorgten elektronischen Schaltkreisen basieren müssen. Durch die sorgfältige Gestaltung der Molekülstruktur konnten die Forscher es der DNA ermöglichen, während ihres Selbstorganisationsprozesses mathematische Operationen durchzuführen und nach Abschluss der Berechnungen eine Struktur beizubehalten, die die Ergebnisse darstellte.
Da die Rechenanforderungen und der Energieverbrauch weiter steigen, ist die Suche nach Rechenmethoden, die sich von herkömmlichen Siliziumchips unterscheiden, zu einer wichtigen Forschungsrichtung in der wissenschaftlichen Gemeinschaft geworden. DNA-Computer sind noch weit von praktischen Anwendungen entfernt, aber sie bieten eine Richtung, die es wert ist, weiter erforscht zu werden, wenn es um Niedrigenergie-Computing, molekulare Informationsverarbeitung und neue Datenspeichertechnologien geht.
Kommentare