Zusammenfassung:
Heute Morgen ist das leistungsstärkste Modell von SpaceXAI, Grok 4.7, eingetroffen. Lediglich eine sehr „anstößige“ Positionierung am Anfang der Release-Seite gibt es: Das leistungsstärkste Modell für Programmier- und Wissensarbeit, doppelt so schnell wie vergleichbare Modelle und nur halb so teuer.
Dieses Upgrade hört nicht bei den Benchmarks auf. Grok 4.7 wechselt zu einem größeren Basismodell, stärkt langfristige Aufgaben, Selbstprüfung und Langzeitkontextmanagementfähigkeiten und bezieht Dokumente, Präsentationen, juristische, medizinische und technische sowie andere professionelle Arbeiten in Schlüsseltests ein. Das angestrebte Szenario ist ganz klar: Das Modell soll bei mehrstündigen Aufgaben Umwege vermeiden und direkt verwertbare Ergebnisse liefern.
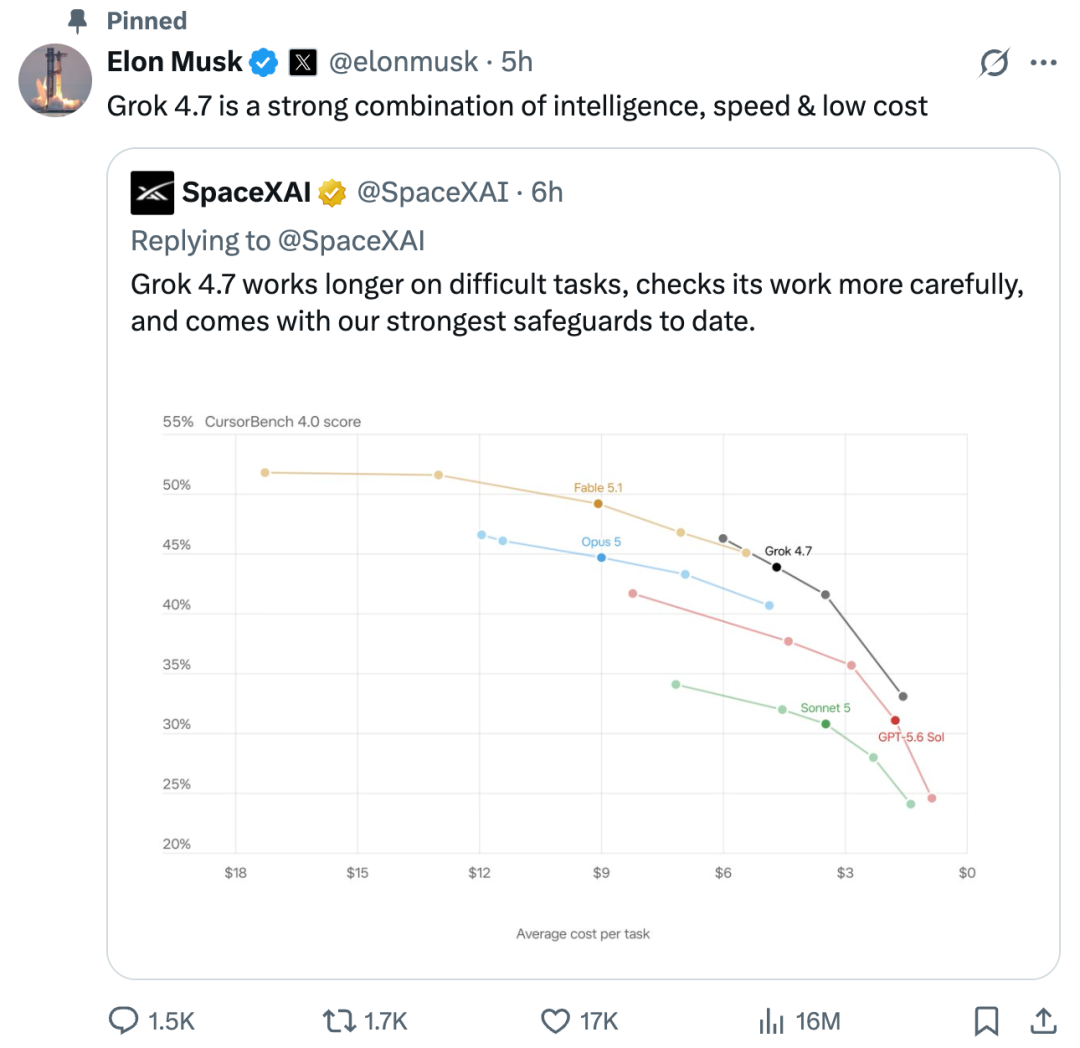
Musk twitterte: „Grok 4.7 erreicht ein sehr wettbewerbsfähiges Gleichgewicht zwischen Intelligenzniveau, Betriebsgeschwindigkeit und Kosten.“
Lange Missionen sind zum Hauptschlachtfeld dieser Modellgeneration geworden
Grok 4.7 verwendet ein größeres Basismodell als Grok 4.6. Die Trainingsphase verlängert den Zeitraum des verstärkenden Lernens und die Aufgabenkombinationen werden schwieriger, da die Bearbeitung mehrerer Proben Stunden in Anspruch nimmt. SpaceXAI sagte, das neue Modell habe seine Fähigkeit verbessert, seine eigene Arbeit zu überprüfen und lange Kontexte zu verwalten.
Diese Art von Verbesserung entspricht direkt den schwierigsten Problemen, die derzeit bei der Programmierung intelligenter Agenten auftreten. Die Generierung von kurzem Code erfordert oft nur eine teilweise Beurteilung, aber zu wirklich komplexen Softwareaufgaben gehören das Lesen des Lagers, das Zerlegen von Anforderungen, das Ändern mehrerer Dateien, das Ausführen von Tests und die wiederholte Fehlerkorrektur. Ob das Modell Ziele einhalten und Fehler in einer langen Ausführungskette erkennen kann, ist oft wichtiger, als schönen Code in einem Rutsch zu schreiben.
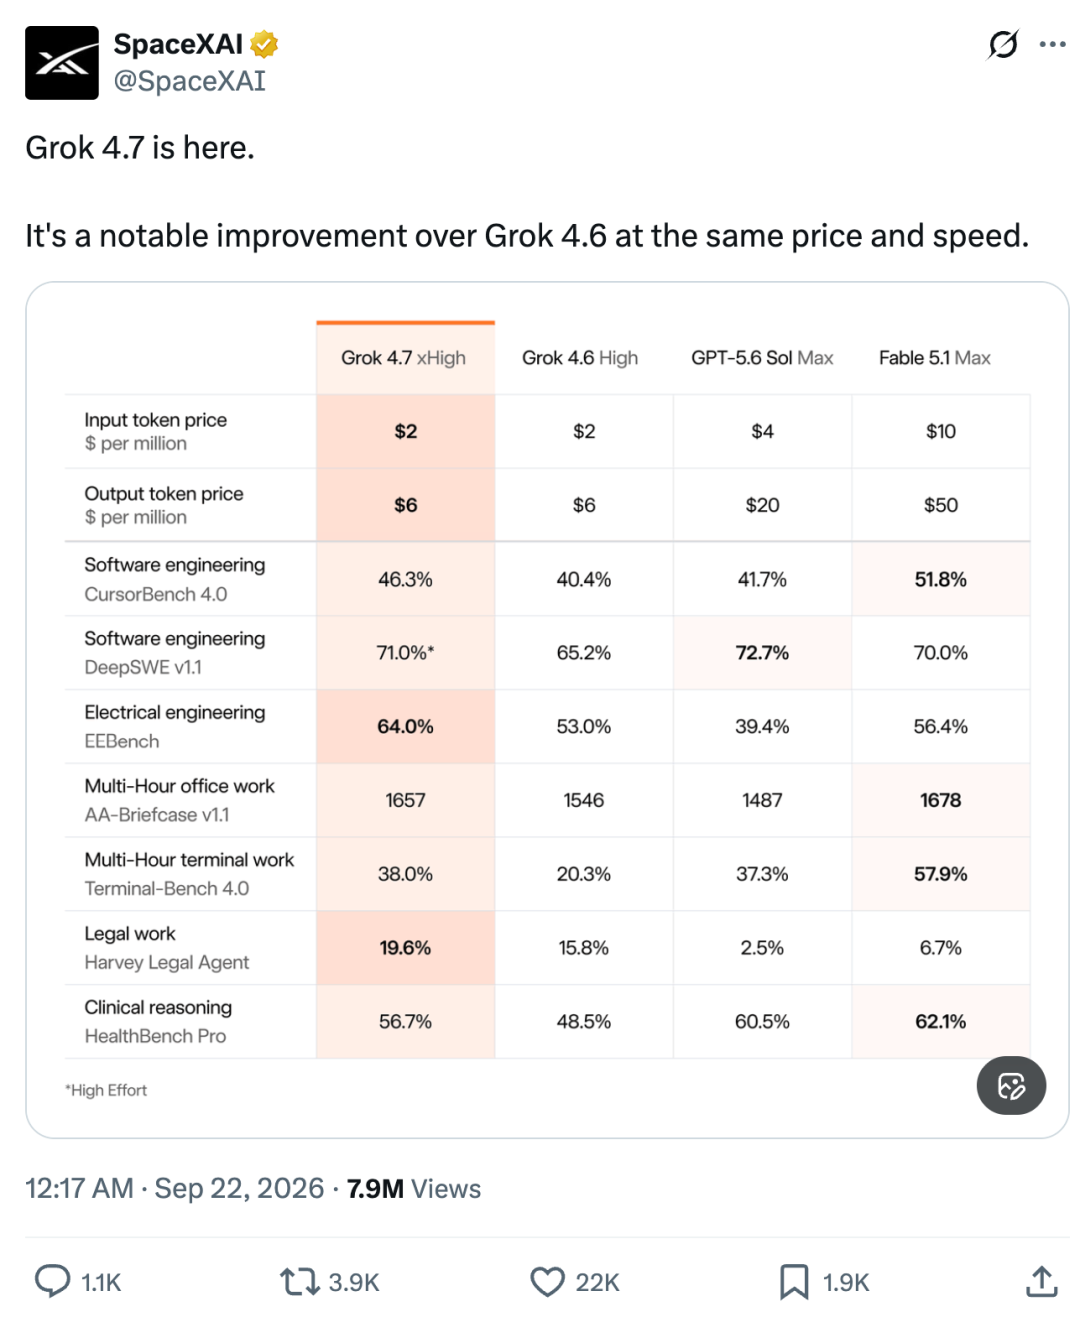
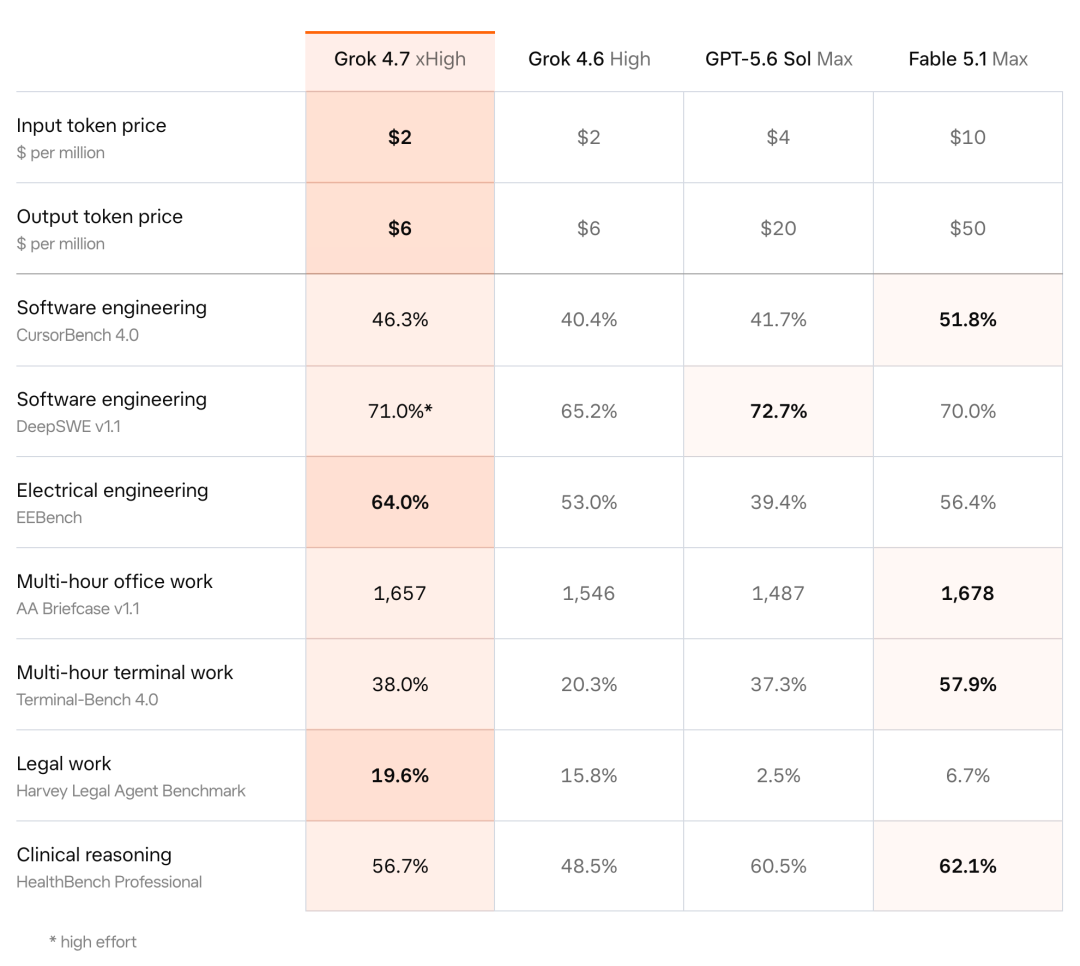
CursorBench 4.0 untersucht speziell langfristige Codierungsaufgaben. In den offiziellen Daten erreichte Grok 4.7 einen Wert von 46,3 % und Grok 4.6 einen Wert von 40,4 %, was einer Steigerung von 5,9 Prozentpunkten entspricht. Bei DeepSWE v1.1 betrug der High-Inference-Intensity-Score von Grok 4.7 71,0 %; Terminal-Bench 4.0 stieg von 20,3 % in der vorherigen Generation auf 38,0 %.
Entsprechend wird Grok 4.7 als das zukunftsweisende Preis- und Leistungsmodell auf CursorBench 4.0 bezeichnet.
Das Modell ist außerdem darauf trainiert, das Framework, in dem Grok Bot ausgeführt wird, nativ zu verstehen. Offiziell verbessert diese Anpassung die Leistung bei Dialogaufgaben und Allgemeinwissensaufgaben. Mit anderen Worten: Der Upgrade-Fokus von Grok 4.7 hat sich von einer einzelnen Antwortrunde auf eine kontinuierliche Zusammenarbeit zwischen Modellen, Tools und Ausführungsumgebungen ausgeweitet.
Vom Schreiben von Code bis zur vollständigen Wissensarbeit
Programmierung ist immer noch das auffälligste Etikett von Grok 4.7, aber der Umfang der von SpaceXAI bereitgestellten Bewertung ist deutlich größer. AA Briefcase und GDPval konzentrieren sich auf die mehrstufige Arbeit, die Fachleute jeden Tag erledigen, und decken allgemeine Aufgaben in Positionen wie Anwälten, Krankenschwestern und Finanzanalysten sowie die Erstellung von Dokumenten und Präsentationen ab.
Auf AA Briefcase v1.1 erzielte Grok 4.7 1657 Punkte, mehr als die 1546 Punkte von Grok 4.6; Der GDPval Elo-Score stieg von 1605 auf 1695. Im offiziellen Diagramm liegt er nahe an den 1735 Punkten von Fable 5.1 für GDPval und höher als die 1542 Punkte von GPT-6 Astra. SpaceXAI kam zu dem Schluss, dass Grok 4.7 in beiden Tests die Vorgängergeneration übertraf und insgesamt auf Augenhöhe mit anderen Spitzenmodellen abschnitt.
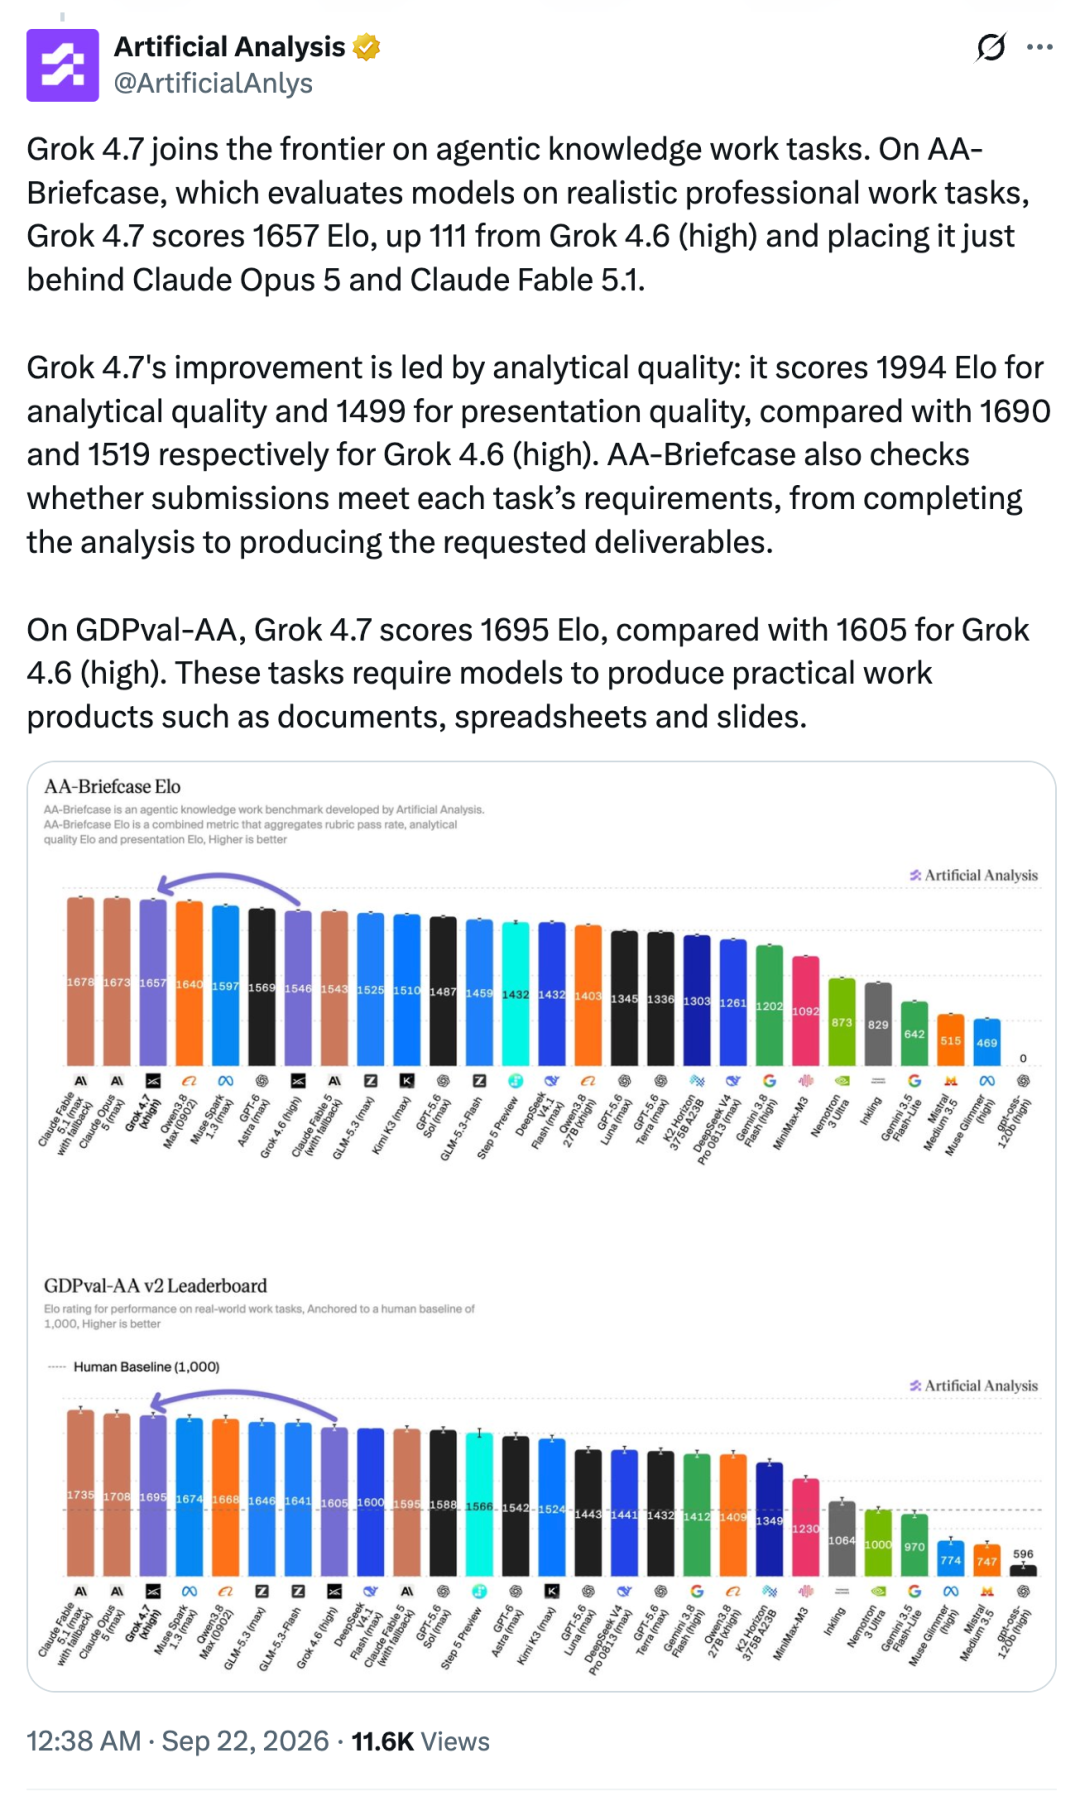
Beförderungen im beruflichen Bereich gibt es auch in viele Richtungen. Der EEBench-Score stieg von 53,0 % auf 64,0 %, der Harvey Legal Agent Benchmark stieg von 15,8 % auf 19,6 % und der HealthBench Professional stieg von 48,5 % auf 56,7 %. Diese Ergebnisse stammen aus einer internen Vergleichstabelle von SpaceXAI, die die Veränderungen zwischen der alten und der neuen Modellgeneration veranschaulichen kann; Modellübergreifende Vergleiche werden weiterhin von der Inferenzintensität, der Werkzeugkonfiguration und der Testumgebung beeinflusst.
Diese Ergebnisse zeigen einen klaren Trend: Der Wettbewerb um Spitzenmodelle tritt in die Phase der „Komplettlösung“ ein.
Das Modell muss die Aufgabe verstehen, Tools aufrufen, Dateien erstellen und sich selbst überprüfen. Die Möglichkeit einer einzelnen Frage und Antwort ist nur ein Teil davon. Grok 4.7 verlängert die Dauer der Trainingsaufgabe und stärkt die Selbstverifizierung, was genau das ist, was diese Art von Arbeitsablauf ausgleicht.
Sicherheit und Preis
Zusätzlich zu den verbesserten Funktionen hat Grok 4.7 ein neues Sicherheitsschutzsystem ermöglicht. SpaceXAI gab an, dass dies das von ihm getestete Modell mit der stärksten Leistung in Bezug auf die Verweigerung der Reaktion und den Widerstand gegen Jailbreaking sei.
Bei den Biosicherheitstests lag Grok 4.7 mit einem Ergebnis von 62,4 % an der Spitze des LatchBio-Benchmarks. Cybersicherheitstests HackerBench v0.3 deckt hauptsächlich risikoreiche und böswillige Aufgaben ab. Offiziellen Daten zufolge gibt das Modell nur 3,3 % der risikoreichen Dual-Use-Tipps frei und blockiert selten versehentlich normale Sicherheitsforschungsanfragen.
SpaceXAI hat außerdem damit begonnen, Red-Team-Funktionen nur auf Einladung für eine begrenzte Anzahl von Cybersicherheitspartnern für defensive Forschung zu öffnen. Derzeit ist diese Red-Team-Fähigkeit zunächst als kontrollierte Zusammenarbeit verfügbar.
Die Standardversion bleibt zum Originalpreis bestehen und die Geschwindigkeit der Schnellversion wird verdoppelt
Grok 4.7 wurde auf Cursor und Grok Build eingeführt und wird über die Grok-API, Programmier-Frameworks von Drittanbietern, Modell-Routing-Dienste und Cloud-Plattformen bereitgestellt. Die Standardversion beginnt bei 2 $ pro Million Input-Tokens und 6 $ pro Million Output-Tokens, im Einklang mit Grok 4.6.
Die Preisstrategie macht dieses Upgrade wirkungsvoller. Entwickler müssen für das Upgrade keine zusätzlichen Kosten für Standardversions-Token zahlen, sondern können eine bessere langfristige Aufgabenleistung, Selbstprüfungsfähigkeiten und professionelle Arbeitsergebnisse erzielen.
Für Programmieragenten und Wissensarbeitsprodukte ist natürlich der Stückpreis jedes Modellaufrufs wichtig. Die Anzahl der Versuche und Nacharbeiten, die zur Erledigung einer Aufgabe erforderlich sind, bestimmt letztendlich die tatsächlichen Kosten.
Fassen Sie dieses Upgrade abschließend zusammen:
Von Trainingsmethoden bis hin zu Bewertungskombinationen stärkt Grok 4.7 alle das Gleiche: lange bei Aufgaben bleiben und komplexe Aufgaben erledigen. Die Programmierung ist nur der erste ausgereifte Einstiegspunkt. Dokumentation, Präsentation, rechtliche Analyse, klinisches Denken und technische Aufgaben wurden in die gleichen Fähigkeiten zusammengefasst.
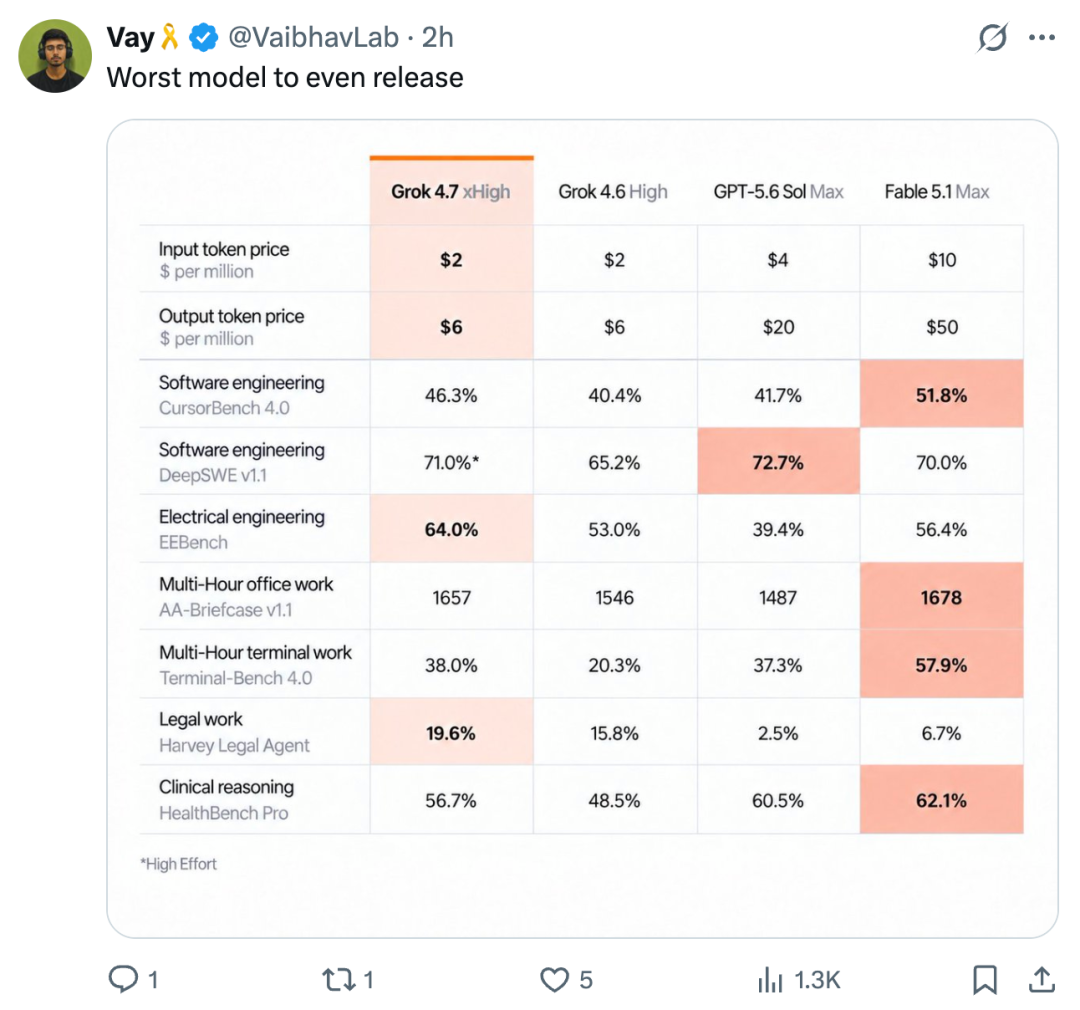
Aber die Internetnutzer scheinen es nicht zu kaufen. „Dieses Modell wagt es tatsächlich, veröffentlicht zu werden. Es ist so schlecht, dass es nicht veröffentlicht werden sollte.“ Ich kann nur respektvoll sagen, dass das Verkaufsargument von Grok 4.7 dieses Mal nicht darin besteht, Konkurrenzprodukte völlig zu vernichten. Es verwendet API-Kosten, die weitaus niedriger sind als bei einigen Flaggschiff-Modellen, dafür aber eine Leistung, die bei einzelnen professionellen Aufgaben recht nah beieinander liegt und führend ist.
Referenzlink:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
Kommentare