
Zusammenfassung:
Die Sony PlayStation 5 wurde ursprünglich als Konsole für Videospiele entwickelt, aber ein Open-Source-Entwicklungsprojekt versucht, eine andere Verwendung für dieses Spielgerät zu finden: die Ausführung lokaler, künstlicher Intelligenz großer Sprachmodelle. Durch die Überwindung der Systembeschränkungen der PS5 verpflanzten die Entwickler die Open-Source-Inferenz-Engine llama.cpp auf die Konsole und nutzten deren GPU weiterhin zum Ausführen großer Modelle. Die neueste Demonstration zeigt, dass eine geknackte normale PS5 bereits das Qwen 3.8-Modell mit 27 Milliarden Parametern ausführen kann. Bei Verwendung der Low-Bit-Quantisierung erreicht die Textgenerierungsgeschwindigkeit etwa 20 Token pro Sekunde.
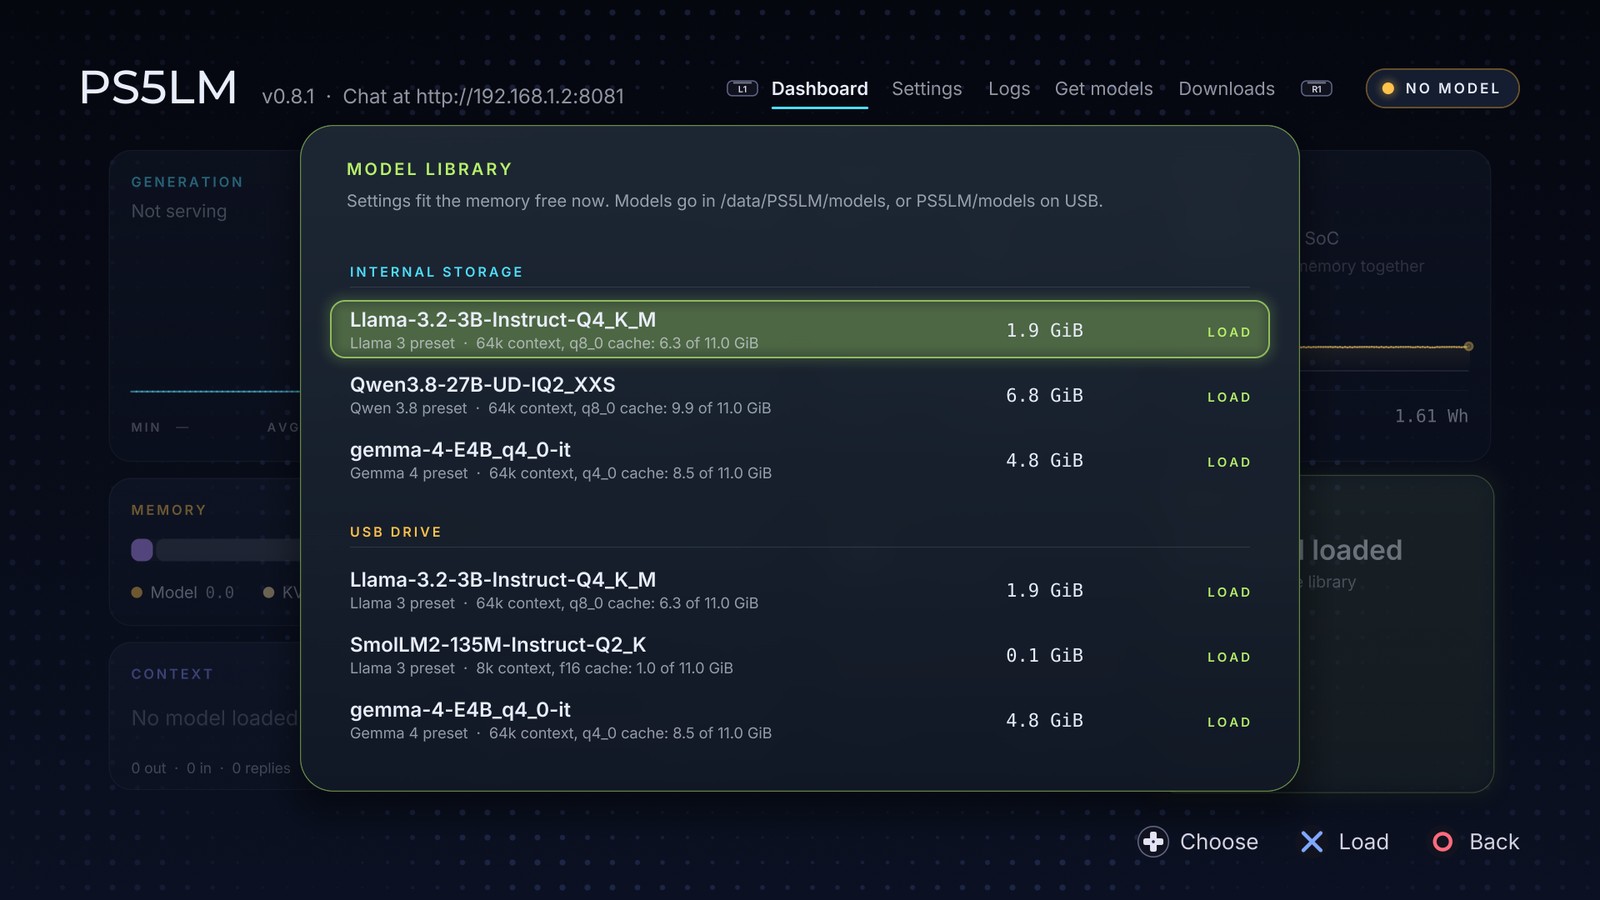
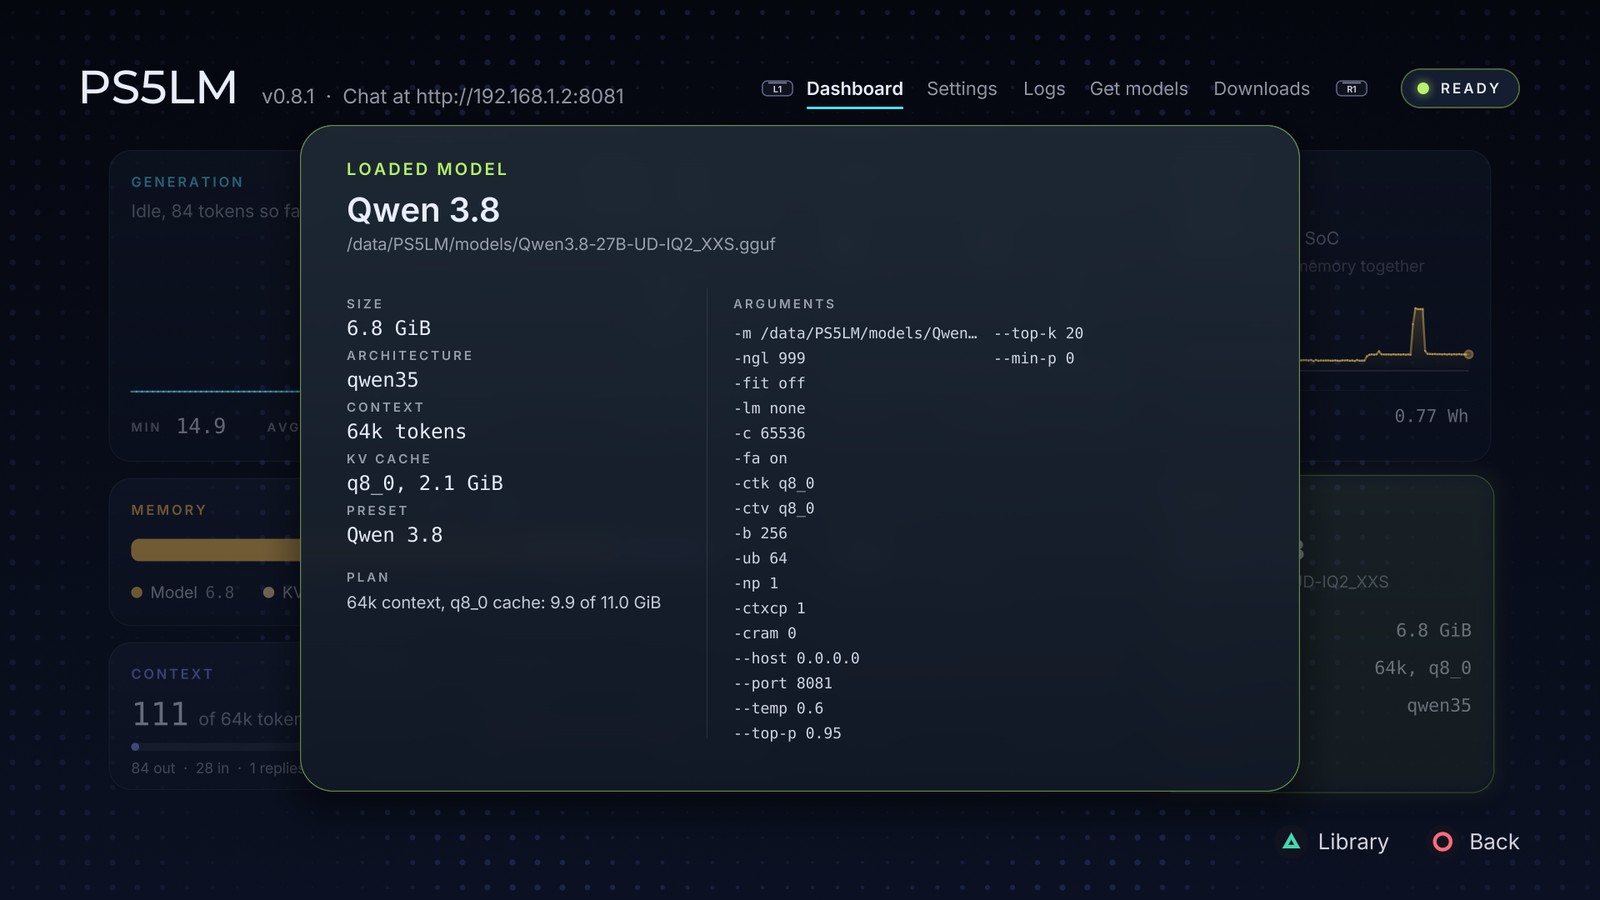
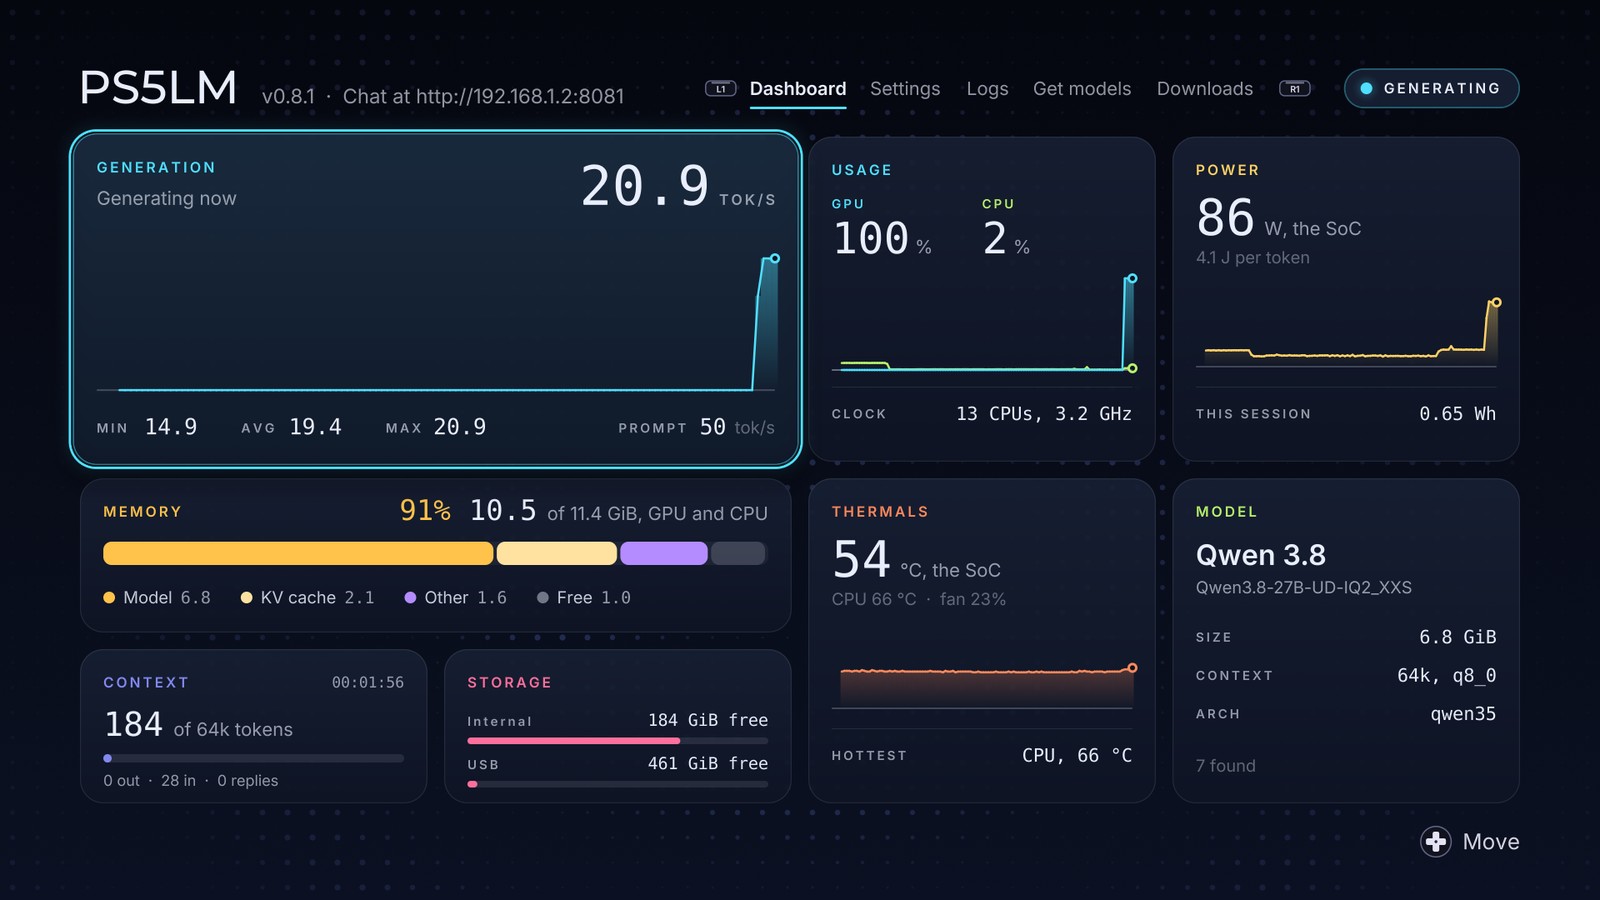
Das bedeutet, dass ein Host, der ursprünglich zum Ausführen von Spielen verwendet wurde, auch als lokaler Server für große Sprachmodelle fungieren kann, ohne auf Cloud-KI-Dienste angewiesen zu sein. Benutzer können über einen Computer oder ein Mobiltelefon im selben LAN auf die Dienste auf dem Host zugreifen und mit dem Modell sprechen. Hierbei handelt es sich jedoch nicht um eine offiziell von Sony bereitgestellte Funktion, sondern um eine experimentelle Anwendung, die auf Systemschwachstellen, inoffizieller Software und Community-Entwicklungsergebnissen beruht.
Das Projekt heißt PS5LM und wurde vom GitHub-Entwickler cobanov initiiert. Die Kernidee des Projekts besteht nicht darin, ein neues Argumentationsframework für künstliche Intelligenz von Grund auf zu schreiben, sondern das Open-Source-Tool llama.cpp, das häufig zum Ausführen lokaler großer Modelle verwendet wird, auf die PS5-Plattform zu übertragen und dann schrittweise die Kompatibilitätsprobleme im Host-Betriebssystem, in der Speicherzuweisung und in der GPU-Computerschnittstelle zu lösen.
PS5 verwendet den benutzerdefinierten Prozessor von AMD. Die CPU nutzt die Zen-2-Architektur und verfügt über 8 Kerne; Die GPU basiert auf der AMD RDNA-Architektur. Der Host ist mit 16 GB GDDR6-Unified-Speicher ausgestattet, und CPU und GPU müssen diese Ressourcen gemeinsam nutzen. Obwohl es sich bei der PS5 nicht um ein Gerät handelt, das speziell für die Inferenz künstlicher Intelligenz entwickelt wurde, bilden ihre GPU und ihr Videospeicher mit hoher Bandbreite die Hardware-Grundlage für die Ausführung lokaler Sprachmodelle.
PS5LM übernahm zunächst einen relativ einfachen Betriebsmodus, der es dem Sprachmodell ermöglichte, Inferenzen über die Host-CPU durchzuführen und den eigenen Browser der PS5 zu verwenden, um eine Chat-Schnittstelle bereitzustellen. Benutzer können das Modell auf den Host herunterladen, Fragen über den DualSense-Controller und die Bildschirmtastatur eingeben und dann die vom Modell generierten Antworten anzeigen.
Dieser frühe Build demonstrierte die Fähigkeit der PS5, große Sprachmodelle auszuführen, stieß jedoch schnell auf Leistungs- und Speicherbeschränkungen. Da das Programm in Form einer Payload läuft, ist der nutzbare Speicher durch die Systemumgebung begrenzt. Zunächst können nur kleinere Modelle stabil betrieben werden. Projektdokumente zeigen, dass die frühe Version hauptsächlich Modelle mit Parametergrößen von etwa 0,8B und 2B unterstützt, wobei die Generierungsgeschwindigkeit des 2B-Modells etwa 9 Token pro Sekunde beträgt.
Für Entwickler, die größere Modelle auf der PS5 betreiben möchten, reicht es nicht aus, das Programm einfach auf der CPU laufen zu lassen. Um die Hardwareleistung des Hosts voll auszunutzen, muss die Inferenz-Engine in der Lage sein, die GPU aufzurufen und genügend Speicherplatz zum Speichern von Modellparametern, Cache und anderen laufenden Daten zu erhalten.
Der wahre Durchbruch kommt von der GPU-Beschleunigung. Entwickler haben außerdem eine native Anwendungslaufumgebung auf PS5 implementiert, und über den von der Community entwickelten Grafiktreiber und die Vulkan-Computerschnittstelle kann llama.cpp die Host-GPU aufrufen, um neuronale Netzwerkberechnungen durchzuführen. Im Vergleich zur früheren Lösung, die nur auf der CPU basieren konnte, verbessert diese Änderung nicht nur die Inferenzgeschwindigkeit, sondern ermöglicht dem Programm auch, mehr verfügbaren Speicher zu erhalten, um zu versuchen, größere Modelle auszuführen.
Bei der neuesten Demonstration lief das vom Alibaba Tongyi Qianwen-Team eingeführte Modell Qwen 3.8 27B erfolgreich auf der PS5. Das Modell verfügt über 27 Milliarden Parameter und verwendet eine hybride Aufmerksamkeitsarchitektur. Das Designziel besteht darin, auf relativ begrenzten Hardwareressourcen ein starkes Sprachverständnis, Argumentation und Codegenerierungsfähigkeiten bereitzustellen.
Allerdings lädt die PS5 27 Milliarden Parameter nicht mit absoluter Präzision direkt in den Speicher. Um das Modell an die Hardwarebedingungen des Hosts anzupassen, verwendeten die Entwickler eine Low-Bit-Quantisierungstechnologie, um die Modellparameter auf einen kleineren Speicherplatz zu komprimieren. Die Demonstration verwendet quantisierte Versionen wie IQ2_XXS, und die Modelldatei ist etwa mehrere GB bis 7 GB groß, und die spezifische Größe hängt vom Quantisierungsschema ab.
Quantifizierung ist eine Schlüsseltechnologie für die Ausführung großer lokaler Modelle. Typischerweise werden Modellparameter in einem Datenformat mit höherer Genauigkeit gespeichert, was jedoch viel Speicher beansprucht. Durch die Komprimierung von Parametern in Werte mit geringerer Bitbreite können Sie den Speicherbedarf erheblich reduzieren und die Menge der Datenübertragung während der Inferenz reduzieren. Der Preis besteht darin, dass einige Präzisionsinformationen verloren gehen, was sich auf die Antwortqualität, die Argumentationsfähigkeit oder die Leistung bestimmter Aufgaben des Modells auswirken kann. Daher bedeutet die Möglichkeit, ein Modell mit 27 Milliarden Parametern auszuführen, nicht, dass PS5 ein Modell derselben Größe mit voller Genauigkeit ausführen kann.
Vom Entwickler veröffentlichte Testdaten zeigen, dass die Textgenerierungsgeschwindigkeit von Qwen 3.8 27B bei Verwendung der GPU zur Durchführung von Inferenzen etwa 20 Token pro Sekunde erreichen kann. Token ist die Grundeinheit für große Sprachmodelle zur Textverarbeitung. Es entspricht nicht unbedingt einem chinesischen Schriftzeichen oder einem englischen Wort. Daher können 20 Token pro Sekunde nicht einfach so verstanden werden, dass 20 chinesische Schriftzeichen pro Sekunde generiert werden. Dennoch ist das schnell genug, damit interaktive Gespräche einen praktischen Nutzen haben und nicht nur eine technische Demonstration sind, um zu beweisen, dass ein Modell einsatzbereit ist.
Neben dem Qwen-Modell gab das gleiche Projekt auch die Testergebnisse anderer Modelle bekannt. Gemma 4 E4B generiert etwa 61 Token pro Sekunde, während Llama 3.2 3B etwa 124 Token pro Sekunde erreicht. Kleine Modelle verfügen über weniger Parameter, erfordern weniger Berechnungen und Datenlesevorgänge und erreichen daher im Allgemeinen höhere Generierungsgeschwindigkeiten.
Diese Ergebnisse sollten immer noch als Testergebnisse betrachtet werden, die von Entwicklern unter bestimmten Software- und Hardwarekonfigurationen veröffentlicht wurden, und nicht als Branchen-Benchmarks, die von einer einheitlichen Testplattform überprüft wurden. Verschiedene Modelle haben unterschiedliche Parameterskalen, Quantifizierungsmethoden, Kontextlängen und Rechenaufgaben. Ihre umfassenden Fähigkeiten können nicht allein anhand der Anzahl der pro Sekunde generierten Token beurteilt werden.
Das Projekt demonstriert auch die Möglichkeit, PS5 in einen LAN-KI-Server umzuwandeln. Durch die Ausführung einer OpenAI-API-kompatiblen Serviceschnittstelle auf dem Host können andere Geräte Anfragen über dasselbe Netzwerk senden und vom Modell generierte Antworten erhalten. Auf diese Weise müssen Benutzer für die Bedienung der Konsole nicht immer den Blick auf den Fernsehbildschirm richten und können das lokale Modell auch über einen Computer oder ein Mobiltelefon auf der PS5 anrufen.
Dieser Ansatz ist attraktiv für Benutzer, die lokale KI-Dienste in ihren Heimnetzwerken bereitstellen möchten. Wenn das Modell lokal ausgeführt wird, müssen tägliche Konversationsinhalte grundsätzlich nicht an Cloud-KI-Dienste von Drittanbietern gesendet werden, und Benutzer müssen keine Cloud-Inferenzgebühren zahlen, die auf der Anzahl der Anrufe basieren. Der tatsächliche Schutz der Privatsphäre hängt jedoch immer noch von der installierten Software, der Netzwerkkonfiguration und davon ab, ob das Gerät über andere Datenübertragungsverhalten verfügt. Allein dadurch, dass es „lokal läuft“, kann das System nicht als absolut sicher angesehen werden.
Gleichzeitig stützt sich die PS5LM-Entwicklung immer noch auf eine Reihe inoffizieller Technologien. Benutzer benötigen eine PS5, die das entsprechende Cracking-Programm ausführen und kompatible System-Firmware und Tools zum Laden von Nutzlasten verwenden kann. Der im Projektdokument aufgeführte anwendbare Firmware-Bereich liegt zwischen 7.00 und 13.60. Spezifische Funktionen, Leistung und Kompatibilität können jedoch je nach Hostmodell und Softwareversion variieren.
Das Knacken der Konsole bedeutet nicht, dass alle PS5-Benutzer das Programm direkt installieren können. Die normale Einzelhandelsversion der PS5 kann PS5LM nicht wie normale Spiele über den PlayStation Store herunterladen und ausführen. Benutzer müssen zunächst Probleme wie Systemzugriffsberechtigungen, das Laden inoffizieller Programme und die Betriebsumgebung lösen, was für Benutzer, die mit Host-Cracking und Softwareentwicklung nicht vertraut sind, immer noch eine gewisse Schwelle darstellt.
Darüber hinaus kann eine Änderung des Hostsystems Sicherheits- und Stabilitätsrisiken mit sich bringen, sich auch auf die Nutzung von Online-Diensten auswirken und die entsprechenden Nutzungsbedingungen von Sony beeinträchtigen. Entwickler empfehlen, Recherchen nur auf Geräten durchzuführen, die sie besitzen oder autorisiert haben. Für Konsolenbenutzer, die es hauptsächlich zum normalen Spielen verwenden, insbesondere diejenigen, die sich häufig mit dem PlayStation Network verbinden, besteht keine Notwendigkeit, das Gerät vorschnell zu hacken, nur um lokale KI auszuführen.
Aus Hardware-Sicht besteht die Bedeutung dieses Experiments nicht nur darin, der Spielekonsole die Beantwortung von Fragen zu ermöglichen. Es zeigt außerdem, dass die GPU und der Hochgeschwindigkeits-Videospeicher, die in Gaming-Geräten für Endverbraucher installiert sind, nach entsprechender Softwareanpassung auch einen Teil der Arbeit übernehmen können, die normalerweise von dedizierten KI-Rechnern erledigt wird.
Die Inferenz großer Sprachmodelle wird häufig erheblich von der Speicherkapazität und der Bandbreite beeinflusst. Wenn das Modell Text generiert, muss es kontinuierlich eine große Anzahl von Parametern lesen und kontextsensitive Caches verwalten. Die einheitliche Speicherarchitektur der PS5 ermöglicht es CPU und GPU, Hochgeschwindigkeitsspeicherressourcen gemeinsam zu nutzen, aber das System selbst muss auch einen Teil davon belegen, sodass der für die Modelle verfügbare Speicherplatz weit unter der Nennkapazität von 16 GB liegt.
Aus diesem Grund müssen Entwickler gleichzeitig Probleme wie Quantisierung, Speicherverwaltung und GPU-Rechnerschnittstellen lösen. Eine GPU, die nur leistungsstark genug ist, garantiert nicht, dass ein Modell reibungslos läuft; Ob die Modellarchitektur unterstützt wird, ob der Treiber die erforderlichen Berechnungsvorgänge ausführen kann und ob das System genügend Speicher für das Inferenzprogramm bereitstellen kann, wirkt sich auf das Endergebnis aus.
Dieses Ergebnis liefert auch eine interessante Referenz für die Auswahl lokaler KI-Hardware. Traditionell mussten Benutzer, die zu Hause größere Sprachmodelle ausführen wollten, oft einen Computer mit separater Grafikkarte kaufen und für die Speicherkapazität und die Gesamtkosten der Maschine extra bezahlen. Da die PS5 bereits über eine relativ leistungsstarke GPU und einen Hochgeschwindigkeitsspeicher verfügt, hoffen die Entwickler, beweisen zu können, dass vorhandene Spielehardware auch wiederverwendet werden kann, ohne dass eine dedizierte KI-Workstation angeschafft werden muss.
Das bedeutet aber nicht, dass PS5 KI-Computer vollständig ersetzen kann. Seine Hardwareressourcen sind immer noch durch feste Konfigurationen, Systembedarf und inoffizielle Softwareumgebungen begrenzt. Im Vergleich zu Computern mit größerem Grafikspeicher, ausgereiften Treibern und umfangreichen Entwicklungstools erfordert die PS5 mehr grundlegende Anpassungsarbeit, um große Modelle auszuführen, und Benutzer können die Grafikkarte nicht frei aufrüsten oder den Grafikspeicher wie bei normalen KI-Computern erweitern.
Aus praktischer Sicht eignet sich diese Art von Projekt derzeit eher für Technologiebegeisterte, Open-Source-Entwickler und Benutzer, die sich für lokale KI interessieren, um Modellschlussfolgerungen, GPU-Computing und eingebettete Betriebsumgebungen zu studieren. Für Unternehmen, die KI-Dienste auf Produktionsebene stabil ausführen müssen, sind dedizierte GPU-Server oder Computer, die durch ausgereifte Software-Stacks optimiert sind, noch besser geeignet.
Die Entwicklung von PS5LM spiegelt auch einen Trend im Open-Source-KI-Ökosystem wider: Modellinferenz-Frameworks und Open-Weight-Modelle haben die Schwelle für die Ausführung künstlicher Intelligenz schrittweise gesenkt, während Community-Entwickler weiterhin versuchen, diese Tools auf verschiedene Hardwareplattformen zu portieren. Früher galten Spielekonsolen vor allem als geschlossene Unterhaltungsgeräte; Dank der Bemühungen der Cracking- und Reverse-Engineering-Community sind sie mittlerweile auch zu Plattformen für die Erforschung von GPU-Computing und nativen Anwendungen der künstlichen Intelligenz geworden.
Im Allgemeinen handelt es sich um einen repräsentativen technischen Versuch, eine geknackte PS5 ein großes Sprachmodell mit 27 Milliarden Parametern mit einer Geschwindigkeit von etwa 20 Token pro Sekunde laufen zu lassen. Es demonstriert den potenziellen Einsatz von Spielekonsolen-Hardware und beweist außerdem, dass durch Softwareanpassung und Modellkomprimierung Sprachmodelle einer bestimmten Größenordnung auf nicht-traditionellen KI-Geräten ausgeführt werden können. Allerdings handelt es sich bei dieser Errungenschaft immer noch um ein Community-Projekt, das auf einer geknackten Umgebung basiert, und es besteht immer noch ein erheblicher Abstand zu offiziellen Funktionen, die normale Benutzer ohne komplizierte Vorgänge nutzen können.
Kommentare