Zusammenfassung:
März 2016, Four Seasons Hotel Seoul. Mitten im zweiten Spiel des Mensch-Maschine-Kampfes hinterließ AlphaGo einen Sonnenfleck auf der fünften Reihe. Dem Kommentar vor Ort fehlten die Worte, und einige Leute vermuteten, dass es einen Fehler im Programm gab, denn nach dem gesunden Menschenverstand professioneller Schachspieler handelte es sich bei diesem Zug fast um einen Freiwurf.
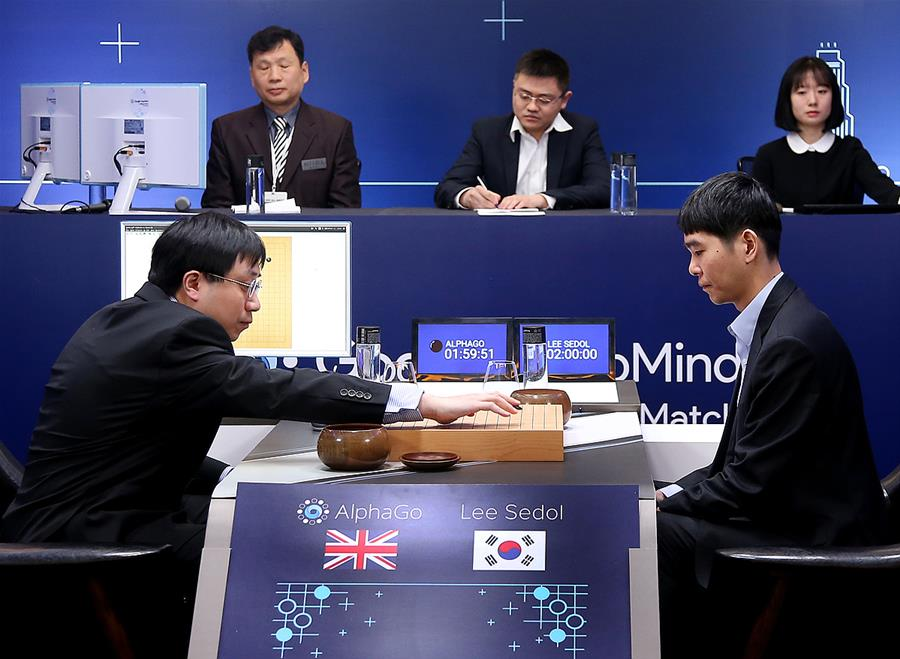
Jeder kennt die folgende Geschichte. AlphaGo gewann nicht nur dieses Spiel, sondern besiegte auch Lee Sedol mit einem Gesamtscore von 4:1. Nach dem Spiel sagte Lee Sedol etwas, das oft zitiert wird: „Ursprünglich dachte ich, AlphaGo sei nur eine Maschine, die auf Wahrscheinlichkeitsberechnung basiert. Aber nachdem ich diese Hand gesehen hatte, änderte ich meine Meinung. AlphaGo muss kreativ sein.“
Das ist der berühmte Zug 37.
Zehn Jahre später stand der Mann, der AlphaGo entwickelt hatte, auf und sagte: Die heutige KI verfügt nicht über die Fähigkeiten, auf die dieses Schachspiel angewiesen ist.
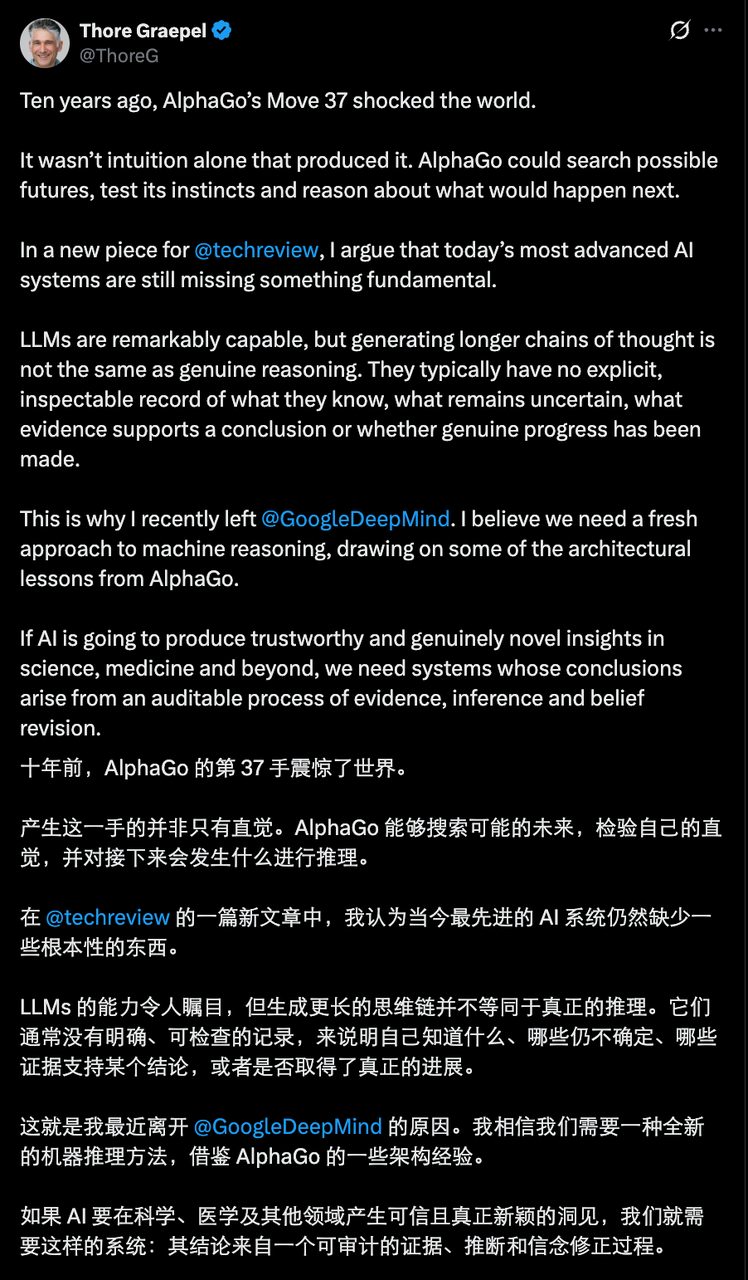
Die Person, die das gesagt hat, ist Thore Graepel, einer der Hauptautoren von AlphaGo und beschäftigt sich seit langem mit der Forschung zum maschinellen Lernen. Kürzlich traf er eine faszinierende Entscheidung – er verließ Google DeepMind, um ein Unternehmen zu gründen, das seiner Meinung nach wichtiger ist: Maschinen mit echten Denkfähigkeiten auszustatten.
Dieser ergreifende Punkt geht auf einen Artikel zurück, den er kürzlich im MIT Technology Review veröffentlicht hat. Der Titel des Artikels ist sehr einfach: „Lassen Sie sich nicht täuschen – LLMs können nicht argumentieren.“ Nach der Lektüre dieses Artikels drückte der Gewinner des Turing-Preises, Yann LeCun, seine Wertschätzung aus und betonte, dass „wirkliches Denken eine Suche beinhalten muss, und LLM verfügt nicht über diese Fähigkeit.“
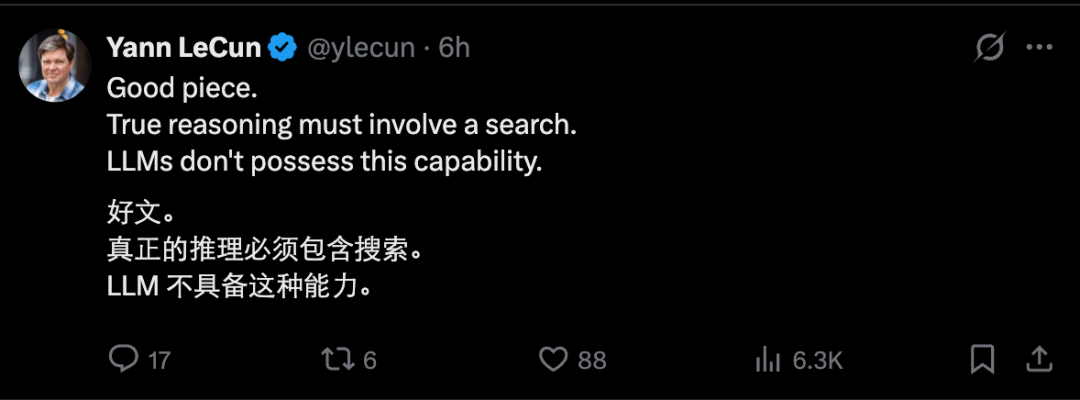
Warum hat Thore Graepel das gesagt? Schauen wir uns an, was in diesem Artikel geschrieben steht.
Move 37 war kein „Geistesblitz“
Es ist das Ergebnis einer Überlegung
Viele Menschen beschreiben den 37. Zug als einen „mythischen Moment maschineller Intuition“ – in einem Blitzschlag erlebte die KI einen meisterhaften Zug über die tausendjährige Geschichte des menschlichen Schachs hinaus. Graepel sagte, dies sei das größte Missverständnis über AlphaGo.
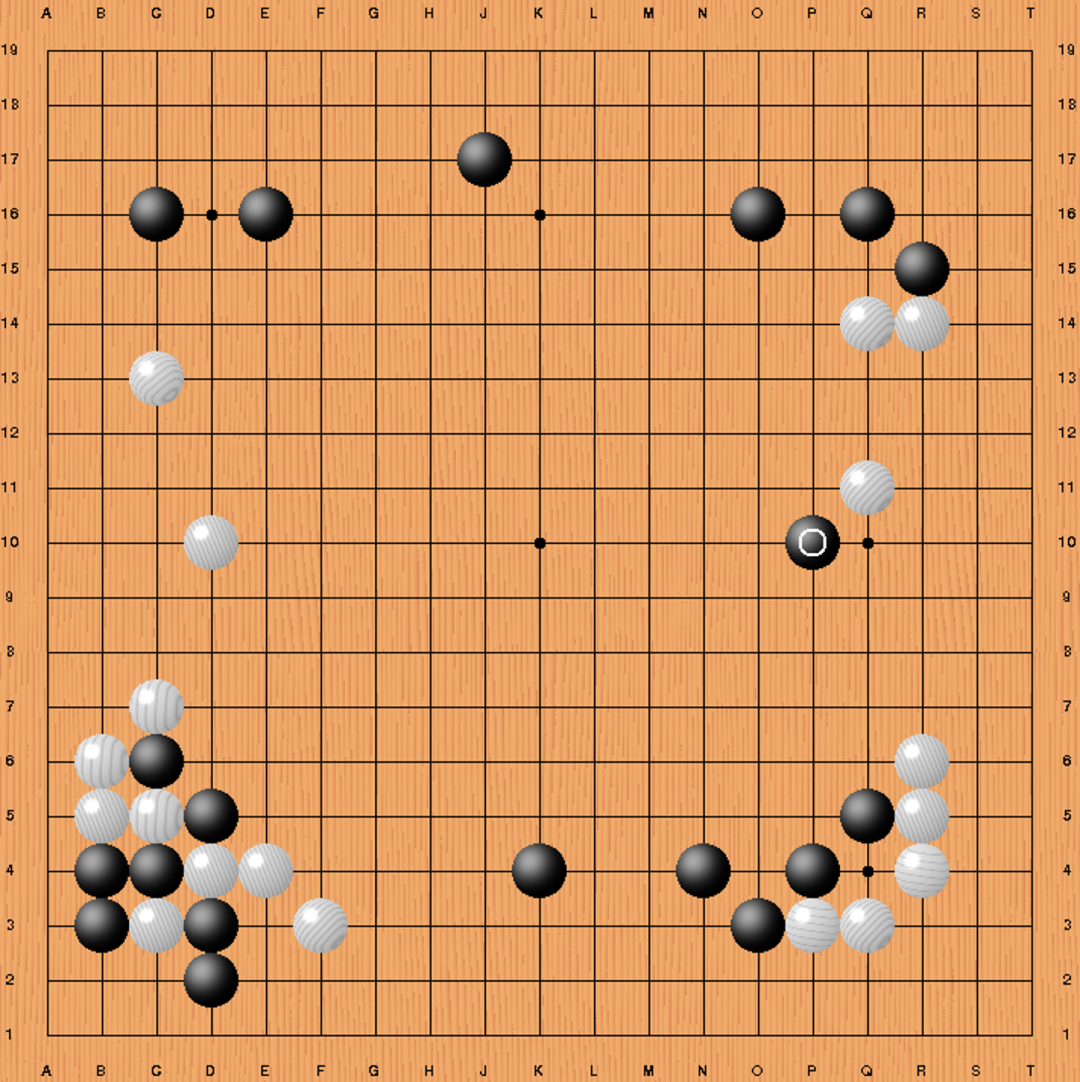
Um dies zu verstehen, müssen wir zunächst die interne Struktur von AlphaGo zerlegen. Es besteht aus zwei Systemen: Das eine ist ein politisches Netzwerk, das aus riesigen menschlichen Schachaufzeichnungen lernt, um vorherzusagen, „wie der Meister in dieser Situation spielen wird“. Das ist der intuitive Teil. Der andere ist ein Suchmechanismus, der sich nicht darum kümmert, ob ein bestimmter Schachzug „so aussieht, als wäre er von einem Menschen gespielt worden“, sondern explizit einen Spielbaum mit Tausenden von Zweigen aufbaut, um die Zukunft abzuleiten, in die jede Kandidatenposition führt.
Der entscheidende Punkt ist: In den Augen des Strategienetzwerks ist Zug 37 unauffällig – die Wahrscheinlichkeit, dass ein professioneller menschlicher Schachspieler diesen Zug spielt, beträgt nur etwa 1 zu 10.000. Wenn Sie nur auf Ihre Intuition hören, wird diese Hand überhaupt nicht ausgewählt. Es war der Suchmechanismus, der nach sorgfältiger Berechnung herausfand, dass dieser „unglaubliche“ Schachzug zu einem besseren Ende führte.
Graepel greift zur Erklärung auf Kahnemans berühmten Rahmen zurück. Das menschliche Denken ist in zwei Modi unterteilt: System 1 ist schnell, intuitiv und mühelos; System 2 ist langsam, Schritt für Schritt und sorgfältig abgewogen. AlphaGo ist zufällig eine seltene Kombination dieser beiden Modi auf der Maschine: Das neuronale Netzwerk liefert die Intuition „Dieser Zug hat eine Chance“ und „Diese Situation muss gewonnen werden“, und der Suchmechanismus ist dafür verantwortlich, diese Intuitionen bei zukünftigen offensiven und defensiven Änderungen zu testen. Ohne die Hälfte geht es nicht: Die Intuition allein schafft nie den 37. Zug; Eine gewaltsame Suche allein wird nicht in der Lage sein, die astronomischen Möglichkeiten von Go auszuloten.
Hier gibt es einen weiteren Vergleich, der oft übersehen wird. Deep Blue besiegte Kasparov im Jahr 1997, indem es sich auf von Menschen fest programmierte Regeln verließ, um 200 Millionen Schachpositionen pro Sekunde auszuwerten und sechs bis acht Schritte vorauszuschauen. Die Komplexität von Go liegt auf einer ganz anderen Ebene. Der Wert einer Figur hängt von der Zunahme und Abnahme des Impulses und des Feldes nach Dutzenden von Runden ab. Selbst wenn nur ein kleiner Teil aller Veränderungen berechnet würde, müsste ein Supercomputer dies über Milliarden von Jahren berechnen. Daher muss AlphaGo lernen, „die Situation auf einen Blick klar zu erkennen“ und sogar Bewegungen auszuführen, an die Menschen noch nie gedacht haben. Man gewinnt es nicht, indem man die Rechenleistung vernichtet, was entscheidend ist.
Großes Sprachmodell:
Ein bis zum Äußersten trainiertes System 1
Sehen wir uns die heutige KI an.
Das Arbeitsprinzip großer Sprachmodelle besteht darin, den nächsten Token immer wieder vorherzusagen. Dies ist im Wesentlichen System 1 in Aktion: schnell, assoziativ und in der Lage, in fast jedem Bereich, über den Menschen jemals geschrieben haben, beeindruckende Muster zu vervollständigen, jedoch ohne den Teil „Überlegen Sie, bevor Sie antworten“.
Kurz nach der Geburt von ChatGPT erkannte die Branche, dass Sprachkenntnisse allein keinen echten Nutzen bringen konnten. Den Lösungsplan kennt jeder: Lassen Sie das Modell nicht voreilig antworten, generieren Sie zunächst Zwischenschritte, brechen Sie das Problem auf und bringen Sie die Zwischenergebnisse mit – also die Gedankenkette.
Die Verbesserung der Denkkette ist real, insbesondere in Mathematik und Codierung. Aber Graepel wies auf eine Tatsache hin, die durch Aufregung leicht verdeckt wird: Bei diesen Zwischenschritten des Denkens handelt es sich immer noch um den gleichen Prozess der „Vorhersage des nächsten Tokens“, es wird nur etwas länger wiederholt, bevor die endgültige Antwort gegeben wird. Es führt keinen wirklich unabhängigen Argumentationsmechanismus wie die Suche von AlphaGo ein. Die Intuition wird gedehnt, aber sie verwandelt sich nicht in Besonnenheit.
Er führte außerdem drei Mängel auf, um zu erklären, warum die Funktionsweise des Chatbots nicht „der Art von Argumentation entspricht, die von Wissenschaftlern anerkannt wird“.
Erstens verfügt das Modell nicht über einen klaren, kontinuierlich aktualisierten und überprüfbaren kognitiven Zustand. Welche Hypothesen erwägt es derzeit, wie viel Vertrauen setzt es in verschiedene Erklärungen, welche Beweise wägt es ab und welche Fragen bleiben unbeantwortet. Diese Dinge sollten systematisch überarbeitet werden, sobald neue Informationen eingehen, aber es gibt kein solches „offenes Hauptbuch“ innerhalb des Modells.
Zweitens erreicht das Modell nicht die Trennung zwischen „was man wissen sollte“ und „wie man Wissen nutzt“. Wissen und Argumentation sind eng mit den Gewichten des neuronalen Netzwerks verknüpft, und es gibt kein unabhängiges und explizit zum Ausdruck gebrachtes Glaubenssystem.
Drittens und am subtilsten: Gedankenketten sehen aus wie nachdenkliche Überlegungen, aber Untersuchungen haben gezeigt, dass Modelle sie oft erst im Nachhinein erstellen. Die Antwort erhalten Sie, indem Sie in eine Richtung gehen, aber was Ihnen berichtet wird, ist eine andere. Eine „Geschichte, die vernünftig klingt“ und eine „Begründung, die wirklich passiert ist“ sind zwei verschiedene Dinge.
Ob die Argumentation wahr oder falsch ist
Ist es so wichtig?
Wenn Sie nur chatten und chatten, spielt es möglicherweise keine Rolle, ob die Argumentation wahr oder falsch ist. Aber in den wichtigen Bereichen, die uns wirklich am Herzen liegen – Medizin, Ingenieurwesen, wissenschaftliche Forschung – ist es genauso wichtig, was ein System erreicht, wie es es erreicht. Wenn etwas schief geht, beispielsweise ein Fehler bei der Diagnose oder Behandlung, müssen wir in der Lage sein, genau zu bestimmen, wo der Fehler liegt: Gibt es ein Problem mit dem Argumentationsprozess, akzeptiert er ungültige Beweise oder trifft er eine falsche Annahme? Einem System, das Geschichten erst im Nachhinein erfinden kann, kann man in solchen Szenarien nicht vertrauen oder es zur Rechenschaft ziehen.
Genau aus diesem Grund hat Graepel DeepMind verlassen. Er glaubt, dass wir einen neuen Weg des maschinellen Denkens brauchen, und die Inspiration kommt von AlphaGo vor zehn Jahren.
AlphaGo zeichnet jederzeit sein gesamtes Wissen über die aktuelle Situation auf, den Spielbaum. Der Baum enthält alle Änderungen, die er berücksichtigt hat, alle möglichen Zukünfte, und jede Bewegung und jede Situation ist mit der Beurteilung des neuronalen Netzwerks markiert. Während die Ableitung fortschreitet, wird der Baum kontinuierlich aktualisiert und schließlich wird die Bewegung anhand der Informationen im Baum bestimmt.
Graepel glaubt, dass das Gleiche auch für allgemeine Denksysteme gilt: die Aufrechterhaltung eines kognitiven Zustands, der klar zum Ausdruck bringt, was bestätigt ist, was zweifelhaft ist, was ausgeschlossen wurde und welche Fragen offen bleiben. Und „Argumentation“ ist eine Reihe von „Aktionen“, die diesen kognitiven Zustand verändern – Schlussfolgerungen ableiten, Probleme zerlegen und, was am wichtigsten ist: entscheiden, welche Fragen als nächstes gestellt, welche Berechnungen durchgeführt und welche Experimente durchgeführt werden sollen.
Natürlich ist das Denken in einer offenen Welt viel schwieriger als Schach zu spielen. Der Zustand auf dem Go-Board ist vollständig sichtbar und die Regeln sind festgelegt; In der realen Welt ist die aktuelle Situation nur teilweise bekannt, die verfügbaren Aktionen sind zahlreich und komplex und die Konsequenzen der Aktionen sind voller Zufälligkeit oder sogar völlig unbekannt.
Aber die gute Nachricht ist, dass der Fortschritt von LLM und anderen neuronalen Modellen im Laufe der Jahre gerade Teile dafür geliefert hat: LLM kann einen Weg zur Lösung des Problems auf der Grundlage bekannter Informationen und verfügbarer Ressourcen vorschlagen; es kann über APIs und Codes mit Tools interagieren; Es kann dabei helfen, zu beurteilen, ob eine Schlussfolgerung durch vorhandene Beweise gestützt wird. Am wichtigsten ist, dass es einen unabhängigen „Schiedsrichter“ im System gibt, der jeden Argumentationsschritt danach bewertet, „wie viel Unsicherheit durch diesen Schritt beseitigt wird“ – und Überzeugungen nur dann aktualisiert, wenn sie durch Beweise gestützt werden. Sobald die Regeln festgelegt sind, kann das System zertifiziertes Wissen ansammeln, aus früheren Argumentationserfahrungen lernen und seine eigenen Argumentationsstrategien verbessern.
Graepel gab diesem Bild einen anschaulichen Ausdruck: die wissenschaftliche Methode zu Steroiden. Es gibt nur ein Ziel: Wissen zu produzieren, das einer genauen Prüfung standhält.
Größeres System 1,
System 2 wächst nicht automatisch
Am Ende des Artikels machte er seine Haltung klar: Vertrauenswürdige Maschinenintelligenz kann nicht durch die Vergrößerung von System 1 erreicht werden. Maßstab schärft die Intuition, aber nicht die Klugheit.
Der Grund, warum Zug 37 wichtig ist, liegt darin, dass eine Maschine eine Stellung verteidigt, die möglichen Zukünfte abgewogen und dann einen Zug ausgewählt hat, den selbst ihr eigenes „Bauchgefühl“ wahrscheinlich abgelehnt hätte.
Die menschliche Gesellschaft braucht mehr solcher „Hände Gottes“ in den Bereichen Arzneimittelentwicklung, neue Materialien, Klima und medizinische Diagnose. Das Schachbrett dort sah überhaupt nicht nach Go aus, und niemand gab uns die Regeln. Solche Erkenntnisse können nur aus Systemen gewonnen werden, die wirklich argumentieren: Schlussfolgerungen, die aus einer Kette überprüfbarer Beweise, Schlussfolgerungen und Glaubensrevisionen gezogen werden, und nicht aus einer überzeugenden Geschichte, die nachträglich ausgeheckt wird.
Vor zehn Jahren nutzte AlphaGo seine 37. Hand, um der Welt mitzuteilen, dass Maschinen die menschliche Intuition übertreffen können.
Zehn Jahre später erinnert uns einer seiner Schöpfer: Lassen Sie sich nicht von der glatten Sprache täuschen. Dieser wirkliche Sprung ist LLM bisher nicht noch einmal passiert.
Sie sagten, LLM könne nicht argumentieren
Ist es haltbar?
Nachdem dieser Meinungsartikel veröffentlicht wurde, löste er eine ziemliche Kontroverse zu X aus.
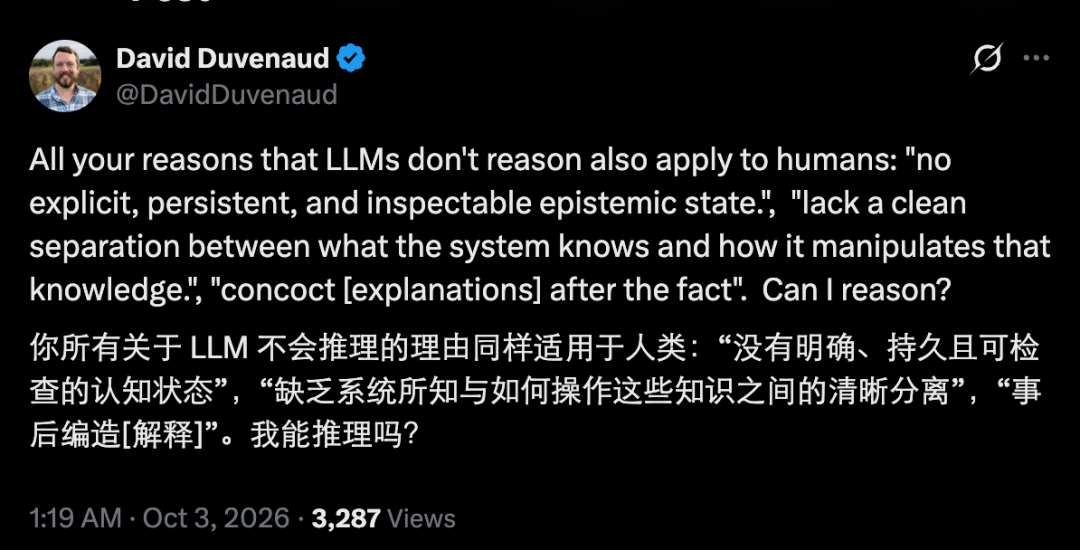
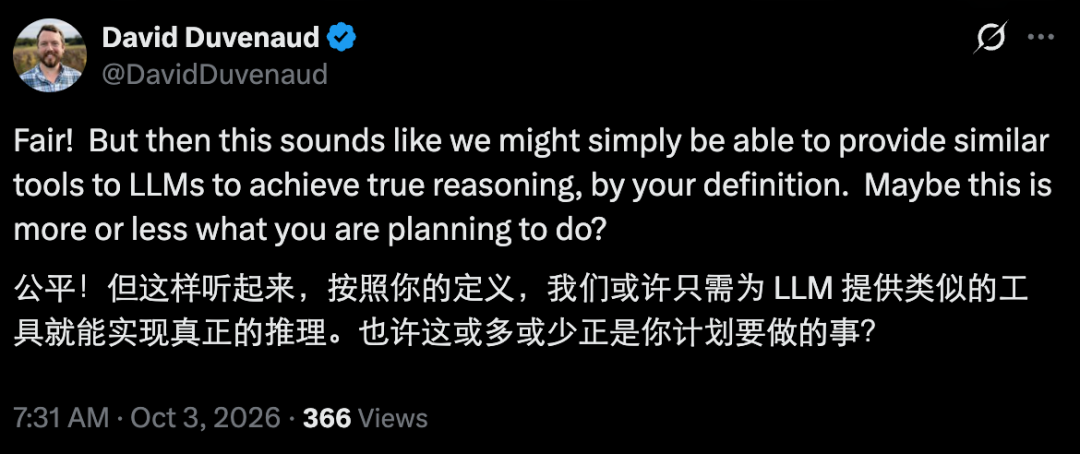
Die prägnanteste Frage kam von Professor David Duvenaud von der University of Toronto (einer der Autoren des besten Artikels von NeurIPS über neuronale ODE). Er erwähnte: Graepels drei Vorwürfe gegen LLM – kein überprüfbarer kognitiver Zustand, keine Trennung von Wissen und Argumentation und die Erfindung von Erklärungen im Nachhinein – gelten gleichermaßen für Menschen. „Kann ich nach diesem Standard als gut im Denken gelten?“
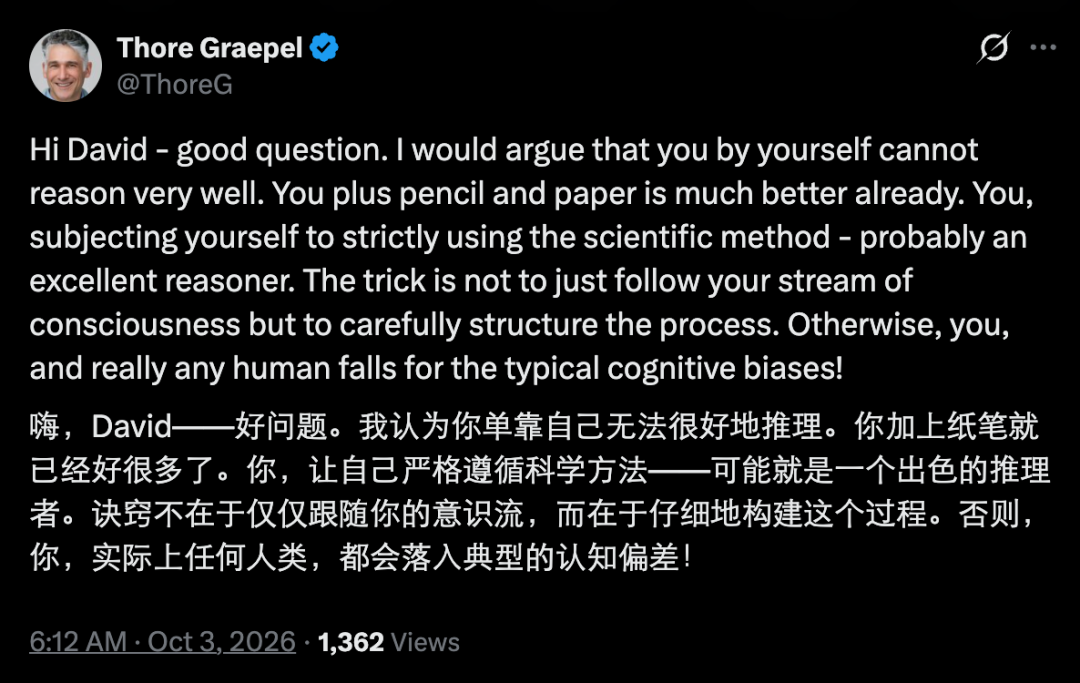
Graepel antwortete: „Man kann alleine nicht gut argumentieren; wenn man Papier und Stift bekommt, wird es viel besser sein; und wenn von Ihnen verlangt wird, dass Sie sich strikt an die wissenschaftliche Methode halten, gelten Sie als hervorragender Denker. Der Trick besteht darin, niemals dem Bewusstseinsstrom zu folgen, sondern den Prozess zu strukturieren – sonst kann niemand kognitiven Vorurteilen entkommen.
Duvenaud verstand sofort die Bedeutung dieses Satzes: „Es hört sich so an, als könnten wir echtes Denken gemäß Ihrer Definition erreichen, solange wir LLM mit ähnlichen Werkzeugen ausstatten – ist das nicht das, was Sie vorhaben?“
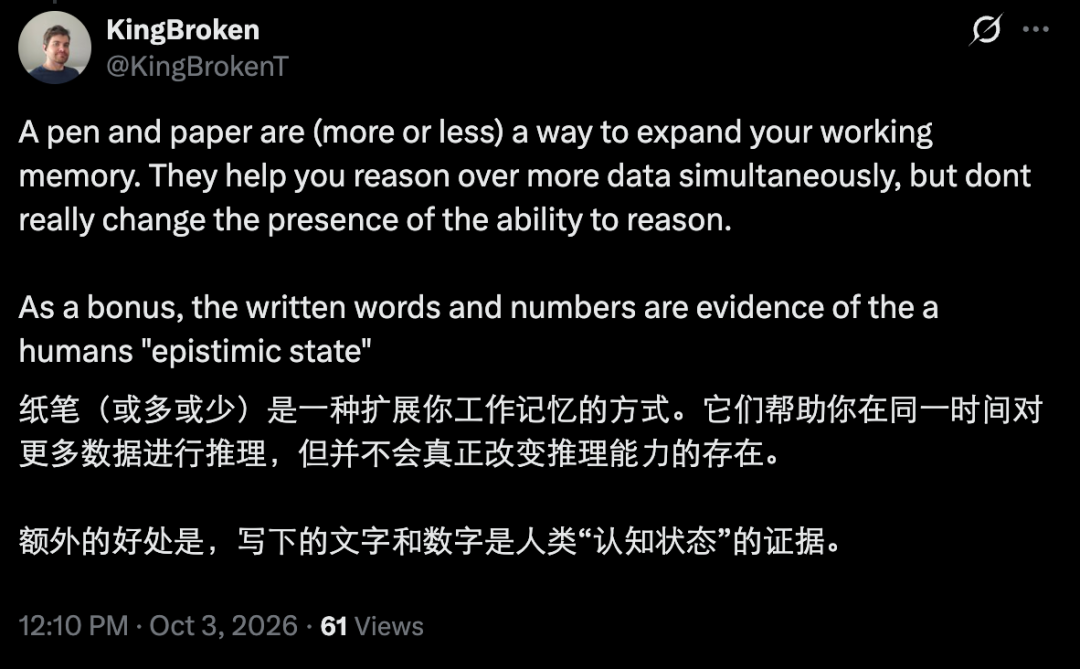
Graepels „Papier-und-Bleistift-Verbesserungstheorie“ löste auch bei anderen Internetnutzern Zweifel aus. Netizen KingBroken wies darauf hin, dass Papier und Stift im Wesentlichen ein Plug-in für das Arbeitsgedächtnis seien. Es ermöglicht Ihnen, gleichzeitig über mehr Daten nachzudenken, ändert jedoch nichts an der Existenz der Fähigkeit zum Denken „aus dem Nichts“; Aber es hat einen zusätzlichen Vorteil: Die geschriebenen Wörter und Zahlen sind zufällig ein überprüfbarer Beweis für den „kognitiven Status“ des Menschen.
Unmittelbar danach stellte der Internetnutzer Daniel Grant eine gezieltere Frage: Demnach entspricht die Methode des menschlichen Denkens dem „vorhandenen Modell + Plug-in-System“. Erstellen Sie also ein Modell mit stärkeren internen Denkfähigkeiten als beide? Oder übersehe ich eine Nuance?
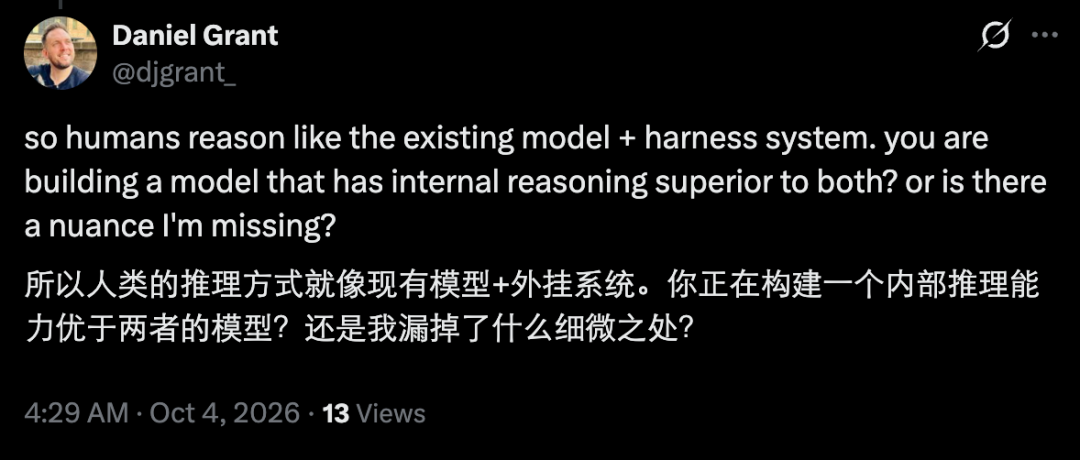
Graepel hat auf diese Anfragen noch nicht geantwortet.
Eine andere Stimme hielt diese Diskussion für unnötig. Netizen visimo-dino sagte unverblümt: „Ich kann nicht glauben, dass es immer noch Leute gibt, die Artikel dieser Art schreiben“: LLM hat bereits in zu vielen Dingen gute Leistungen erbracht, und die Aussage „kann nicht argumentieren“ ist entweder lächerlich oder irrelevant, und Hunderte ähnlicher Artikel wurden veröffentlicht.
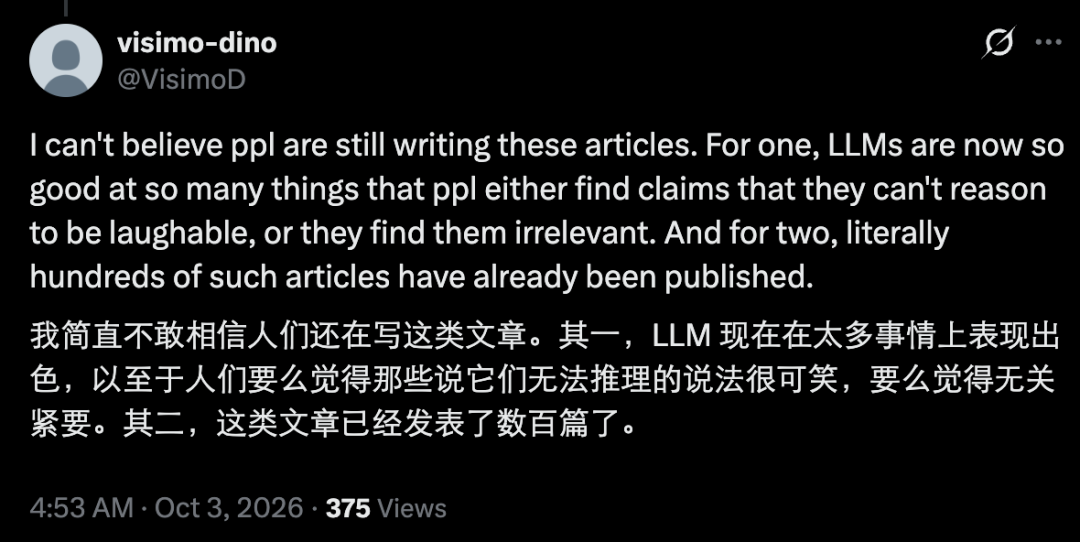
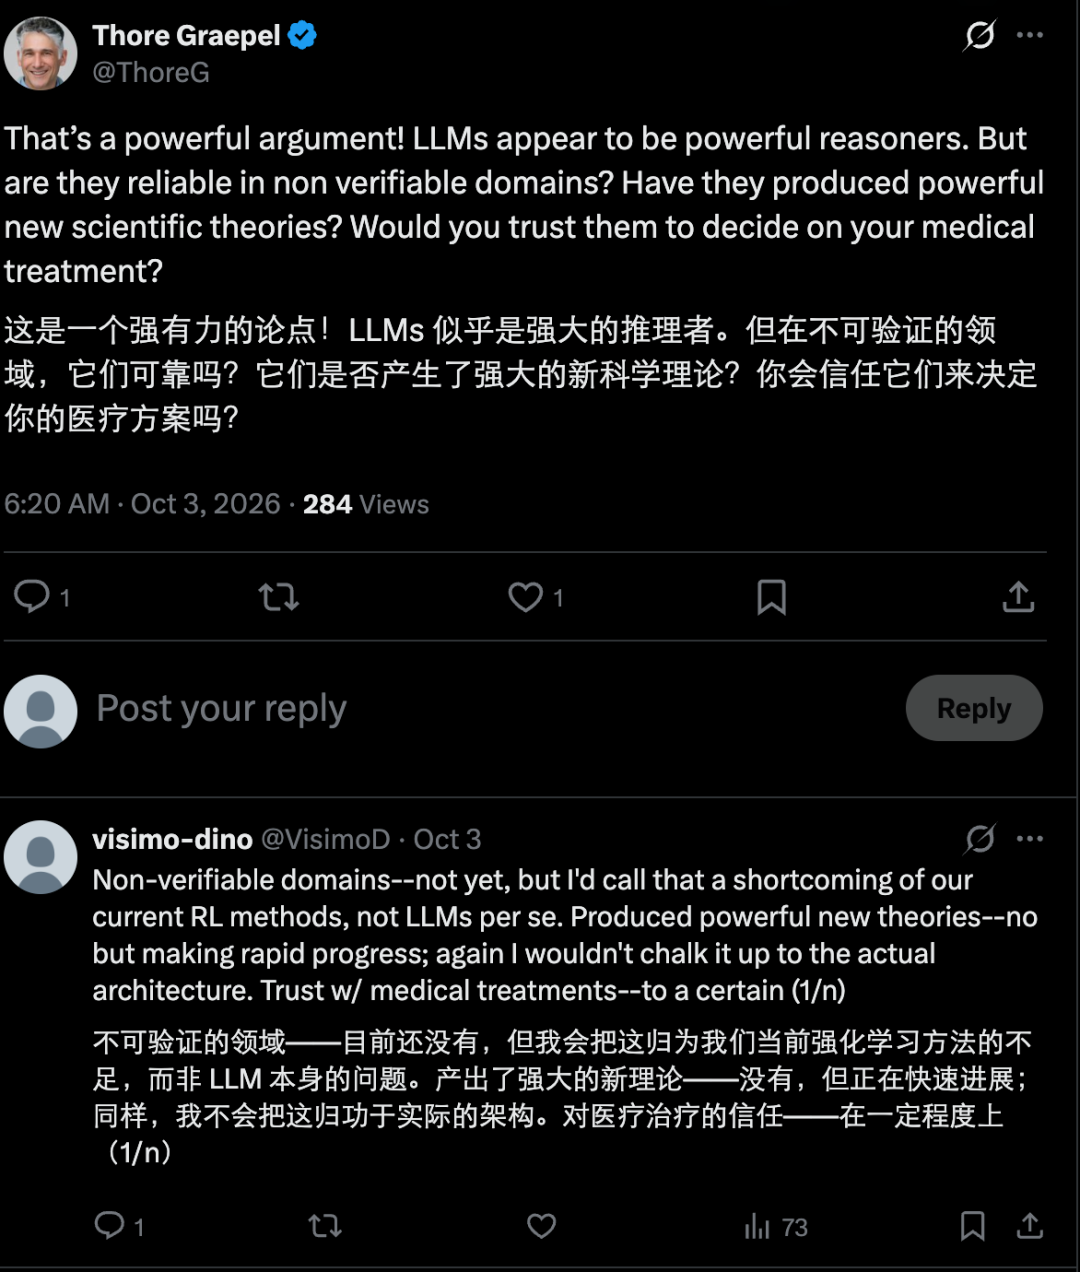
Graepel ging nicht weiter darauf ein, sondern warf nur drei Fragen zurück: Sind sie in Bereichen zuverlässig, in denen sie nicht verifiziert werden können? Hat es eine wirkungsvolle neue wissenschaftliche Theorie hervorgebracht? Trauen Sie sich, Ihre medizinische Behandlung davon diktieren zu lassen? Die andere Partei war offen und gab zu, dass dies „noch nicht der Fall“ sei, machte aber eher die bestehenden Reinforcement-Learning-Methoden als die LLM-Architektur selbst dafür verantwortlich – die Implikation ist, dass das Problem mit der Zeit gelöst wird. Dies ist wahrscheinlich der eigentliche Unterschied zwischen den beiden Gruppen: Die eine Seite denkt, dass es an Zeit mangelt, und die andere Seite denkt, dass es an Struktur mangelt.
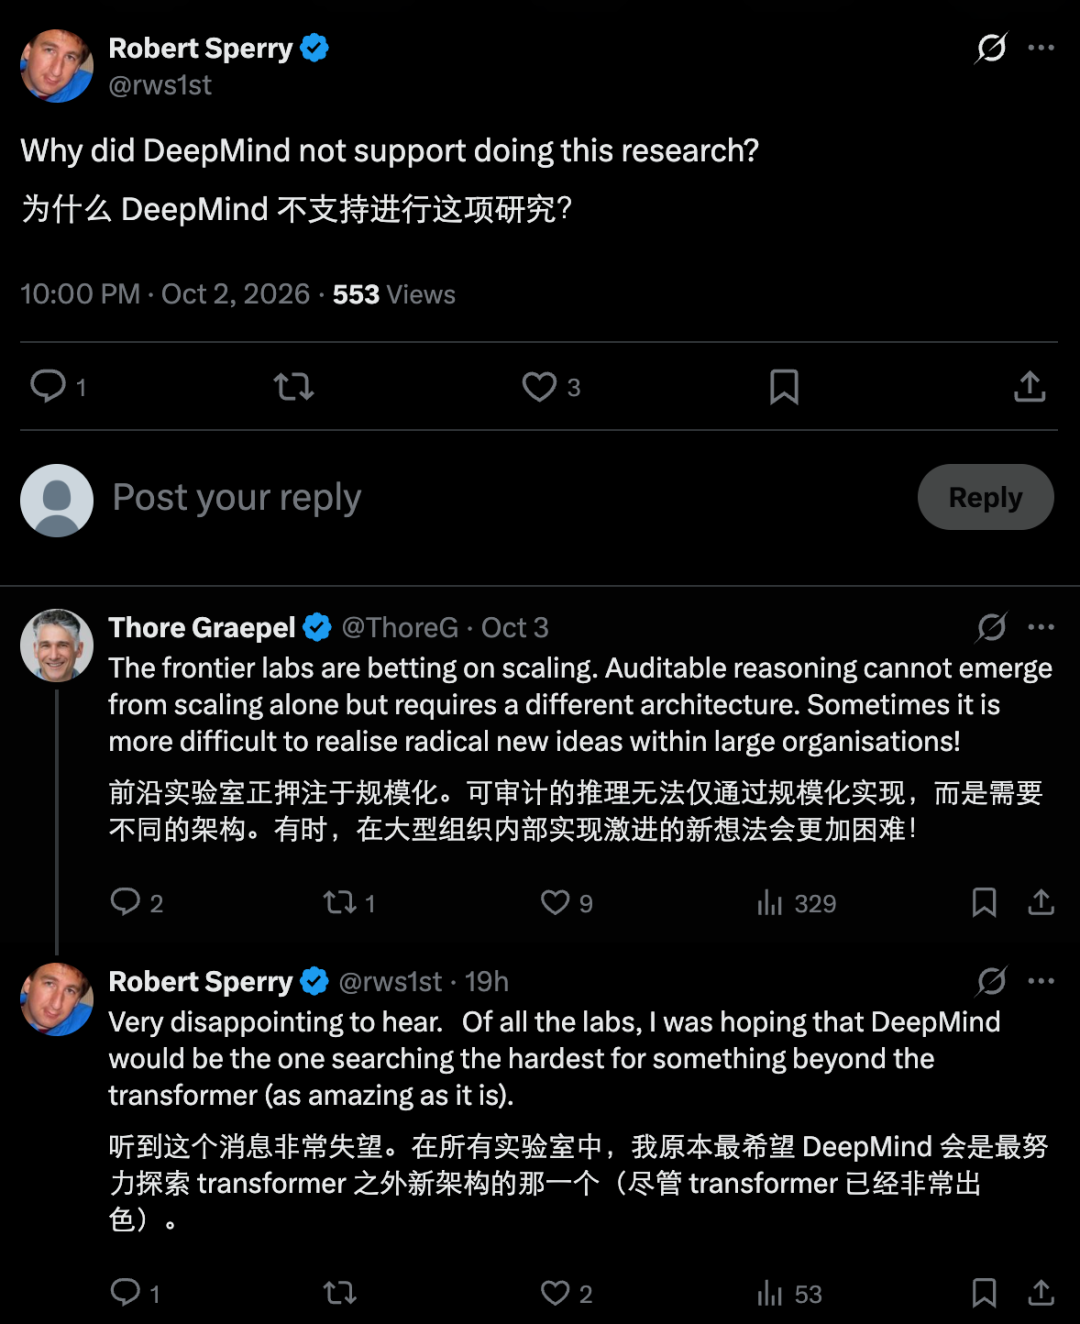
Ein anderer Kommentar fragte, was viele Leute denken: Warum unterstützt DeepMind diese Forschung nicht? Graepels Antwort ist eindeutig: Spitzenlabore setzen auf Skalierung, und durch Skalierung allein kann keine nachprüfbare Schlussfolgerung entstehen. Es erfordert eine andere Architektur. „Manchmal sind radikal neue Ideen in großen Organisationen schwieriger umzusetzen.“ Die Enttäuschung des Fragestellers Robert Sperry war spürbar: Von allen Laboren hatte er erwartet, dass DeepMind dasjenige sein würde, das am härtesten daran arbeitet, Antworten über Transformer hinaus zu finden.
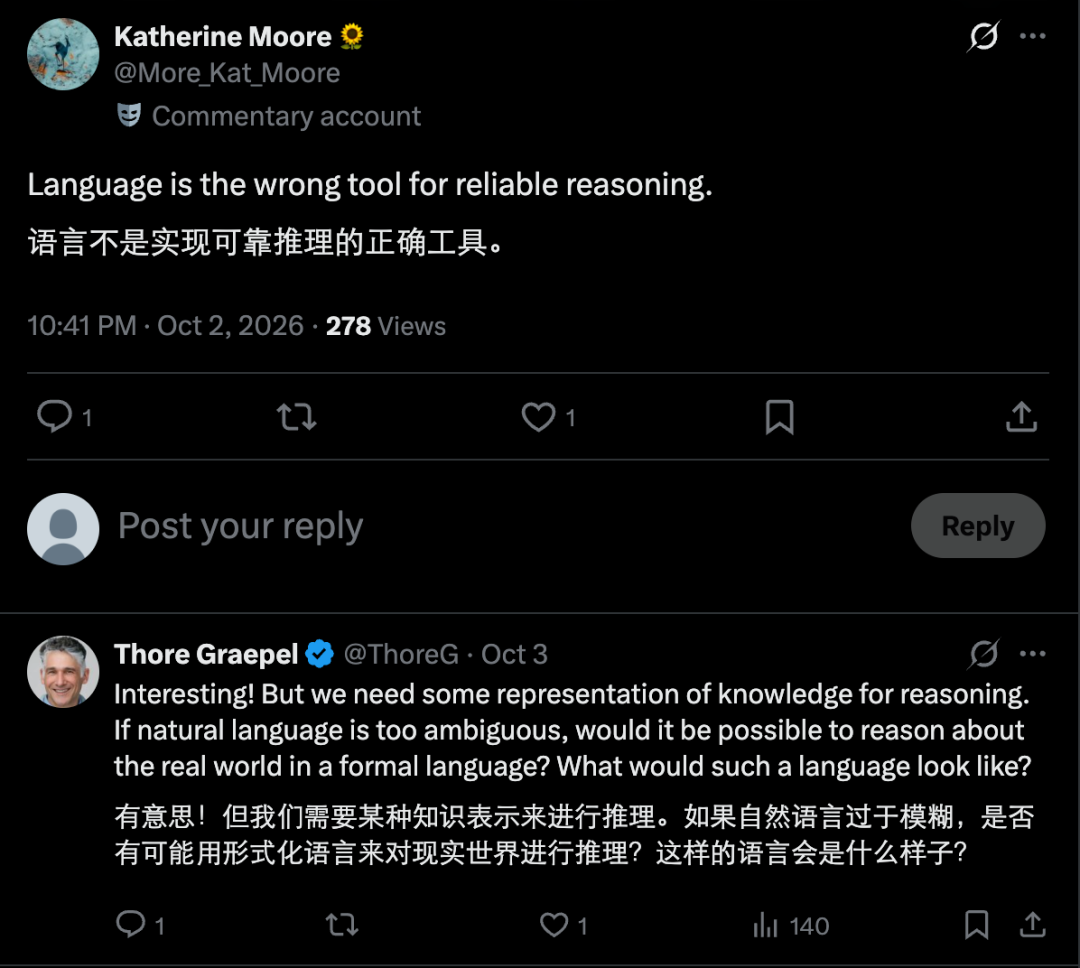
Einige Leute zeigten auch mit dem Finger auf eine grundlegendere Stelle. Kommentatorin Katherine Moore hinterließ nur einen Satz: „Sprache selbst ist das falsche Werkzeug, und mit ihr kann man keine verlässlichen Schlussfolgerungen ziehen.“ Graepel nahm diese radikalere Position ernst und warf eine offene Frage auf: Argumentation erfordert tatsächlich eine Art Wissensrepräsentation. Wenn natürliche Sprache zu vage ist, kann dann formale Sprache verwendet werden, um über die reale Welt nachzudenken? Wie würde eine solche Sprache aussehen? . Er gab keine Antwort, aber das könnte die Frage sein, die einige Leute beantworten werden, wenn sie ihr eigenes Unternehmen gründen.
Kommentare