
Zusammenfassung:
Während sich künstliche Intelligenz von herkömmlichen Chatbots zu Agenten (KI-Agenten) entwickelt, die autonom Aufgaben planen, Tools aufrufen und komplexe Arbeitsabläufe ausführen können, ändern sich auch die Rechenanforderungen von Rechenzentren. AMD hat am 12. Oktober 2026 offiziell das Helion-KI-Computing-Referenzdesign auf Rack-Ebene veröffentlicht und eine neue Infrastrukturlösung vorgeschlagen, die die CPU als Kern nutzt und je nach Bedarf mit GPUs gepaart werden kann.
Seine reine CPU-Konfiguration kann bis zu 32.768 AMD EPYC-Prozessorkerne integrieren und ist darauf ausgelegt, eine Ausführungsumgebung für große KI-Agenten bereitzustellen, anstatt alle Rechenressourcen auf GPU-Beschleuniger zu konzentrieren.
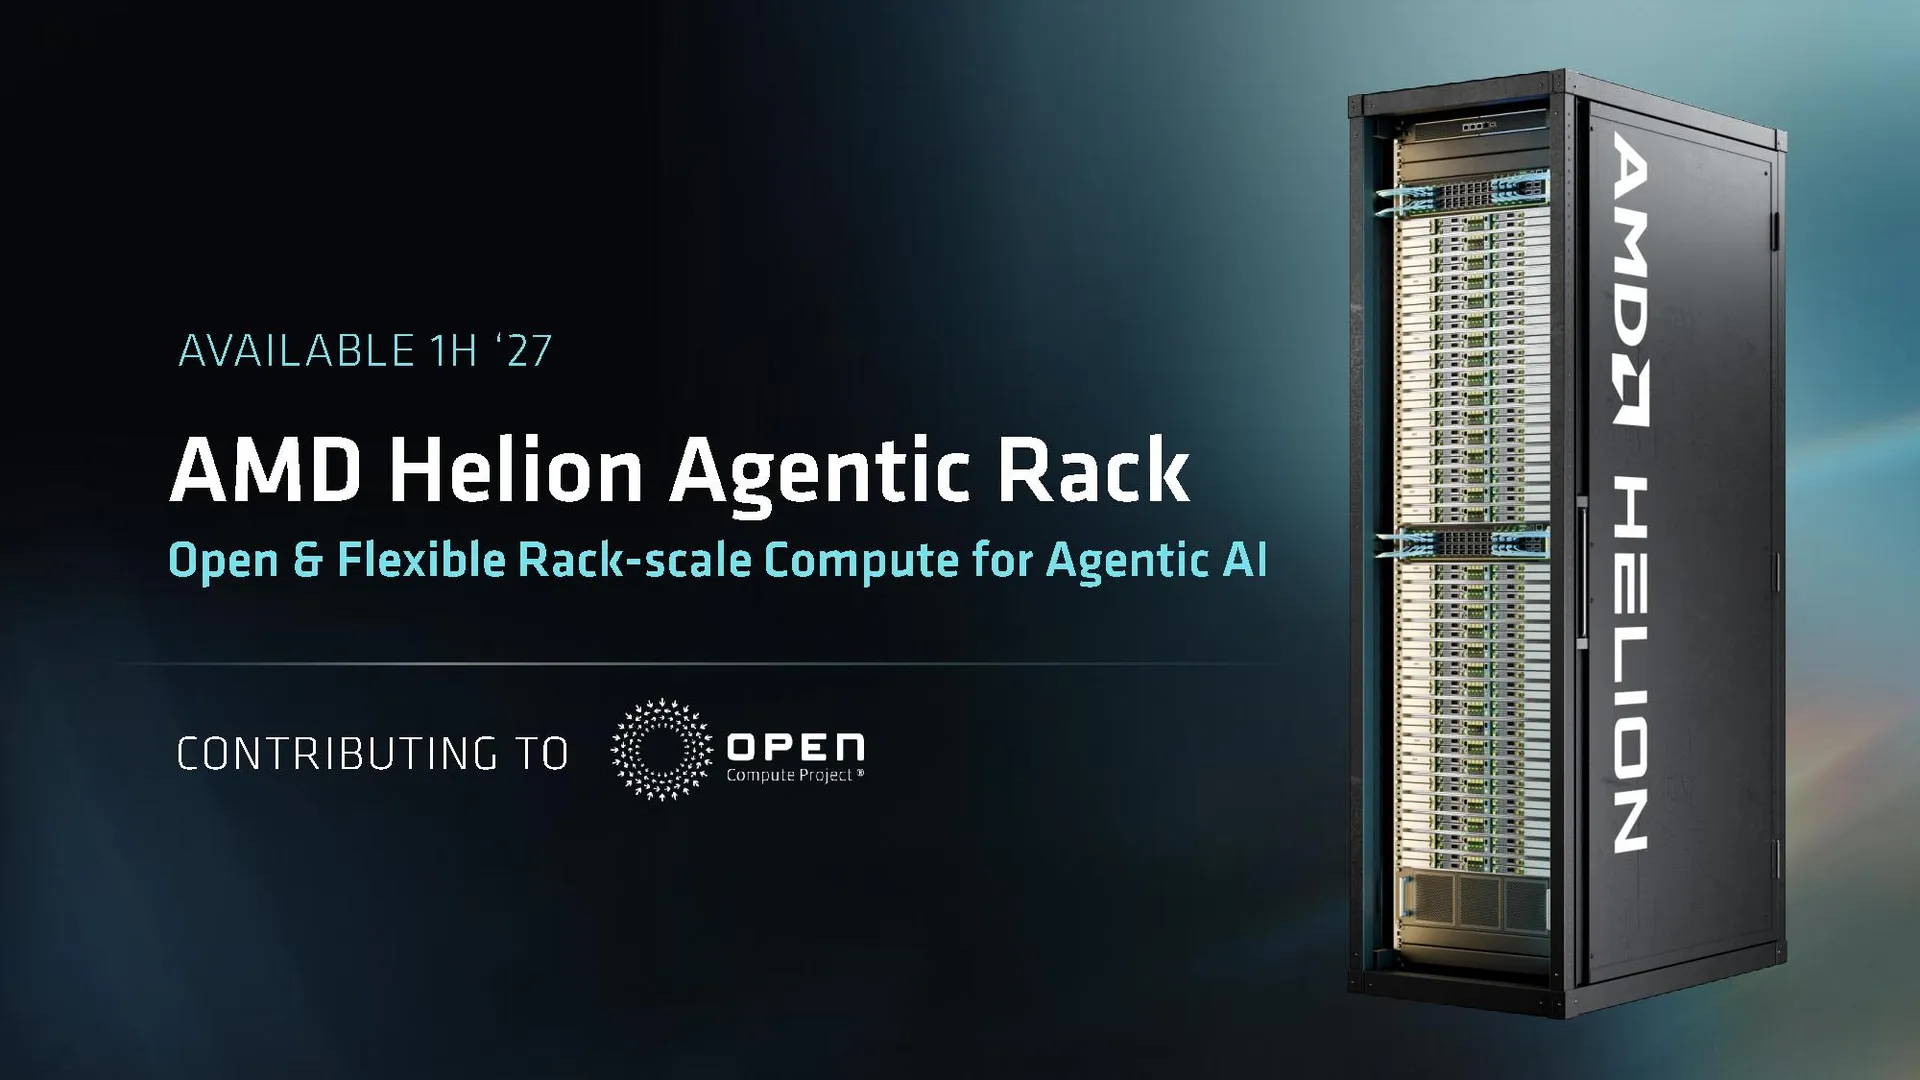
Der von AMD veröffentlichte Helion ist dieses Mal kein eigenständiger Chip und auch kein komplettes Serverprodukt, das Benutzer direkt erwerben können, sondern ein offenes Rack-Referenzdesign für Rechenzentren. AMD plant, relevante Spezifikationen zum Open Compute Project (OCP) beizutragen, damit diese von Partnern weiter entwickelt und übernommen werden können. Hersteller wie Dell, Hewlett Packard Enterprise, Lenovo, AMD und Foxconn werden sich an der Entwicklung verwandter Systeme beteiligen, und die von Partnern erstellte Helion-Konfiguration soll im November 2026 auf den Markt kommen.
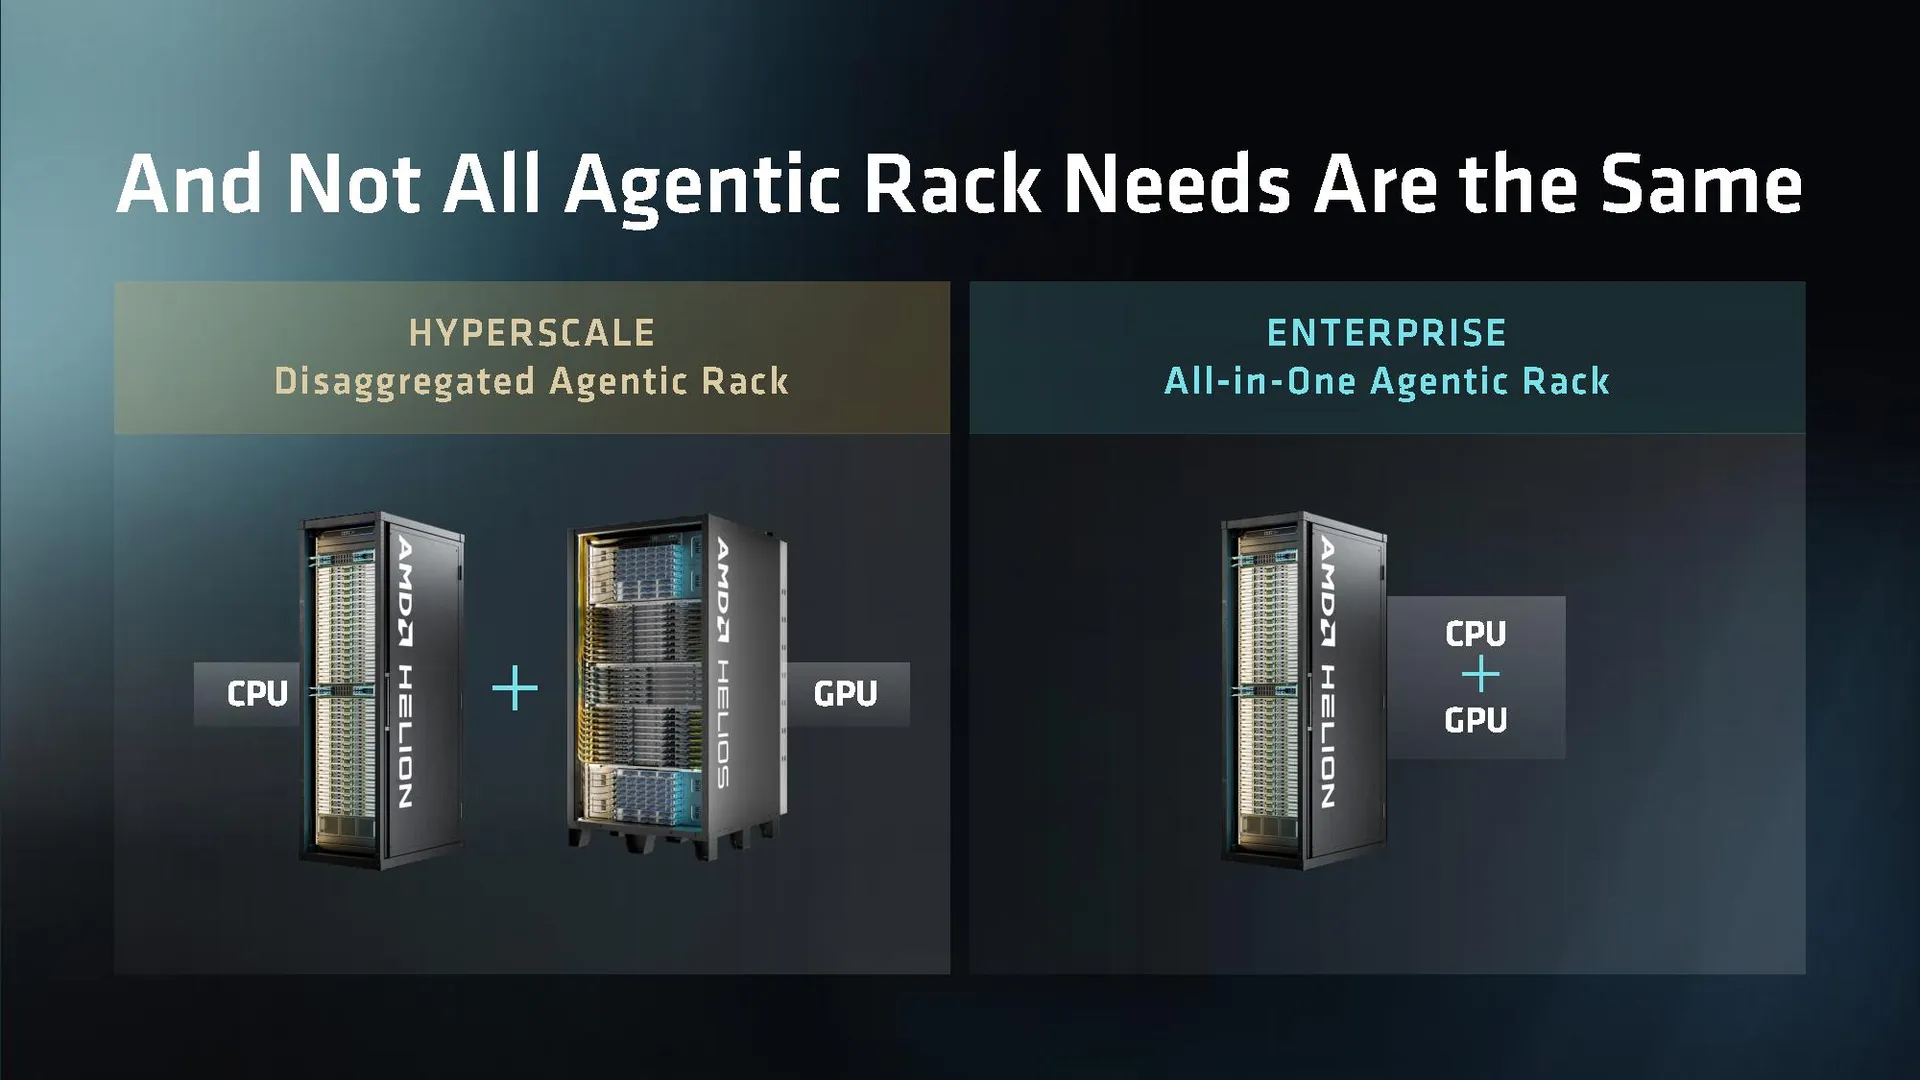
Die Kernidee dieser Lösung besteht darin, CPU, GPU, Netzwerk und andere Computerressourcen entsprechend den verschiedenen Phasen des KI-Agent-Workflows flexibel zu konfigurieren. Für sehr große Rechenzentren, die eine große Anzahl von Agenten ausführen, Code ausführen oder komplexe Geschäftsprozesse verarbeiten müssen, können Kunden reine CPU-Racks wählen; Benutzer, die die Ausführung von Agenten, die Modellinferenz und allgemeine Computeraufgaben für Unternehmen mit derselben Ausrüstung erledigen möchten, können eine Hybridkonfiguration aus CPU und GPU wählen.
Dieses Design spiegelt die entstehende neue Arbeitsteilung in der KI-Infrastruktur wider. Die GPU ist immer noch ein wichtiges Rechengerät für umfangreiches Modelltraining und hochintensive Inferenzen. Wenn KI-Agenten jedoch tatsächlich Aufgaben ausführen, benötigen sie auch eine große Menge an CPU-Ressourcen, um Programme auszuführen, auf Datenbanken zuzugreifen, externe Tools aufzurufen, den Aufgabenstatus zu verwalten und mehrere Rechenschritte zu koordinieren. Wenn die Anzahl der Agenten zunimmt, können diese Aufgaben zu neuen Ressourcenengpässen im Rechenzentrum führen.
Dan McNamara, Senior Vice President und General Manager der Computing and Enterprise AI Division von AMD, sagte, dass es sich bei der Agenten-KI nicht um eine einzelne Art von Arbeitslast handelt, sondern um eine Vielzahl von Szenarien wie persönliche Agenten, Unternehmensanwendungen, Codeausführung und komplexe Arbeitsabläufe. Jede Aufgabe stellt unterschiedliche Anforderungen an die Rechenressourcen. Daher benötigen Rechenzentren eine Infrastruktur, die Leistung, Kerndichte und Stromverbrauch basierend auf spezifischen Arbeitslasten anpassen kann.
Er sagte, dass AMD hofft, Helion nutzen zu können, um die Leistung von EPYC-Prozessoren, ein offenes Software-Ökosystem und ein flexibles Rack-Design zu kombinieren, damit Partner Systeme entsprechend den Kundenbedürfnissen bauen und begrenzte Energieressourcen effizienter nutzen können.
Helions auffälligste Konfiguration ist ein reines CPU-Rack, das bis zu 32.768 CPU-Kerne aufnehmen kann. Die Lösung nutzt AMDs EPYC-Serverprozessor der sechsten Generation, die Kernarchitektur ist Zen 6 und trägt den Codenamen Venice. Dem von AMD angekündigten Design zufolge können im gesamten Rack bis zu 128 256-Kern-Prozessoren verbaut werden, was theoretisch einen Rechencluster mit 32.768 CPU-Kernen bildet.
Hier ist zu beachten, dass die 32768 Kerne nicht in einem Prozessor integriert sind, sondern sich aus Prozessoren in einer Vielzahl von Serverknoten zusammensetzen. Helion verwendet ein Rack-Level-Design, um mehrere Rechenknoten, Netzwerkgeräte und zugehörige Infrastruktur zu einem Ganzen zu integrieren und so eine zentrale Bereitstellung und Verwaltung im Rechenzentrum zu ermöglichen.
Dieses Design eignet sich besonders für Szenarien, in denen eine große Anzahl unabhängiger oder paralleler Aufgaben ausgeführt werden muss. Beispielsweise kann ein Unternehmen Zehntausende von KI-Agenten gleichzeitig ausführen, und jeder Agent benötigt eine unabhängige Ausführungsumgebung, um Code auszuführen, Daten abzurufen, die interne API des Unternehmens aufzurufen oder komplexe Aufgaben zu verarbeiten, die ihm von Benutzern zugewiesen wurden. Im Vergleich zur einfachen Modellinferenz erfordert diese Art von Arbeitsablauf in der Regel mehr routinemäßige Programmausführungs- und Systemkoordinationsvorgänge und erfordert daher ausreichend CPU-Rechenleistung.
In herkömmlichen Modellanwendungen für große Sprachen generiert das Modell eine Antwort, nachdem der Benutzer eine Frage eingegeben hat, und die Rechenlast konzentriert sich hauptsächlich auf die Modellinferenzphase. Aber in einer Agentenanwendung kann eine Anfrage eine Kette von Vorgängen auslösen: Der Agent analysiert die Aufgabe, ruft dann ein Suchtool oder eine Datenbank auf, führt dann den Code aus, prüft die Ergebnisse, ruft bei Bedarf das Modell erneut auf und generiert schließlich eine Antwort.
In diesem Prozess ist die GPU für die Ausführung hochparalleler Rechenaufgaben wie Modellinferenz verantwortlich, während die CPU für eine große Anzahl von Programmausführungen, Datenverarbeitung, Aufgabenplanung und Toolaufrufen verantwortlich ist. Wenn die Anzahl der Agenten weiter zunimmt, können unzureichende CPU-Ressourcen die Verarbeitungsgeschwindigkeit des gesamten Systems einschränken, selbst wenn die GPU über ausreichende Argumentationskapazitäten verfügt.
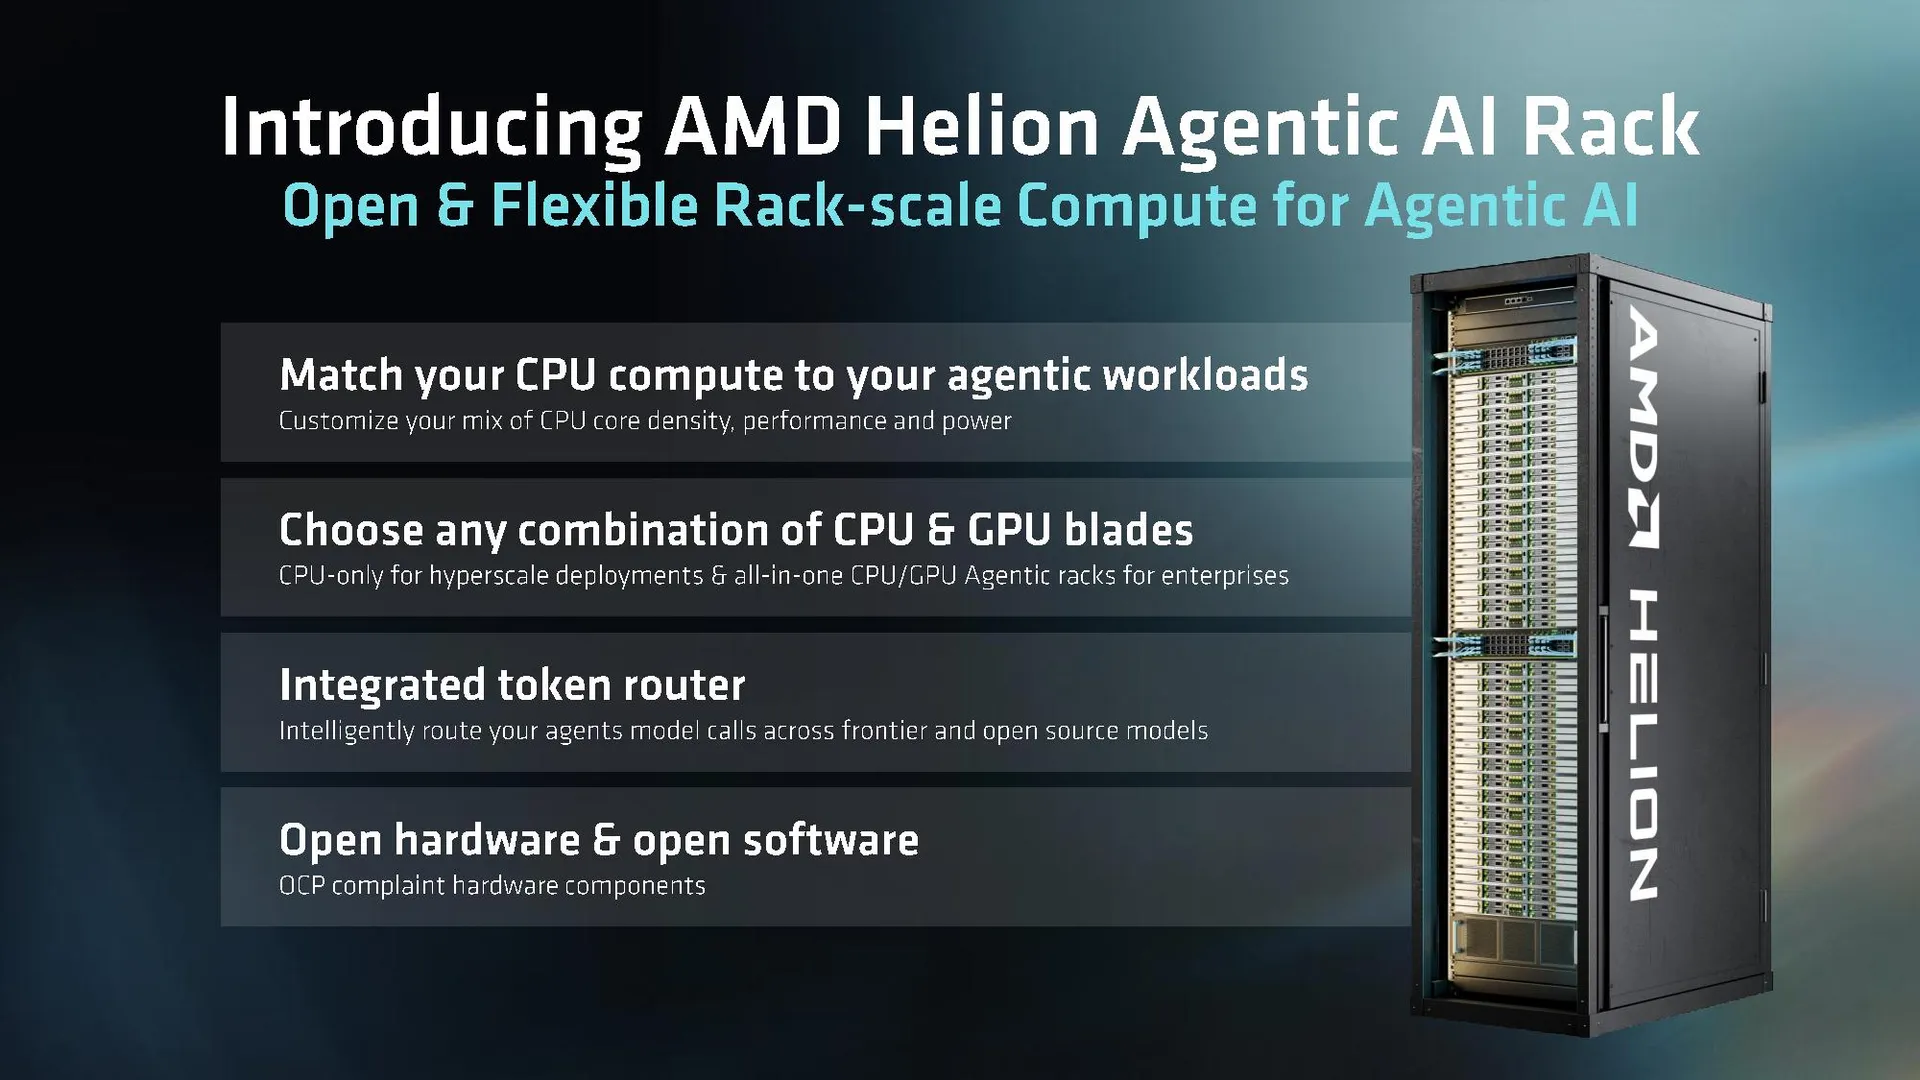
AMD hofft, dieses Problem durch die reine CPU-Konfiguration Helion zu lösen, die eine umfangreiche und skalierbare Ausführungsumgebung für Agenten bereitstellt und gleichzeitig die Modellinferenz für die Verarbeitung der unabhängigen GPU-Infrastruktur überlässt.
Das bedeutet, dass Helion nicht versucht, die GPU vollständig durch die CPU zu ersetzen, sondern versucht, die Verantwortlichkeiten der beiden weiter zu trennen. Für sehr große Cloud-Dienstanbieter ermöglicht dieses Design, dass verschiedene Arten von Arbeitslasten für sie geeignetere Rechenressourcen nutzen, wodurch verhindert wird, dass teure GPUs durch eine große Anzahl gewöhnlicher Programmausführungsaufgaben belegt werden.
Neben der reinen CPU-Version bietet Helion auch Konfigurationen auf Unternehmensebene an, die CPU und GPU kombinieren. Diese Lösung kann AMD EPYC-Prozessoren, Instinct MI350P GPU-Beschleuniger und Allzweck-Rechenknoten im selben Rack integrieren, sodass Unternehmen Agenten ausführen, Modellinferenzen durchführen und Datenbanken, Speicher und andere allgemeine Rechenaufgaben in derselben Infrastruktur verwalten können.
Laut dem von AMD angekündigten Design kann die Hybridkonfiguration mit bis zu 16 Instinct MI350P GPU-Beschleunigern ausgestattet werden und eine Netzwerkbandbreite von bis zu 102 Tbit/s bereitstellen. Die Netzwerkbandbreite ist hier der Entwurfsindikator des gesamten Systems und bedeutet nicht, dass jeder Rechenknoten unabhängig voneinander die gleiche Bandbreite erhalten kann. Die tatsächliche Kommunikationsleistung hängt auch von der Netzwerktopologie, der Portkonfiguration, der Verkehrsverteilung und der Systemsoftware ab.
In Bezug auf GPU-Knoten bietet AMD ein 5U-Serverdesign mit acht Instinct MI350P-Beschleunigern. Durch die Kombination von GPU-Rechenknoten mit CPU-Knoten können Unternehmen die Anzahl der Beschleuniger basierend auf bestimmten Aufgaben anpassen, ohne das gesamte System auf eine einzige Hardwarekonfiguration festlegen zu müssen.
Systeme, die beispielsweise große Mengen an Unternehmensdaten verarbeiten und komplexe Arbeitsabläufe ausführen müssen, können mehr CPU-Kerne zuweisen; Systeme, die eine Modellinferenz mit hohem Durchsatz erfordern, können die GPU-Ressourcen erhöhen. Hilfsarbeitslasten wie Datenbanken und Speicher können auch dedizierte Allzweck-Rechenknoten nutzen, wodurch der Wettbewerb um Ressourcen zwischen ihnen und den vom Agenten ausgeführten Aufgaben verringert wird.
AMD hat außerdem eine Vielzahl von CPU-Rechenknoten mit unterschiedlichen Positionen für Helion entwickelt, um unterschiedliche Anforderungen in Bezug auf Stromverbrauch, Kerndichte und Einzelkernleistung zu erfüllen.
Knoten mit hoher Dichte verwenden Prozessoren der EPYC 9006-Serie mit einem Nennstromverbrauch von 400 Watt, die hauptsächlich zur Maximierung der Anzahl der CPU-Kerne pro Raumeinheit verwendet werden. Der Balanced Node verwendet einen 256-Core-Prozessor mit einer Nennleistungsaufnahme von 600 Watt, um ein Gleichgewicht zwischen Kerndichte und Gesamtrechenleistung zu erreichen.
Für Workloads, die mehr Wert auf Single-Threaded-Leistung legen, bietet AMD auch eine Prozessorkonfiguration mit 96 Kernen und einer maximalen Frequenz von 5 GHz an. Im Vergleich zur einfachen Verfolgung der Anzahl der Kerne eignet sich dieser Knotentyp besser für Aufgaben, bei denen es auf die Leistung und Reaktionsgeschwindigkeit eines einzelnen Threads ankommt.
Dieses differenzierte Design spiegelt eine wichtige Realität wider: KI-Agenten benötigen nicht immer so viele CPU-Kerne. Einige Aufgaben können in eine große Anzahl paralleler Vorgänge aufgeteilt werden, was für Server mit hoher Kerndichte geeignet ist. Andere Aufgaben sind durch die Single-Thread-Leistung, die Speicherlatenz oder die Reaktionsgeschwindigkeit externer Dienste begrenzt, und eine einfache Erhöhung der Anzahl der Kerne kann keine entsprechenden Leistungsverbesserungen bewirken.
Daher versucht Helion, Rechenzentrumsbetreibern die Auswahl unterschiedlicher Prozessorkonfigurationen basierend auf der tatsächlichen Arbeitslast zu ermöglichen, anstatt alle Szenarien mit einer Spezifikation abzudecken.
In Bezug auf die Wärmeableitung unterstützt Helion sowohl Luftkühlungs- als auch Flüssigkeitskühlungslösungen. Bei Racks mit Zehntausenden von CPU-Kernen und integrierter Hochgeschwindigkeits-Netzwerkausrüstung sind Stromversorgung und Wärmeableitungsdesign technische Probleme, die nicht ignoriert werden dürfen. Server mit hoher Dichte können die Raumnutzung im Computerraum verbessern, bringen aber auch eine höhere Wärmebelastung pro Raumeinheit mit sich.
Flüssigkeitskühlung kann Systemen helfen, die von Prozessoren und anderen Hochleistungskomponenten erzeugte Wärme effizienter abzuleiten, erfordert aber auch eine unterstützende Kühlinfrastruktur, Rohrleitungsdesign und Wartungsprozesse. Für einige Kunden, die bestehende Rechenzentrumseinrichtungen weiterhin nutzen möchten, ist Luftkühlung möglicherweise besser geeignet. AMD bietet zwei Lösungen an, was bedeutet, dass Partner je nach Computerraumbedingungen, Bereitstellungsumfang und Betriebskosten wählen können.
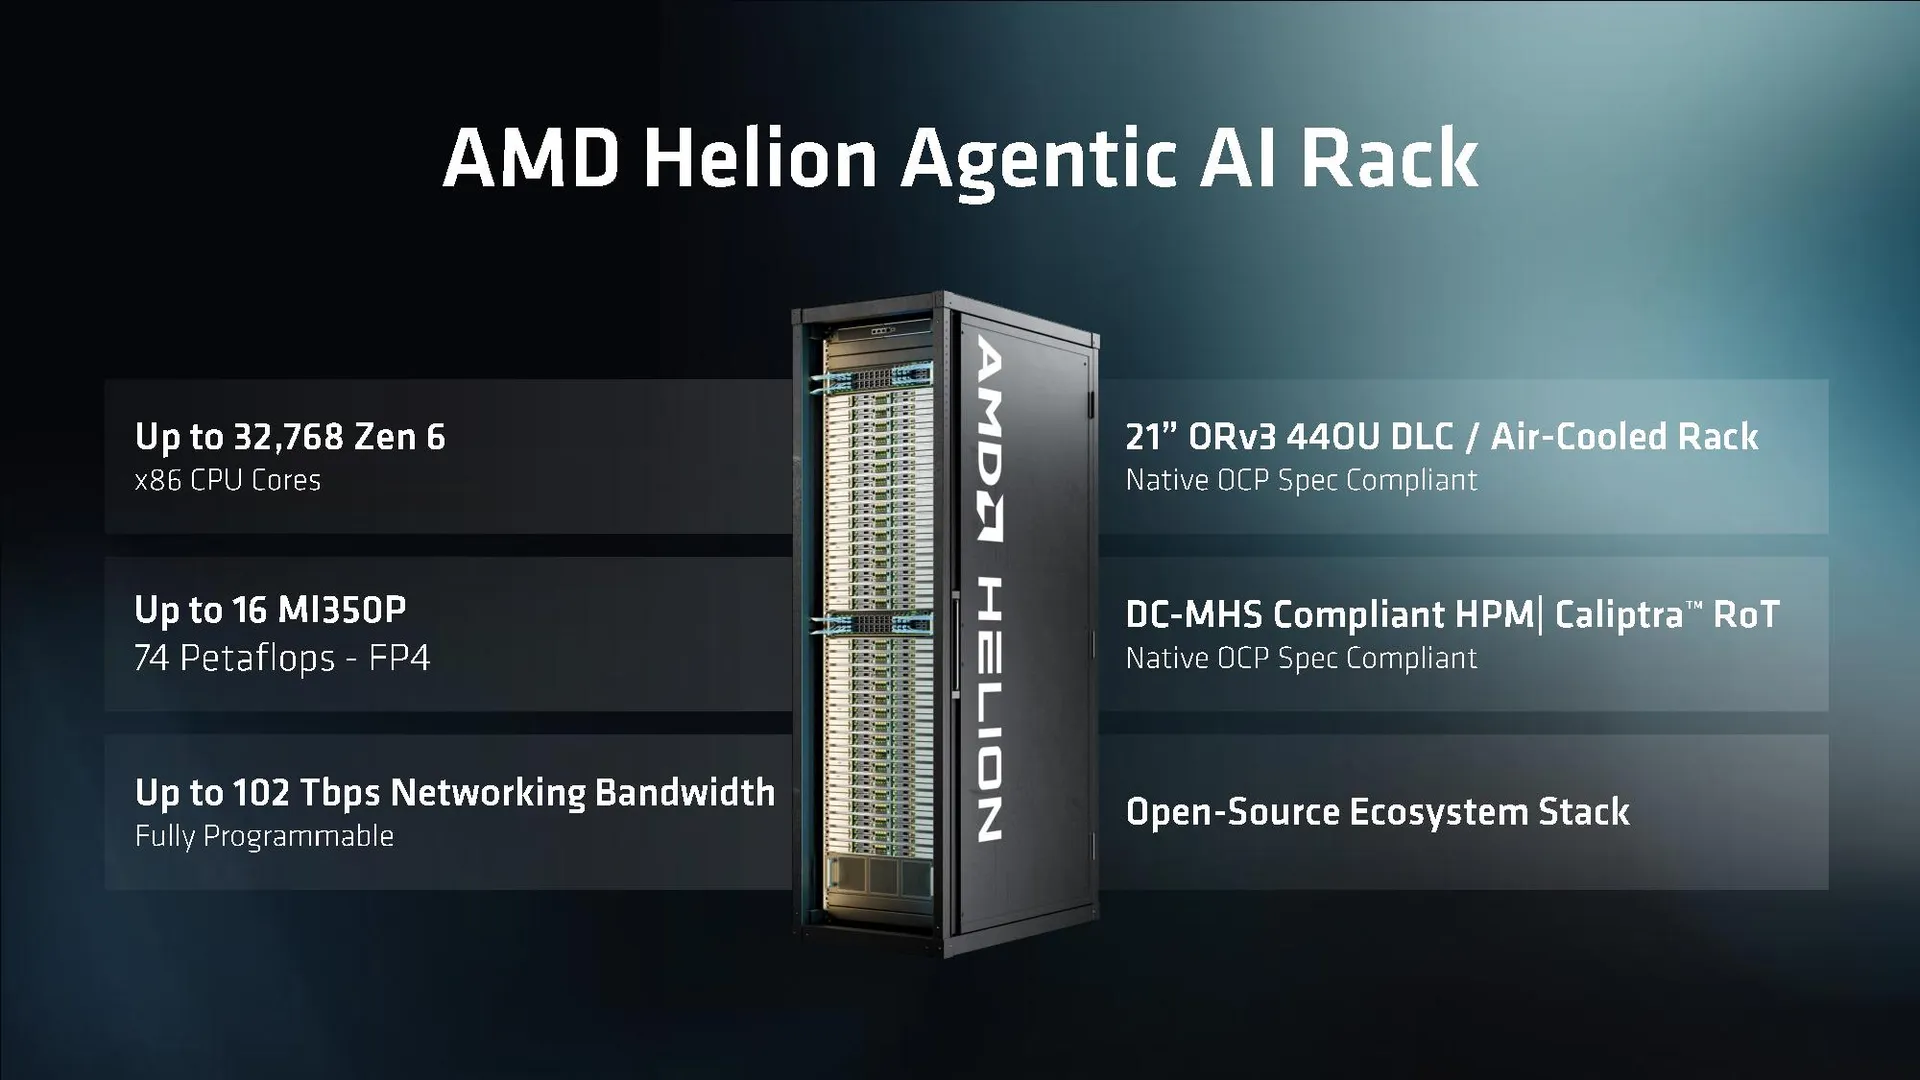
Neben der Hardwarekonfiguration legt Helion auch Wert auf offene Software und Systemdesign. AMD plant, relevante Referenzspezifikationen zu OCP beizutragen, damit Partner auf einer gemeinsamen Designbasis entwickeln können, anstatt sich ausschließlich auf geschlossene Systeme eines einzelnen Herstellers zu verlassen.
OCP ist eine Branchenorganisation, die das offene Hardware-Design für Rechenzentren fördert. Zu den Teilnehmern zählen Cloud-Dienstleister, Serverhersteller und andere Infrastrukturanbieter. Offene Referenzdesigns können verschiedenen Herstellern dabei helfen, Systeme anhand gemeinsamer Hardwarespezifikationen zu integrieren und je nach Kundenanforderungen unterschiedliche Konfigurationen bereitzustellen.
AMD hofft, das Helion-Ökosystem auf diese Weise zu erweitern und es Dell, Hewlett Packard Enterprise, Lenovo, AMD, Foxconn und anderen Partnern zu ermöglichen, ihre eigenen Produkte zu entwickeln. Was Kunden letztendlich kaufen, sind Serversysteme, die von Partnern hergestellt und integriert werden, anstatt einen kompletten Satz standardisierter Racks direkt von AMD zu kaufen.
AMD sagte, die Helion-Konfiguration werde derzeit mit Ökosystempartnern entwickelt und soll im November 2026 auf den Markt kommen. Die relevanten Designs müssen noch die Systemintegration, Verifizierung und tatsächliche Bereitstellung durchlaufen. Welche Konfigurationen endlich bereitgestellt werden können, wann sie in großem Umfang ausgeliefert werden und welche spezifischen Produktspezifikationen die verschiedenen Hersteller haben, wird später noch bekannt gegeben.
Aus Sicht des Marktwettbewerbs spiegelt Helion auch wider, dass AMD die Rolle von EPYC-Prozessoren in der KI-Infrastruktur weiter ausbaut.
In den letzten Jahren konzentrierte sich der Bau von KI-Rechenzentren hauptsächlich auf Bereiche wie GPU-Beschleuniger, Serververbindung und Speicher mit hoher Bandbreite. Da die Nachfrage nach groß angelegtem Modelltraining und Inferenz schnell wächst, hat sich NVIDIA mit seinen GPU-Produkten und seinem Software-Ökosystem klare Marktvorteile erarbeitet.
Aber da KI-Anwendungen nach und nach in die Geschäftsprozesse von Unternehmen Einzug halten, sind die Aufgaben, die Rechenzentren bewältigen müssen, nicht mehr nur Modellberechnungen. Agenten müssen möglicherweise eine große Anzahl von Programmen ausführen, auf Datenbanken zugreifen, Dokumente verarbeiten, Code ausführen und mehrere Modelle gleichzeitig koordinieren. Diese Vorgänge stellen neue Anforderungen an die CPU-Ressourcen.
AMD hofft, bei diesem Infrastrukturwandel mit Hilfe von High-Core-EPYC-Prozessoren weitere Marktchancen zu gewinnen. Durch die Kombination von CPU-Kerndichte, GPU-Beschleunigung und Netzwerkdesign im Rack-Maßstab versucht Helion, eine offene Plattform bereitzustellen, die sich an unterschiedliche Agenten-Workloads anpassen kann.
Natürlich können 32.768 CPU-Kerne allein nicht direkt die tatsächliche Leistung des Systems erklären. Die endgültige Leistung hängt auch von der Mikroarchitektur des Prozessors, der Speicherbandbreite, der Cache-Kapazität, der Kommunikation zwischen Knoten, der Effizienz der Softwareplanung und dem Grad der Parallelität der Arbeitslast ab. Bei Aufgaben, die stark auf große Modellinferenzen angewiesen sind, kann die GPU immer noch ein entscheidender Faktor bei der Bestimmung des Systemdurchsatzes sein.
Ebenso bedeutet eine Erhöhung der Anzahl der CPU-Kerne nicht, dass Agentenaufgaben proportional beschleunigt werden. Wenn eine große Anzahl von Aufgaben auf Datenbankantworten warten, auf externe Netzwerke zugreifen oder andere Dienste aufrufen müssen, kann sich der Systemengpass auf die Speicher-, Netzwerk- oder Softwareebene verlagern. Daher muss der Wert von Helion an der Leistung, der Energieeffizienz und den Gesamtbetriebskosten in realen Anwendungen gemessen werden.
Insgesamt stellt AMD Helion eine Erweiterung der Designideen für KI-Infrastrukturen dar. AMD betont nicht mehr nur die Rolle von GPU-Beschleunigern in der künstlichen Intelligenz, sondern versucht stattdessen, integrierte Computerlösungen für Agenten bereitzustellen, von der Aufgabenausführung über die Modellbegründung bis hin zur Datenverarbeitung.
Da KI-Agenten nach und nach Aufgaben wie Softwareentwicklung, Unternehmensautomatisierung und komplexe Arbeitsabläufe übernehmen, könnte die Aufteilung der Ressourcen zwischen CPU und GPU wichtiger werden. Wenn Unternehmen in Zukunft wirklich eine unabhängige Ausführungsumgebung für eine große Anzahl von Agenten bereitstellen müssen, haben CPU-Server mit hoher Kerndichte die Möglichkeit, ein wichtiger Teil des KI-Rechenzentrums zu werden.
Helion ist jedoch immer noch ein offenes Referenzdesign und kein ausgereiftes Produkt, das vollständig bereitgestellt wurde. Ob in tatsächlichen Anwendungen Leistungs- und Kostenvorteile erzielt werden können, hängt letztendlich von der Systemimplementierung der Partner, der Reife des Software-Ökosystems und den tatsächlichen Anforderungen der Unternehmenskunden an die Agent-Computing-Infrastruktur ab.
Kommentare