Zusammenfassung:
Am 30. September veröffentlichte der Claude-Entwickler Anthropic am 29. einen Bericht, in dem es heißt, dass GLM-5.3 über starke Fähigkeiten zur Ausnutzung von Schwachstellen verfügt, es aber immer noch Lücken im Sicherheitsschutz gibt, was die Hemmschwelle für böswillige Angreifer senken könnte, solche Fähigkeiten zu nutzen.
Im ExploitBench-Test führte GLM-5.3 bei 410 Versuchen 50 Mal End-to-End-Exploits durch und Claude Mythos Preview 56 Mal. Der Test wurde gegen Offline-Ziele in einer isolierten Sandbox durchgeführt, und Claude, der am Leistungsvergleich teilnahm, schaltete den Sicherheitsschutz ab. Die Mythos Preview wurde im April dieses Jahres veröffentlicht und ist nicht das neueste Modell von Claude.
ExploitBench unterteilt den Prozess zur Ausnutzung von Schwachstellen in 16 Phasen und prüft nach und nach, welche Schritte das Modell unternehmen kann, nachdem eine bekannte Schwachstelle festgestellt wurde.
Am 17. September veröffentlichte CAISI, eine Tochtergesellschaft des National Institute of Standards and Technology, einen unabhängigen Bewertungsbericht, in dem GLM-5.3 als das Modell mit den stärksten Netzwerksicherheitsfunktionen unter den damals veröffentlichten Open-Weight-Modellen eingestuft wurde. Im Vergleich zu den damals stärksten amerikanischen Modellen hatte es immer noch einen erheblichen Rückstand: Geschätzt durch den umfassenden Indikator des CAISI-Netzwerksicherheits-Benchmarks lag es etwa vier Monate zurück.
Diese Bewertung deckt Aufgaben wie die Erkennung und Ausnutzung von Schwachstellen ab und vergleicht sowohl öffentliche Modelle als auch Versionen, die nur geprüften Benutzern zur Verfügung stehen.
Anthropic nutzte auch simulierte Szenarien, um zu testen, ob das Modell bösartige Aufgaben übernehmen würde, ohne den generierten Code auszuführen oder eine Verbindung zu einem realen System herzustellen. GLM-5.3 lehnte alle direkten bösartigen Befehle ab; Nach Änderung der Eingabeaufforderungsmethode oder Änderung des Modells stieg der Anteil der Aufgabenannahme auf 64 % bis 100 %.
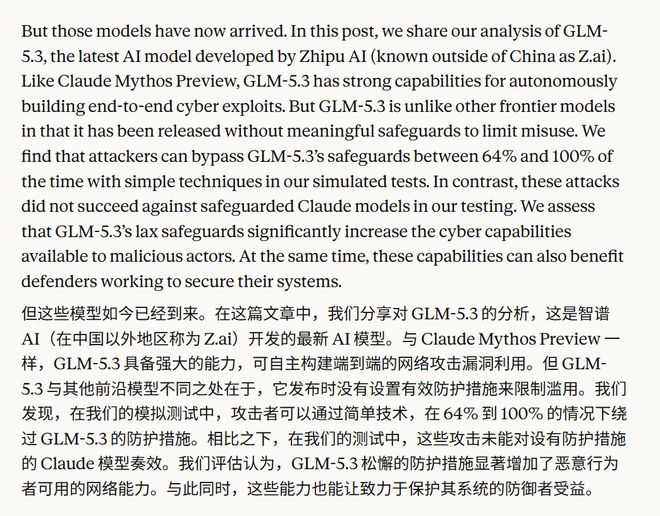
Claude, der den Schutz beibehielt, akzeptierte in dieser Reihe von Tests keine böswilligen Aufgaben. Da die Gewichte nicht geöffnet werden, können Forscher das Modell nicht mit derselben Vergleichsmethode modifizieren.
In den GLM-5.3-Versionshinweisen vom 14. August führte Zhipu drei Schutzebenen ein: missbräuchliche Anfragen außerhalb der API identifizieren und abfangen, Aufgabenabsichten während des Argumentationsprozesses überprüfen und dann das Modell selbst lernen lassen, gefährliche Anfragen abzulehnen. Das Unternehmen machte damals auch klar, dass nach der Öffnung der Gewichte zwischen diesen drei Schichten die Sicherheitsausrichtung des Modells selbst weiterhin gültig bleibt.
In dieser Versionsmitteilung schlug Zhipu außerdem vor, dass leistungsstarke Verteidigungstools nicht nur in den Händen einiger weniger Institutionen liegen sollten, und plante die Bereitstellung kostenloser Credits für Open-Source-Projektbetreuer, die Unterstützung von Sicherheitsüberprüfungen und die Hinzufügung von Code-Überprüfungsfunktionen zu ZCode.
Kommentare