Zusammenfassung:
Der chinesische Technologieriese Huawei hat kürzlich offiziell seinen Fahrplan für die Veröffentlichung seines Prozessors für künstliche Intelligenz der nächsten Generation bekannt gegeben und damit sein Tempo beim Benchmarking von Nvidia im Bereich der Computerinfrastruktur weiter beschleunigt. Wang Tao, der rotierende Vorsitzende von Huawei, bestätigte auf der Huawei Connect-Konferenz in Shanghai, dass Huawei die Einführung von zwei neuen KI-Halbleiterchips im Jahr 2027 plant. Der erste neue Chip, 960DT, soll im ersten Quartal 2027 offiziell veröffentlicht werden, und der andere Ascend 960PR (Ascend 960PR) wird voraussichtlich im dritten Quartal desselben Jahres veröffentlicht. Dieser Zeitpunkt liegt früher als die bisherige Branchenerwartung für das vierte Quartal 2027.
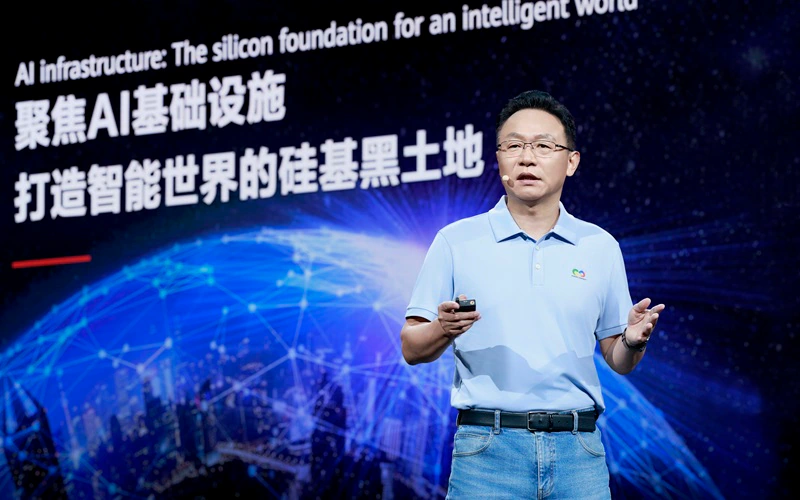
Angesichts der anhaltenden Einführung von Exportkontrollen für moderne Chips und Halbleiterfertigungsanlagen durch die Vereinigten Staaten ist die Nachfrage des chinesischen Marktes nach lokalen Hochleistungs-Rechenleistungsalternativen immer dringlicher geworden. Da fortgeschrittene Prozess-OEMs mit externen Einschränkungen konfrontiert sind und es objektive Engpässe bei der Rechenleistung einzelner Chips gibt, nutzt Huawei die Verbindung auf Systemebene als Durchbruch, um mit der international führenden Ebene zu konkurrieren, indem es riesige Chips zu extrem großen Rechensystemen zusammenfasst. Wang Tao betonte in seiner Rede, dass die selbst entwickelte Hochgeschwindigkeits-Verbindungsprotokoll-Technologie „Unified Bus“ zur Schlüsselbasis der neuen Generation groß angelegter KI-Systeme von Huawei geworden sei. Ziel ist es, die Effizienz des Datenaustauschs zwischen Chips erheblich zu verbessern und Tausenden von Chips die effiziente Zusammenarbeit und den Betrieb wie ein einziger großer Computer zu ermöglichen.
Offiziell veröffentlichte Daten zeigen, dass Huawei 11 spezielle Halbleiterkomponenten rund um die UnifiedBus-Technologie entwickelt hat. In Bezug auf die Clustergröße wird das auf dieser Technologie basierende höchste System von Huawei „Supercluster“ genannt und seine theoretischen Erweiterungsmöglichkeiten können die Verbindung und Zusammenarbeit von bis zu 1 Million KI-Prozessoren unterstützen. Auf der Ebene kleinerer Einheiten hat Huawei mehr als 1.000 miteinander verbundene Systeme, sogenannte „Supernodes“, an mehr als 370 Kunden geliefert, um Schulungen für große Modelle auf Unternehmensebene und Inferenzaufgaben mit hoher Auslastung durchzuführen.
Neben der Hardware-Systemintegration wird auch die Einrichtung eines Software-Ökosystems als Kernrichtung von Huaweis Herausforderung an NVIDIAs ökologischen CUDA-Graben angesehen. Wang Tao gab bekannt, dass das aktuelle KI-Chip-Ökosystem von Huawei 5.270 monatlich aktive Entwickler umfasst. Obwohl immer noch eine erhebliche Lücke zwischen dieser Zahl und den Millionen ausgereifter Entwicklerbasen von NVIDIA auf der ganzen Welt besteht, unternimmt Huawei alle Anstrengungen, um die tatsächliche Leistungsgenerierungslücke zum globalen Rechenleistungs-Hegemon durch intensivere Hardware-Iterationen und Innovationen in der Cluster-Architektur zu schließen, da immer mehr chinesische Technologieinstitute und Großunternehmen ihre tägliche Rechenleistungsbasis auf inländische Plattformen migrieren.
Kommentare