
Zusammenfassung:
Der Gründer des Linux-Kernels, Linus Torvalds, entwickelt mithilfe des Programmiertools für künstliche Intelligenz, Claude Code, eine Lösung zur Leistungsoptimierung des Linux-Kernels.
Diese Arbeit zielt auf einen Leistungsengpass im Speicherverwaltungsmechanismus des Linux-Kernels ab. Ziel ist es, den durch die Referenzzählung der Speicherseiten verursachten Wettbewerb zu verringern, wenn mehrere Threads gleichzeitig dieselbe Datei lesen, und so die Effizienz beim Lesen von Dateien zu verbessern.
Torvalds nutzte KI nicht nur zur Unterstützung beim Schreiben von Code, sondern nutzte dieses Tool auch, um Testprogramme zu schreiben, Codeüberprüfungen durchzuführen und relevante Patchnotizen zu entwerfen.
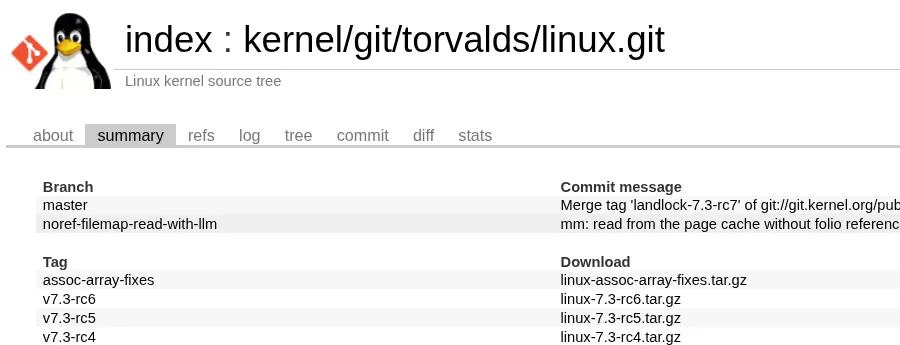
Während er auf die Veröffentlichung von Linux 7.3-rc7 wartete, aktualisierte Torvalds kürzlich sein Git-Code-Repository für den Linux-Kernel und stellte fest, dass ein ungewöhnlicher neuer Zweig im Repository aufgetaucht war. Im Gegensatz zu seiner üblichen Praxis, den Hauptzweig zu pflegen, ist dieser Zweig mit dem Namen „noref-filemap-read-with-llm“ der Entwicklung einer Reihe von Kernel-Verbesserungspatches gewidmet. Wie aus dem LLM im Zweignamen hervorgeht, bezieht sich diese Arbeit auf die modellgestützte Programmierung großer Sprachen.
Torvalds stellte später in den entsprechenden Patchnotizen klar, dass diese Arbeit unter seiner Anleitung und mit Hilfe von Claude Code abgeschlossen wurde. AI beteiligte sich nicht nur an der Code-Implementierung, sondern unterstützte auch beim Schreiben von Testprogrammen, der Durchführung von Code-Reviews und dem Entwurf der ersten Version der Dokumentation der Patch-Serie. Die entsprechenden Leistungsmessungen wurden auf Torvalds‘ eigenem Computer durchgeführt.
Diese Optimierung zielt hauptsächlich auf ein bestimmtes Problem im Dateilesepfad des Linux-Kernels ab. Wenn mehrere Threads gleichzeitig kleine Datenblöcke aus derselben Datei lesen, konkurrieren sie möglicherweise um die Referenzanzahl der Speicherseiten im Dateiseiten-Cache, was dazu führt, dass Threads miteinander um verwandte Datenstrukturen konkurrieren, wodurch die Leseleistung eingeschränkt wird.
Um dieses Problem zu verstehen, müssen Sie zunächst verstehen, wie der Linux-Kernel das Lesen von Dateien handhabt.
Linux verwendet den Seitencache (Page Cache), um vom Speichergerät gelesene Dateidaten zu speichern. Wenn ein Programm erneut auf den Inhalt einer im Speicher zwischengespeicherten Datei zugreift, kann der Kernel die Daten häufig direkt aus dem Speicher bereitstellen, ohne jedes Mal erneut auf die Festplatte oder ein anderes Speichergerät zugreifen zu müssen. Das Seiten-Caching ist daher ein wichtiger Mechanismus für Linux, um die Effizienz des Dateizugriffs zu verbessern.
Um diese zwischengespeicherten Daten zu verwalten, muss der Kernel den Lebenszyklus der zugehörigen Speicherobjekte verfolgen. Der Referenzzählmechanismus in herkömmlichen Implementierungen kann dem Kernel dabei helfen, festzustellen, ob ein Speicherobjekt noch verwendet wird und wann er zugehörige Ressourcen sicher freigeben kann.
Wenn jedoch eine große Anzahl von Threads häufig auf dieselbe Datei zugreift, können die zugehörigen Referenzzählvorgänge, selbst wenn sich die von ihnen gelesenen Daten bereits im Speicher befinden, immer noch zusätzlichen Synchronisierungsaufwand verursachen. Wenn in einem Mehrkernprozessorsystem mehrere Threads kontinuierlich denselben gemeinsamen Zählwert aktualisieren, können Probleme wie erhöhter Cache-Kohärenzverkehr und aufeinander wartende Prozessorkerne auftreten.
Bei Single-Thread-Szenarien oder Szenarien mit geringer Parallelität ist dieser Mehraufwand möglicherweise nicht spürbar. Aber bei Servern, Datenbanken, Build-Systemen und anderen Arbeitslasten, die eine große Anzahl von Dateileseanforderungen gleichzeitig verarbeiten müssen, können wiederkehrende Synchronisierungsvorgänge allmählich zu einem Leistungsengpass werden.
Die Reihe von Patches, die Torvalds entwickelt, soll unnötige Referenzzählvorgänge reduzieren. Die Kernidee besteht darin, den Dateilesepfad so anzupassen, dass der Kernel unter bestimmten Bedingungen Daten direkt aus dem Seitencache lesen kann, ohne für jeden relevanten Zugriff herkömmliche Folio-Referenzverwaltungsvorgänge durchführen zu müssen.
folio ist hier eine der grundlegenden Abstraktionen, die vom Linux-Kernel verwendet werden, um eine Reihe zusammenhängender oder verknüpfter Speicherseiten zu verwalten. In den letzten Jahren hat der Linux-Kernel nach und nach den Folio-Mechanismus verwendet, um einige der alten Single-Page-Management-Methoden zu ersetzen und so Speicherverwaltungsaufgaben effizienter zu bewältigen. Die Reduzierung des durch die Folio-Referenzzählung verursachten Overheads ist daher zu einer wichtigen Aufgabe bei der Optimierung der Kernel-Leistung geworden.
Aus technischer Sicht entfällt bei dieser Art der Optimierung nicht einfach die Referenzzählung. Der Kernel muss dennoch sicherstellen, dass Speicherobjekte nicht vorzeitig freigegeben werden, während auf sie zugegriffen wird, und darf durch die Reduzierung von Synchronisierungsvorgängen keine Datenbeschädigung oder Speichersicherheitsprobleme verursachen. Daher müssen Patches ein Gleichgewicht zwischen Korrektheit, gleichzeitiger Zugriffssicherheit und Leistung herstellen.
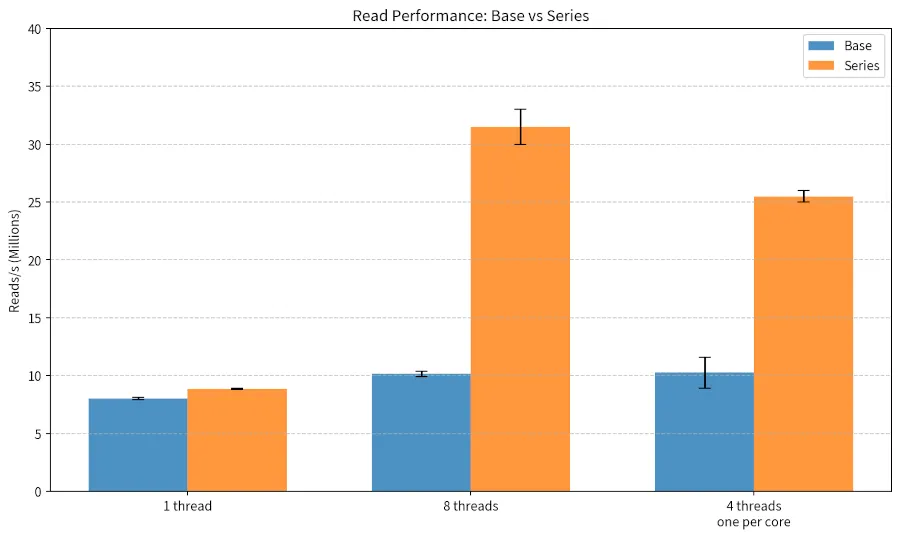
Diese Optimierung führte zu erheblichen Leistungsänderungen unter der Ziel-Workload. Der Test zielt hauptsächlich auf das Szenario ab, in dem mehrere Threads gleichzeitig kleine Datenmengen aus derselben Datei lesen, was dem Wettbewerbsproblem entspricht, das der Patch zu lösen versucht.
Diese Ergebnisse sind jedoch als Leistung unter bestimmten Testbedingungen zu verstehen und nicht als die Tatsache, dass alle Dateivorgänge unter Linux die gleiche Verbesserung erfahren. Die tatsächlichen Vorteile hängen von den Zugriffsmustern Ihrer Anwendung, der Anzahl der Threads, der Dateigröße, dem Speichergerät, der Speicherkonfiguration und anderen Systemfaktoren ab. Bei Workloads, bei denen nicht dieselben Konfliktprobleme auftreten, sind die Optimierungseffekte möglicherweise begrenzt.
Derzeit sind diese Patches noch im persönlichen Git-Zweig von Torvalds gespeichert und es kann nicht geschlossen werden, dass sie offiziell in den Linux-Hauptkernel aufgenommen wurden. Ob es in Zukunft zu einer Zusammenführung kommt und welche Umsetzungsmethode am Ende gewählt wird, bedarf weiterer Beobachtung.
Je nach aktuellem Entwicklungstempo wird diese Patch-Serie möglicherweise während des nächsten Zusammenführungsfensters von Linux 7.4 in die weitere Diskussions- oder Überprüfungsphase eintreten, aber ob sie letztendlich zusammengeführt werden kann, hängt immer noch von der Codeüberprüfung, den Testergebnissen und dem Urteil des Betreuers ab.
Es ist erwähnenswert, dass Torvalds‘ Einsatz von Claude Code nicht sein erster Versuch ist, künstliche Intelligenz zur Bewältigung von Linux-bezogenen Entwicklungsarbeiten einzusetzen.
Zuvor hat er über den Einsatz von KI-gestütztem Kernel-Debugging gesprochen und KI-Programmiertools wie Google Antigravity außerhalb des Linux-Kernels ausprobiert. Für Torvalds geht es bei KI nicht darum, Entwickler als unabhängige Entscheidungsträger zu ersetzen, sondern vielmehr um ein Entwicklungstool, das mit klaren Zielen und menschlicher Aufsicht eingesetzt werden kann.
Seit diesem Jahr werden Programmiertools für künstliche Intelligenz schrittweise in den Open-Source-Softwareentwicklungsprozess einbezogen. Immer mehr Entwickler nutzen große Sprachmodelle, um Code zu analysieren, Fehler zu finden, Tests zu schreiben und erste Patches zu generieren. Auch die Linux-Kernel-Community sieht eine zunehmende Zahl von KI-gestützten Code- und Fehlerberichten.
Dieser Trend bringt sowohl Chancen als auch Herausforderungen mit sich. Einerseits kann KI erfahrenen Entwicklern dabei helfen, komplexe Codepfade schneller zu erkunden, Optimierungsideen zu entwickeln und den Zeitaufwand für das Schreiben sich wiederholender Codes zu reduzieren. Andererseits erhöht eine große Anzahl automatisch generierter Patches und Fehlerberichte auch den Überprüfungsaufwand für die Betreuer, und einige der Einsendungen können Probleme mit geringer Qualität, doppelten Einsendungen oder mangelndem tatsächlichen Wert aufweisen.
Torvalds hat bereits zuvor öffentlich erklärt, dass er KI für ein nützliches Werkzeug hält, die Kernel-Community muss sich jedoch mit dem Arbeitsdruck auseinandersetzen, der durch die schnelle Zunahme von KI-generierten Inhalten entsteht. Er plädiert nicht dafür, Code nur deshalb abzulehnen, weil er KI nutzt, sondern legt mehr Wert auf die Qualität, Korrektheit und tatsächliche Wirkung des finalen Codes.
Das Kernel-Optimierungsprojekt, an dem Claude Code dieses Mal teilnahm, spiegelt eine spezifischere Anwendungsmethode der KI-gestützten Entwicklung wider: Entwickler, die mit den internen Mechanismen des Kernels vertraut sind, identifizieren Probleme, schlagen Optimierungsrichtungen vor und überwachen die Implementierung und überprüfen dann die Ergebnisse durch Tests und Codeüberprüfung.
Anders als sich ausschließlich auf KI zu verlassen, um das gesamte Softwareprojekt automatisch zu generieren, umfasst die Entwicklung des Linux-Kernels komplexe Parallelitätsmechanismen, Speichersicherheitsanforderungen und Hardwareverhalten. Jede scheinbar einfache Änderung kann Auswirkungen auf eine Vielzahl von Anwendungen und verschiedene Hardwareplattformen haben. Auch wenn KI dabei helfen kann, Code zu generieren, müssen Entwickler dennoch verstehen, wie er funktioniert, und die Verantwortung für die endgültige Implementierung übernehmen.
Wenn dieser Patch-Satz endlich die Prüfung besteht und in die Linux-Hauptlinie gelangt, wird es ein weiterer Fall von KI-gestützter Entwicklung sein, die an der Optimierung der zugrunde liegenden Systemsoftware beteiligt ist. Sein Wert liegt nicht nur in den Leistungsverbesserungen, die in bestimmten Szenarien erzielt werden können, sondern auch darin, zu demonstrieren, wie große Sprachmodelle erfahrene Ingenieure bei der Analyse und Verbesserung komplexer Systeme unterstützen können.
Da sich KI-Programmiertools weiterentwickeln, könnten in Zukunft weitere ähnliche Arbeiten im Linux-Kernel und anderen großen Open-Source-Projekten auftauchen. Ob diese Errungenschaften tatsächlich umgesetzt werden können, hängt jedoch weiterhin von einer strengen technischen Überprüfung, einer Überprüfung durch die Community und langfristigen Anforderungen an die Systemstabilität ab.
Kommentare