
Zusammenfassung:
Linux-Gründer Linus Torvalds erforscht weiterhin die Anwendung von Programmiertools für künstliche Intelligenz in der Kernel-Entwicklung. Nachdem Torvalds kürzlich mithilfe von Claude Code von Anthropic einen Patch zur Leistungsoptimierung des Linux-Kernels entwickelt hatte, nutzte er ein großes Sprachmodell (LLM), um einen Teil des Kernel-Codes zu analysieren, der lange Zeit schwer zu verstehen war. Er bestätigte nicht nur eine zuvor vom Entwickler gemeldete Schwachstelle, sondern entdeckte auch drei weitere Schwachstellen, die seit mehr als zehn Jahren schlummerten. Diese Probleme hängen alle mit der Implementierung von Associative Array im Linux-Kernel zusammen.
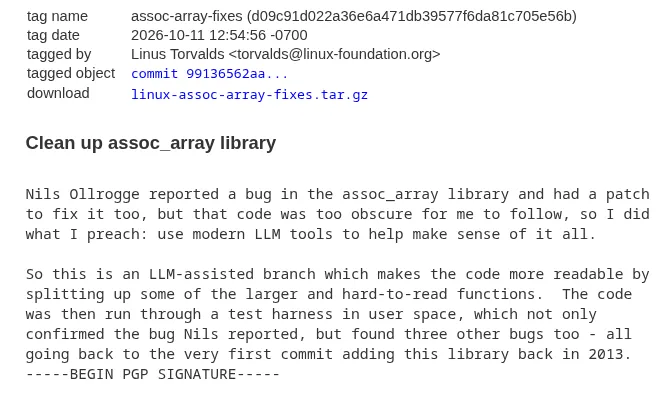
Laut einem am 12. Oktober von Phoronix veröffentlichten Bericht hat Torvalds kürzlich einen Git-Tag namens „assoc-array-fixes“ zu seinem Linux-Kernel-Code-Repository hinzugefügt, um eine Reihe von Reparaturen am assoziativen Array-Code zu organisieren und zu markieren. Diese Arbeit ist unabhängig von seinem früheren Projekt, Claude Code zur Optimierung der Dateileseleistung zu verwenden, aber beide spiegeln seine Versuche wider, KI-Tools in den komplexen Kernel-Entwicklungsprozess einzuführen.
Der Grund für diese Arbeit war, dass Entwickler Nils Ollrogge einen Fehler in der assoziativen Array-Bibliothek gemeldet und einen entsprechenden Fix-Patch eingereicht hat. Als Torvalds den Patch jedoch überprüfte, stellte er fest, dass die Implementierung des relevanten Codes zu unklar war, um seine spezifische Logik direkt zu verstehen, sodass es unmöglich war, einfach zu beurteilen, ob der Patch das Problem richtig löste.
Angesichts dieser Situation entschied sich Torvalds für die Verwendung moderner, groß angelegter Sprachmodelle zur Unterstützung der Analyse. In der Git-Tag-Beschreibung schrieb er, dass er dieses Mal den Ansatz verfolgte, den er zuvor befürwortet hatte, nämlich die Verwendung moderner LLM-Tools, um das Verständnis von komplexem Code zu erleichtern.
Torvalds organisierte dann eine Reihe von Patches mit KI-gestützten Modifikationen, um einige große und schwer lesbare Funktionen in eine klarere Struktur aufzuteilen und die Codelogik einfacher zu verstehen und zu überprüfen. Es ist erwähnenswert, dass das Ziel dieser Arbeit nicht darin besteht, die KI einfach die gesamte assoziative Array-Implementierung neu schreiben zu lassen, sondern zunächst die Lesbarkeit des vorhandenen Codes zu verbessern und dann durch Tests zu überprüfen, ob sein Verhalten den Erwartungen entspricht.
Nach Abschluss der Änderung wurde der relevante Code auch zur Ausführung in das User Space Test Framework gestellt. Tests bestätigten nicht nur, dass der ursprünglich von Olrog gemeldete Fehler tatsächlich vorhanden war, sondern entdeckten auch drei weitere Probleme.
Noch besorgniserregender ist, dass es sich bei diesen Mängeln nicht um neue Probleme handelt, die kürzlich aufgetreten sind. Laut Torvalds stammen die drei zusätzlich entdeckten Schwachstellen aus dem Jahr 2013, als die assoziative Array-Bibliothek erstmals in den Linux-Kernel eingeführt wurde. Mit anderen Worten: Sie lauern seit mehr als einem Jahrzehnt im Code, ohne dass sie durch entsprechende Tests vollständig erkannt wurden.
Das assoziative Array im Linux-Kernel ist eine Datenstruktur, die zum Organisieren und Abrufen von Daten nach Schlüsselwerten verwendet wird. Im Gegensatz zu gewöhnlichen Arrays, die über ganzzahlige Indizes auf Elemente zugreifen, können assoziative Arrays entsprechende Daten basierend auf bestimmten Schlüsseln finden und eignen sich daher für Szenarien, die eine flexible Indizierung und Verwaltung von Objekten erfordern.
Die assoziative Array-Implementierung im Linux-Kernel erfüllt die Datenverwaltungsanforderungen innerhalb des Kernels. Da Kernel-Code unter strengen Anforderungen an Leistung, Speichersicherheit und gleichzeitigen Zugriff ausgeführt werden muss, ist die Implementierung solcher Basiskomponenten oft komplexer als ähnlicher Code in gewöhnlichen Anwendungen. Auch wenn eine Funktion angeblich nur das Einfügen, Löschen oder Suchen von Daten durchführt, kann sie eine Anpassung der Baumstruktur, Knotenlebenszyklusverwaltung und verschiedene Randbedingungen umfassen.
Das Fehlen einer klaren Struktur bei dieser Art von Code macht es für Betreuer schwieriger, sein Verhalten zu verstehen. Entwickler müssen nicht nur die Betriebslogik unter normalen Umständen bestätigen, sondern auch abnormale Eingaben, spezielle Datenstrukturzustände und Probleme analysieren, die auftreten können, wenn mehrere Vorgänge kontinuierlich ausgeführt werden.
Da sich der Code weiterentwickelt, können Fehler, die in frühen Implementierungen nicht leicht ausgelöst werden können, noch lange bestehen bleiben. Insbesondere in komplexen Datenstrukturen werden einige Fehler nur in bestimmten Operationssequenzen oder speziellen Strukturzuständen aufgedeckt, und normale Tests decken möglicherweise nicht unbedingt alle Situationen ab.
Die in dieser KI-gestützten Arbeit verfolgte Idee besteht darin, zunächst große Funktionen, die schwer zu verstehen sind, in Teile aufzuteilen, die leichter zu analysieren sind, und dann die relevante Logik durch ein unabhängiges Testprogramm zu überprüfen. Eine klarere Codestruktur hilft Entwicklern, die Beziehung zwischen verschiedenen Vorgängen zu erkennen, und erleichtert Testtools außerdem die Erstellung von Überprüfungsbedingungen für bestimmte Verhaltensweisen.
Die drei dieses Mal entdeckten Schwachstellen können jedoch nicht einfach auf die Fähigkeit der KI zurückgeführt werden, Programme zu verstehen, die über den Menschen hinausgehen. Genauer gesagt arbeiten KI-gestütztes Code-Refactoring, Entwicklerüberprüfungen und Test-Frameworks zusammen. Große Sprachmodelle können dabei helfen, die Codelogik zu organisieren und potenzielle Probleme zu identifizieren. Letztendlich muss jedoch durch tatsächliche Ausführung und wiederholbare Tests bestätigt werden, ob die Fehler real sind.
Das Besondere an diesem Fall ist, dass KI nicht nur an der Code-Analyse beteiligt war, sondern Torvalds auch dabei half, Verständnisbarrieren während des Patch-Review-Prozesses zu beseitigen. Für Entwickler, die große Open-Source-Projekte betreuen, kann dies eine Arbeitsmethode von praktischem Wert sein: Wenn der Code zu komplex ist und es für Betreuer schwierig ist, schnell zu beurteilen, ob der Reparaturplan korrekt ist, kann KI zur Unterstützung bei der Sortierung der Codestruktur eingesetzt werden, und dann können die Schlussfolgerungen durch Tests und manuelle Überprüfung überprüft werden.
Derzeit ist dieser Satz von Korrekturen für assoziative Arrays noch nicht in die Hauptlinie des Linux-Kernels integriert. Berichten von Phoronix zufolge wird damit gerechnet, dass die damit verbundenen Arbeiten während des bevorstehenden Zusammenführungsfensters von Linux 7.4 weiter vorangetrieben werden. Ob die endgültige Zusammenführung jedoch noch erfolgen wird, hängt von den Ergebnissen nachfolgender Codeüberprüfungen und Tests ab.
Es ist erwähnenswert, dass dies nicht das erste Mal ist, dass Torvalds kürzlich öffentlich den Einsatz von KI in der Linux-Kernel-Entwicklung demonstriert.
Zuvor nutzte er Claude Code, um eine weitere Kernel-Optimierungsarbeit durchzuführen. Ziel war es, das Wettbewerbsproblem zu lösen, das durch den Speicherseitenreferenzzählvorgang verursacht wird, wenn mehrere Threads gleichzeitig dieselbe Datei lesen. Der entsprechende Patch versucht, unnötige Referenzzählvorgänge zu reduzieren, indem er den Dateilesepfad anpasst und so die Leseleistung unter bestimmten Arbeitslasten verbessert.
Bei dieser Arbeit beteiligte sich AI am ersten Code-Schreiben, an der Entwicklung von Testprogrammen, an der Codeüberprüfung und am Entwurf von Patchnotes-Dokumenten. Torvalds ist für die Festlegung von Optimierungsrichtungen, die Überwachung des Entwicklungsprozesses und die Durchführung von Leistungsmessungen auf seinem eigenen Computer verantwortlich.
Die technischen Ziele der beiden Aufgaben sind unterschiedlich, sie verkörpern jedoch ein ähnliches Entwicklungsmodell: Ingenieure, die mit dem Kernel vertraut sind, ermitteln das Problem, nutzen dann KI, um komplexe Implementierungen zu verstehen, schreiben oder passen Code an und überprüfen schließlich die Ergebnisse durch Tests.
Dieses Modell kann besonders wertvoll für Open-Source-Projekte mit großem Umfang und langen Wartungszyklen wie Linux sein. Der Kernel-Code hat sich über Jahrzehnte weiterentwickelt und enthält eine umfangreiche Implementierungshistorie und komplexe Kompatibilitätsanforderungen. Selbst erfahrene Betreuer sind nicht immer mit allen Details jedes Subsystems vertraut.
Traditionelle Codeüberprüfungen basieren hauptsächlich darauf, dass Entwickler Code lesen, Logik analysieren und Tests entwerfen. KI-Tools haben die Möglichkeit, Betreuern dabei zu helfen, unbekannten Code schneller zu sortieren, die Beziehung zwischen Funktionen zu erklären, mögliche Randbedingungen vorzuschlagen und bei der Generierung von Testfällen zu helfen. Sie ersetzen keine professionelle Überprüfung, sollen aber den Zeitaufwand für das Verständnis von komplexem Code verringern.
Gleichzeitig weist KI-generierter Code auch Einschränkungen auf. Große Sprachmodelle können komplexe Kontrollflüsse missverstehen, seltene Randbedingungen ignorieren oder Änderungen vorschlagen, die zwar sinnvoll erscheinen, aber nicht wirklich die Korrektheit garantieren. Für Betriebssystemkerne sind diese Probleme besonders wichtig, da Codefehler die Systemstabilität, die Speichersicherheit und sogar den zuverlässigen Betrieb des gesamten Systems beeinträchtigen können.
Daher bedeutet die Beteiligung von KI an der Kernel-Entwicklung nicht, dass die Überprüfungsanforderungen gelockert werden können. Stattdessen bleiben Code-Refactoring, automatisierte Tests, Patch-Review und tatsächliche Verifizierung der Schlüssel zur Sicherstellung der Qualität von Änderungen. Das assoziative Array-Projekt konnte seit langem bestehende Probleme aufdecken, was zeigt, dass KI-Tools mit strengen technischen Verifizierungsprozessen kombiniert werden müssen, um effektiv zu sein.
Torvalds hatte schon immer eine pragmatische Haltung gegenüber KI-Programmiertools. Er erkannte den Wert der KI für die Unterstützung des Entwicklungsprozesses, plädierte jedoch nicht dafür, dass Entwickler maschinengenerierten Code ohne Überprüfung akzeptieren sollten. Dieses Mal erklärte er öffentlich, dass er LLM zur Analyse des Codes verwende, was weiter zeigte, dass KI zu einer Hilfsoption in der Kernel-Entwicklungs-Toolbox wird.
Im weiteren Sinne wirft der Vorfall auch ein Licht auf ein seit langem bestehendes Problem bei der Wartung großer Softwareprojekte: Der Code muss nicht nur korrekt ausgeführt werden, sondern muss auch für zukünftige Entwickler verständlich sein. Bei Basissoftware, die länger als zehn Jahre oder sogar Jahrzehnte gewartet wird, ist die Lesbarkeit selbst ein wichtiger Faktor für die Zuverlässigkeit.
Diese Modifikation verbessert die Codestruktur durch die Aufteilung komplexer Funktionen und verwendet Tests, um zuvor übersehene Probleme zu entdecken, was den engen Zusammenhang zwischen Codelesbarkeit und Fehlerbehebung demonstriert. Wenn die Programmlogik klarer ist, ist es für Entwickler einfacher, potenzielle Fehlerpfade zu identifizieren und Tests zu erstellen, die relevante Verhaltensweisen abdecken.
Wenn diese Reihe von Patches schließlich in die Linux-Hauptlinie gelangt, wird ihre Bedeutung nicht nur die vier identifizierten Probleme beheben, sondern auch eine klarere Codebasis für die nachfolgende Wartung bieten.
Da sich KI-Programmiertools weiterentwickeln, könnte es in Zukunft in großen Open-Source-Projekten zu weiteren ähnlichen Fällen kommen. Was jedoch bei wichtiger Basissoftware wie dem Linux-Kernel wirklich darüber entscheidet, ob die KI-gestützte Entwicklung langfristig Anerkennung finden kann, ist, ob der Patch eine strenge Prüfung bestehen kann, ob der Test das Problem reproduzieren kann und ob der endgültige Code zuverlässig genug ist.
Diesmal ersetzte die KI nicht den Linux-Gründer bei der endgültigen Entscheidung, sondern half ihm, den Code zu verstehen, der ursprünglich schwer zu überprüfen war, und weitere Fehler aufzudecken, die viele Jahre lang verborgen gewesen waren. Für ausgereiftes Software-Engineering ist dies möglicherweise eine der praktischsten Anwendungsrichtungen künstlicher Intelligenz.
Kommentare