
Zusammenfassung:
DeepSeek veröffentlicht großes Modell V4.1 Flash-1017. Zu einer Zeit, in der sich der Markt im Allgemeinen auf die Aktualisierung großer inländischer KI-Modelle freut, ist DeepSeek der erste, der eine neue Version auf den Markt bringt. Dieses Upgrade bringt erhebliche Leistungsverbesserungen.
Über die spezifischen Leistungsniveaus und Änderungen wurde bereits berichtet. Sie sollten beachten, dass DeepSeek dieses Mal auch eine Pareto-Kurve veröffentlicht hat, die oft als KI-Killing-Linie bezeichnet wird. V4.1 Flash-1017 ist dieses Mal auf einem gottähnlichen Niveau. Die Kosten pro Aufgabe liegen bei großen Modellen wie Fable und Astra nur zwischen 1/50 und 1/100, und das Preis-/Leistungsverhältnis ist mindestens vierzig- bis fünfzigmal höher.
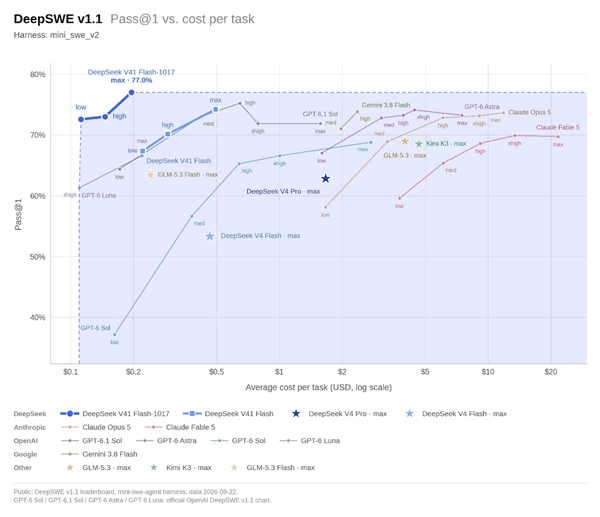
Wie hat DeepSeek eine solche Kill-Line erreicht? Jeder weiß, dass er über starke KI-Optimierungsfunktionen verfügt und sein Bestes tun kann, um die Kosten zu senken. Das folgende von vllm_project veröffentlichte Bild kann deutlich zeigen, wie stark DeepSeek bei der Optimierung von KI-Hardware ist.
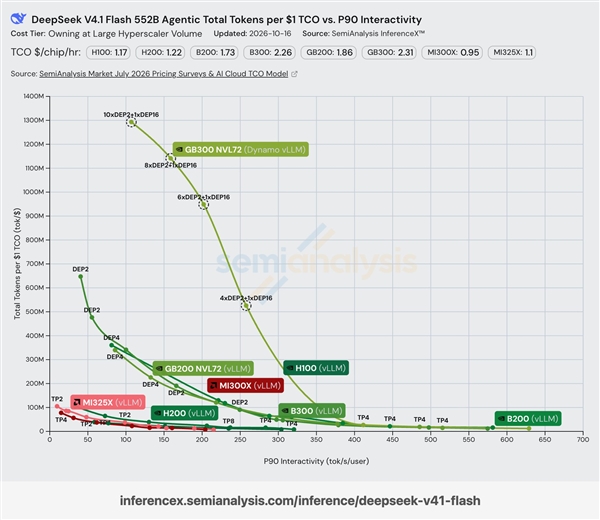
Dieses Bild vergleicht den SemiAnalysis AgentX-Benchmarktest. Auf den Plattformen GB300 NVL72 und Dynamo vLLM erzielte V4.1 Flash einen Wert von 1,3 Milliarden Token für 1 US-Dollar, und die P90-Interaktionsgeschwindigkeit überstieg 100 Token/s/Benutzer.
1 US-Dollar entspricht 1,3 Milliarden Token, daher kostet 1 Million Token nur 0,00077 US-Dollar, was viel günstiger ist als der Eingabepreis von V4.1 Flash von 0,15 US-Dollar.
Natürlich lassen sich diese beiden Preise eigentlich nicht so einfach umrechnen. Die TCO-Kosten von 1 USD und 1,3 Milliarden Token liegen auf der Seite der Rechenleistung, und die API-Preisgestaltung muss komplexere Situationen berücksichtigen. Die extrem niedrigen Kosten verschaffen DeepSeek jedoch in dieser Hinsicht einen unübertroffenen Vorteil.
Da DeepSeek V4.1 Flash einen unglaublichen Kostenvorteil bietet, wagen große Plattformen, extrem niedrige Gebühren anzubieten. Die Nutzung des 10-Dollar-Pakets von OpenCode und CommandCode hat kürzlich 80-120 USD erreicht. OpenCode war in den letzten zwei Tagen kostenlos und geöffnet. Jetzt liegt die Nutzung von V4.1 Flash auf der aggregierten Routing-Plattform bei 100 Milliarden Token, und ein Unternehmen kann die Nutzung von sechs oder sieben Freunden erreichen.
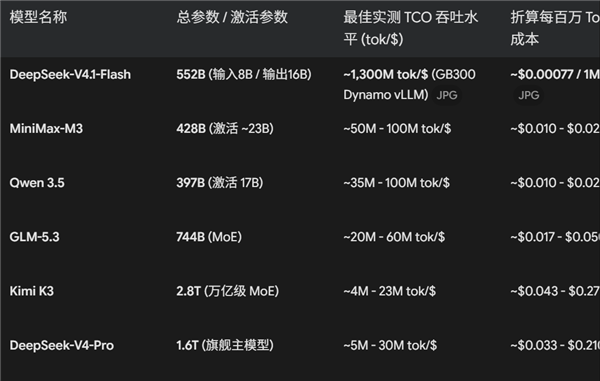
Lassen Sie AI die Gesamtbetriebskosten mehrerer großer Open-Source-Modelle vergleichen. Die Ausgabe anderer großer Modelle mit einer Billion Parameter beträgt höchstens 1/10 von V4.1 Flash. Wenn es sich um ein großes Modell mit 1,5 bis 3 Billionen Parametern handelt, kann der Kostenunterschied mehr als das 40- bis 50-fache betragen, was völlig unvergleichlich ist.
Es sollte auch beachtet werden, dass die Gesamtbetriebskosten immer noch denen von V4.1 Flash-0910 entsprechen und nicht denen der heute veröffentlichten Version 1017. Obwohl sich die API-Preise für Letzteres nicht geändert haben, wurde die Token-Effizienz erheblich optimiert und der Token-Verbrauch reduziert. Der Grad variiert je nach Aufgabenstellung. Somatosensorisch konnte der Verbrauch um mindestens die Hälfte reduziert werden, wodurch die TCO-Kosten nochmals deutlich gesenkt werden können.
Kommentare