Zusammenfassung:
Es ist verrückt. In nur zwei Tagen erschienen 4 neue Modelle! Im Vordergrund steht die xAI von Lao Ma, die gerade Grok 4,7 herausgegeben hat. Unmittelbar danach verzichtete OpenAI plötzlich auf GPT-6 Sol und Luna und der Preis wurde halbiert. Am selben Tag brachte Anthropic auch den Claude Opus 5.5 auf den Tisch, der 40 % günstiger ist als die Vorgängergeneration. Am 22. September ging ein animiertes Bild auf X viral und erreichte fast eine Million Aufrufe.
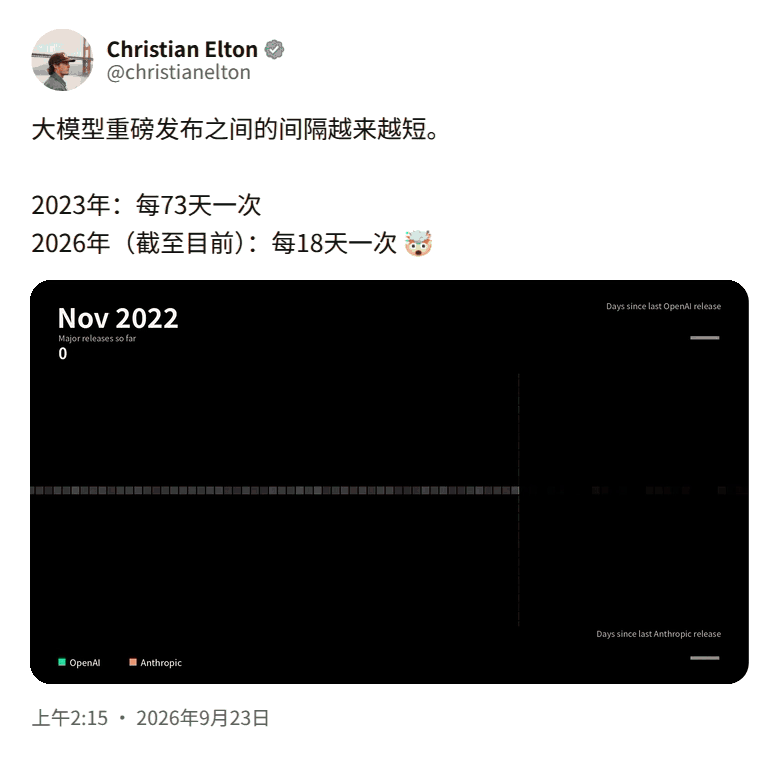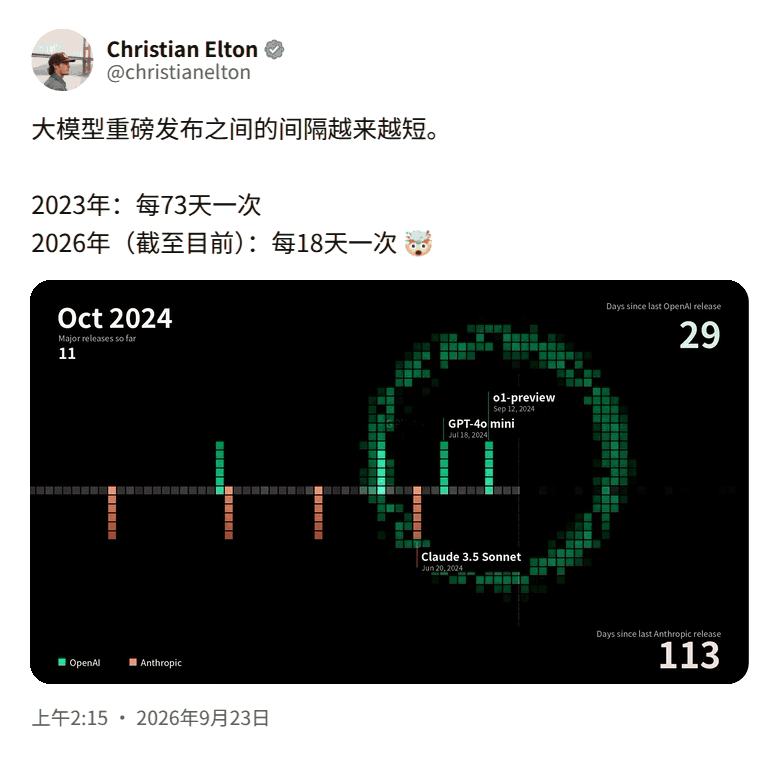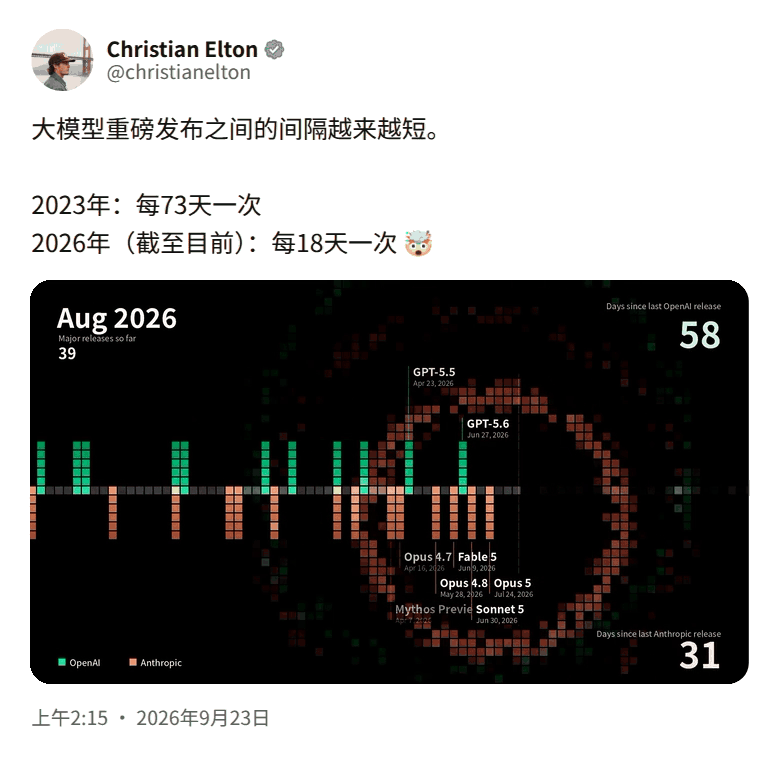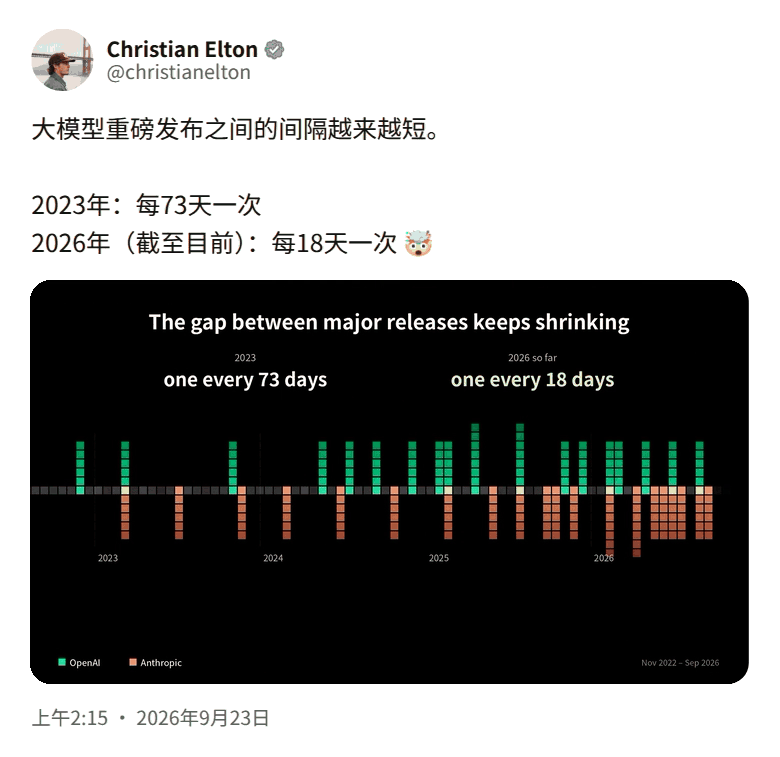
Im Jahr 2023 werden große Modelle alle 73 Tage und im Jahr 2026 alle 18 Tage aktualisiert.
Seit dem Start von ChatGPT haben OpenAI und Anthropic 42 Blockbuster-Modelle bombardiert (44, einschließlich GPT-6 Sol und Luna, die an diesem Tag veröffentlicht wurden).
Einige Stunden später twitterte der Gründer von Stability AI, Emad Mostaque, das Bild erneut und fügte eine Prophezeiung hinzu.
„Wie Alex sagte, wird es bei diesem Tempo Anfang nächsten Jahres eine pro Tag geben.“
Zwei Giganten führen ein „halbmonatliches Update“ ein
Tatsächlich ist die Zahl der „Updates alle 18 Tage“ recht konservativ, da nur OpenAI und Anthropic berücksichtigt werden.
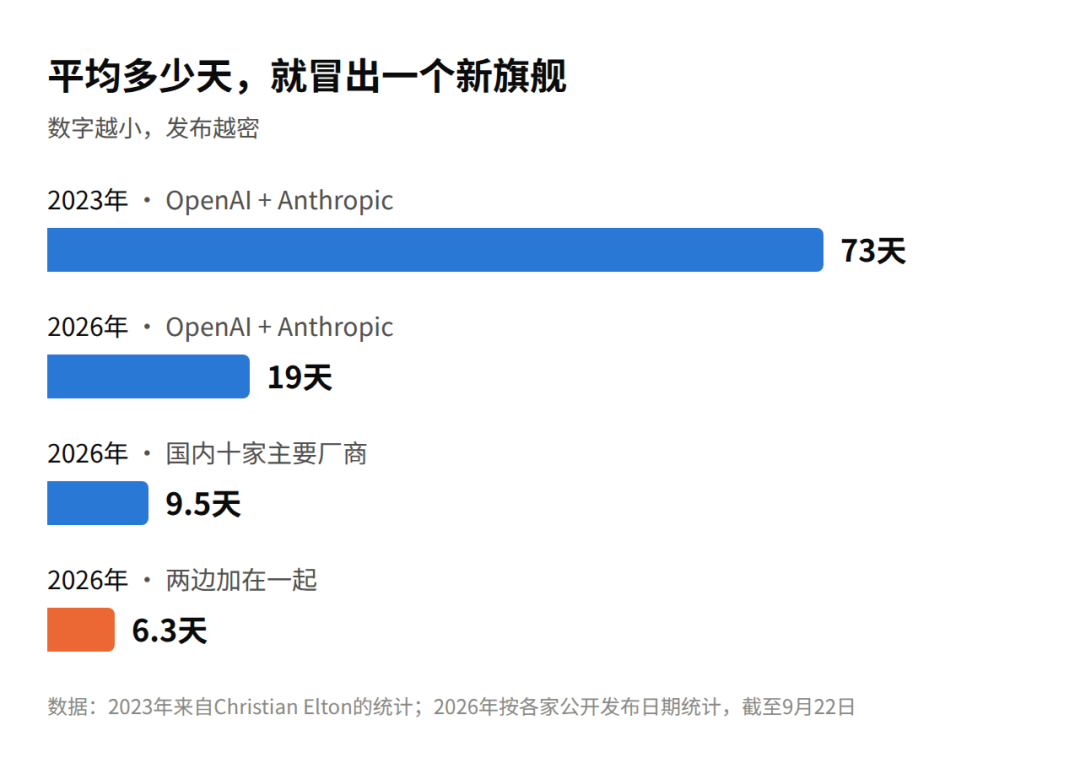
Von Anfang dieses Jahres bis zum 22. September veröffentlichte Anthropic acht Flaggschiffmodelle und OpenAI sechs. Die 14 Modelle waren über 265 Tage verteilt, mit einem Durchschnitt von 19 Tagen pro Modell.
Im gleichen Zeitraum brachten die zehn großen inländischen Großmodellhersteller mindestens 28 weitere Flaggschiffmodelle auf den Markt, durchschnittlich mehr als eines alle 9 Tage.
Es gab Zeiten, in denen sie gemeinsam starteten. In der Woche vor dem Frühlingsfest brachten vier Unternehmen nacheinander neue Flaggschiffe auf den Markt; Vom 20. bis 24. April wechselten sich in den fünf Tagen vier weitere Unternehmen ab.
Wenn man beide Seiten zusammennimmt, entsteht ein neues Flaggschiff in durchschnittlich mehr als 6 Tagen, was nicht weit von der von Emad genannten „eins pro Tag“ entfernt ist.
Die Geschwindigkeitssteigerung von Anthropic ist mit bloßem Auge sichtbar.
In der ersten Jahreshälfte dauerte die Veröffentlichung eines Modells durchschnittlich 46 Tage, in der zweiten Jahreshälfte waren es 26 Tage. Opus 4.8 erscheint am 28. Mai, Opus 5 am 24. Juli und Opus 5.5 am 22. September.
OpenAI geht den Weg, „den ultimativen Zug zurückzuhalten und ihn dann wegzunehmen“.
GPT-6 Astra hat am 3. September gerade das gesamte Netzwerk in die Luft gesprengt, und nur 19 Tage später folgten Sol und Luna diesem Beispiel.
Nächste Woche wird es eine DevDay-Konferenz geben. Altman beklagte, dass dies das erste Mal in seiner Erinnerung sei, dass OpenAI bei der Vorbereitung einer Pressekonferenz rief: „Es gibt zu viele Dinge, die veröffentlicht werden müssen“.
Warum wird das Verlagswesen immer dichter? Die Antwort gab Anthropic in einem Bericht. KI trägt bereits dazu bei, die nächste Generation von KI zu schaffen.
Im Februar dieses Jahres konnte Claude weniger als 1 % der KI-Forschungs- und Entwicklungsarbeit selbstständig leiten. Danach verbesserte er sich fast jeden Monat und erreichte im Mai 12 %, im Juli 22 % und im August 26 %.
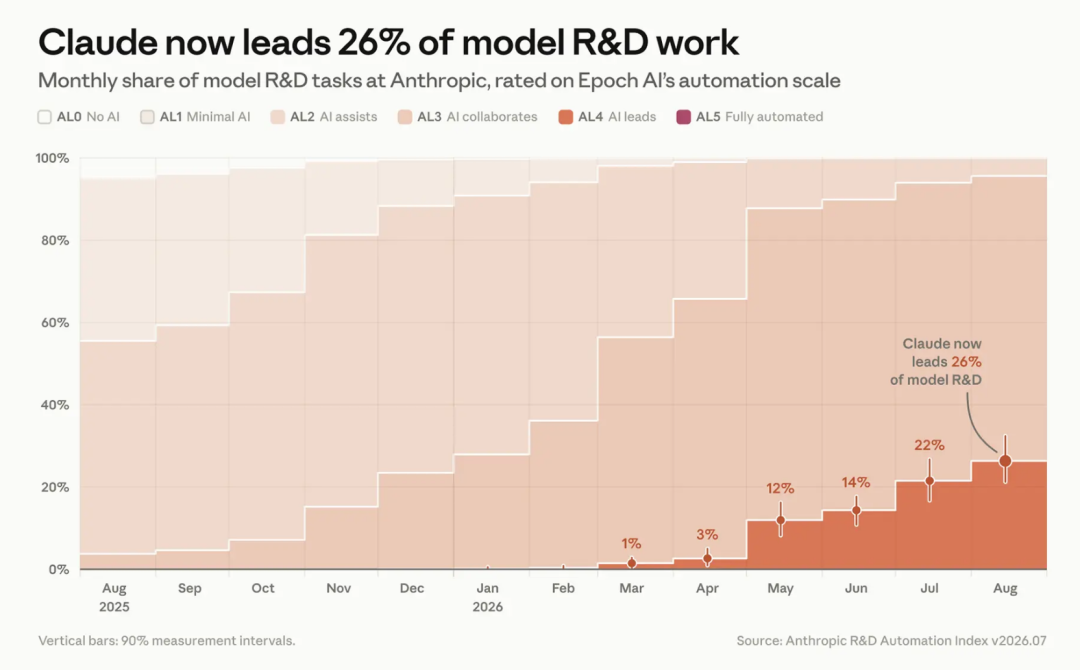
Bei OpenAI war die Anzahl der von KI-Agenten investierten Arbeitstage bis Mitte August 3,1-mal so hoch wie die von menschlichen Forschern (basierend auf 8 Stunden pro Tag).
Bei Anthropic wurde ein Viertel der Modellbauarbeit Claude selbst übertragen. Die nächsten Modelle werden einfach nacheinander kommen.
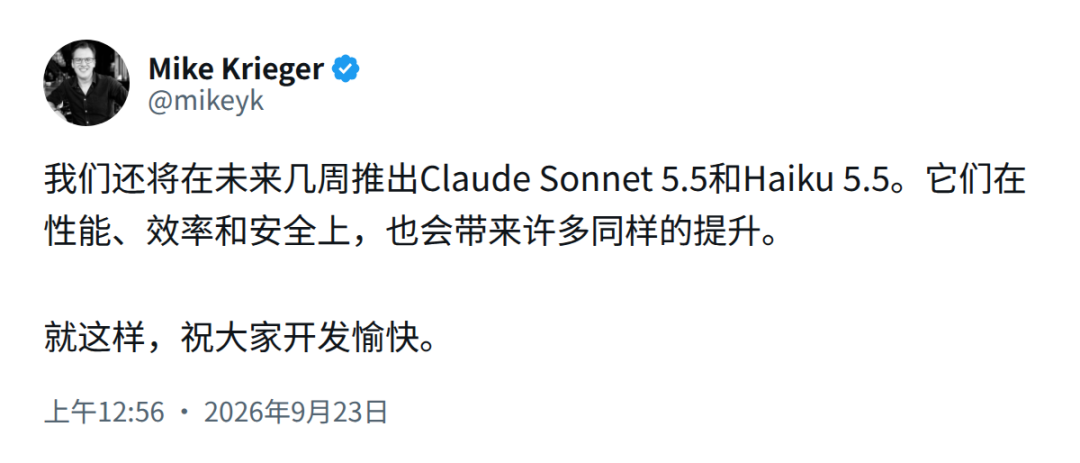
Die Warteschlange hat bereits die Tür erreicht. Mike Krieger von Anthropic hat bekannt gegeben, dass Sonnet 5.5 und Haiku 5.5 in den nächsten Wochen erscheinen werden.
Googles Gemini 4 begann bereits im Juli mit dem „bisher ehrgeizigsten Vortraining“, und die Außenwelt geht allgemein davon aus, dass es gegen Ende des Jahres vorgestellt wird. Mindestens zwei inländische Unternehmen haben ihre Flaggschiffe der nächsten Generation offiziell angekündigt, wobei nur ein Veröffentlichungstermin fehlt.
Die hart erarbeitete „Metaphysik“
Es wird sofort nach zwei Monaten verschrottet
Je schneller das große Modell läuft, desto peinlicher wird es für die Leute, die nachgelagerten Code schreiben.
Sie blieben Ende Juli ein paar Nächte lang wach und haben die Anwendung gerade auf Opus 5 verschoben. Jeder Parameter wurde reibungslos angepasst. Zwei Monate später kam Opus 5.5 heraus, und Sie haben die Benutzeroberfläche freudig geändert – klicken Sie, und einige Anfragen meldeten direkt Fehler.
Wenn Sie sich die aktuellen offiziellen Prompt-Word-Guides dieser beiden Unternehmen ansehen, werden Sie feststellen, dass sie die gleiche Tatsache vermitteln. Viele der alten Eingabeaufforderungen, die Sie für das Modell der vorherigen Generation geschrieben haben, sind zu Altpapier geworden.
Das erste ist die Subtraktion.
OpenAI weist im Astra-Leitfaden klar darauf hin, dass die in der Vergangenheit zu detaillierten Prozessanweisungen nun hinderlich sein werden. Wörter wie „Lesen Sie das Dokument gründlich, bevor Sie den Code ändern“ und „Denken Sie daran, Tests auszuführen“ können alle gelöscht werden.
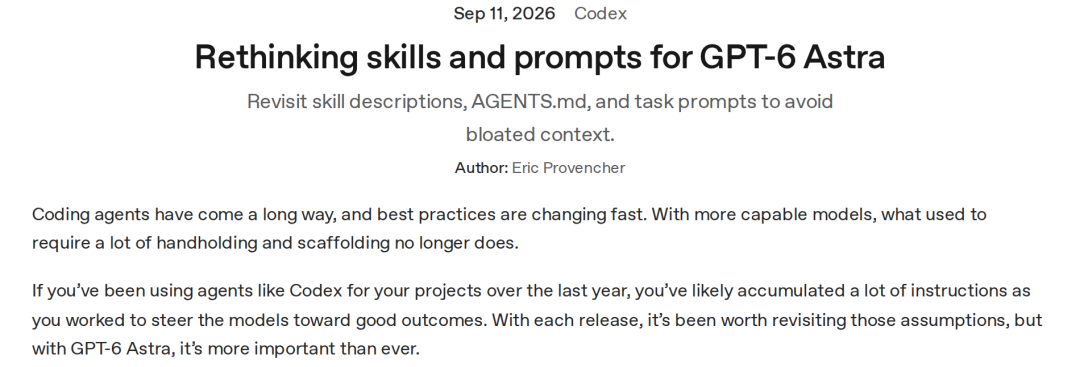
Anthropics Leitfaden meint das auch.
In der Vergangenheit musste den Eingabeaufforderungswörtern oft der Satz „Überprüfen Sie es, nachdem es fertig ist“ hinzugefügt werden, aber Opus 5 kann es bereits selbst überprüfen. Wenn dieser Satz nicht gelöscht wird, kommt es zu einer Überprüfung.
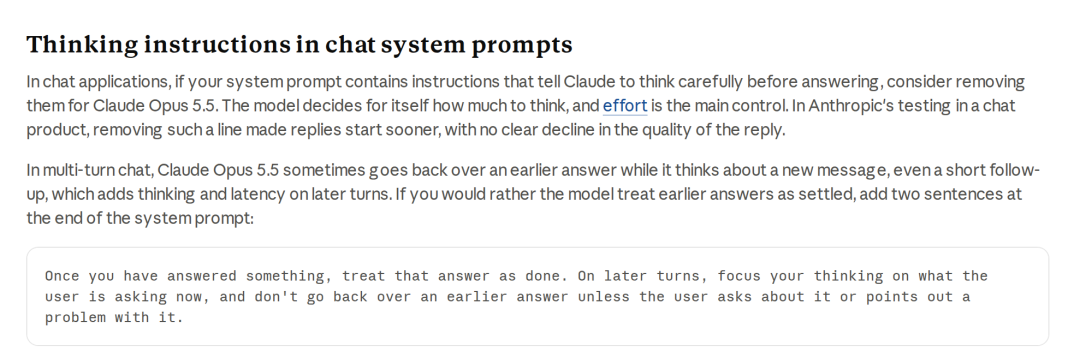
In Opus 5.5 wird empfohlen, den PUA-Satz „Überlegen Sie sorgfältig nach, bevor Sie antworten“ in der Chat-Szene zu löschen. Nach dem Löschen ist die Antwort schneller und die Qualität hat nicht wesentlich nachgelassen.
Nachdem Sie die alten gelöscht haben, müssen Sie neue hinzufügen, da jede Generation ein neues Temperament hat.
Opus 5.5 geht immer gerne zurück und denkt über Fragen nach, die bereits in mehreren Dialogrunden beantwortet wurden, was eine Verschwendung von Rechenleistung darstellt. Der offizielle Patch wurde veröffentlicht: „Was beantwortet wurde, ist Vergangenheit.“
Parameter und Standardwerte ändern sich ebenfalls stillschweigend.
Beim Opus 5.5 wird beim Ausschalten des Denkmodus direkt ein Fehler 400 gemeldet. Ohne das Schreiben des Aufwandsparameters wird die Standardausrüstung von hoch auf mittel reduziert und Kosten und Wirkung werden entsprechend gemischt.
In diesem Zusammenhang besteht der offizielle Vorschlag darin, den Aufwandstest erneut durchzuführen und die alten Einstellungen nicht direkt von Opus 5 zu übertragen.
Eine Reihe von Aufforderungsworten plus eine Reihe von Parametern, jede Generation muss Hautschichten abziehen. Erfolgt die Anpassung nicht, kann die Rechnung stark abweichen.
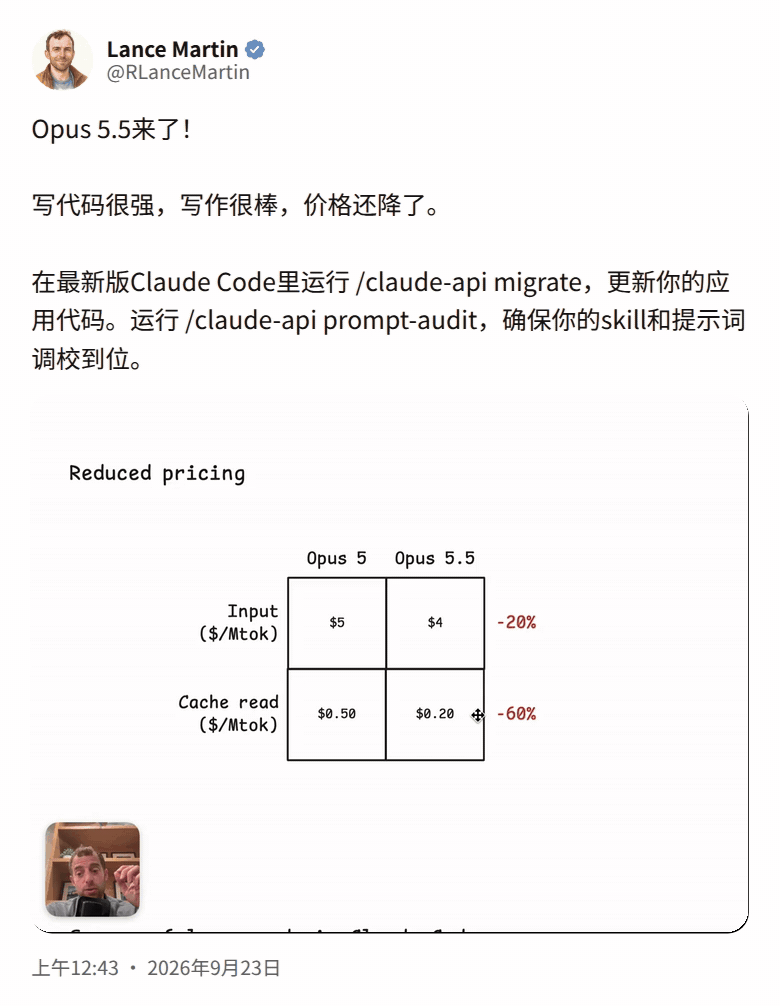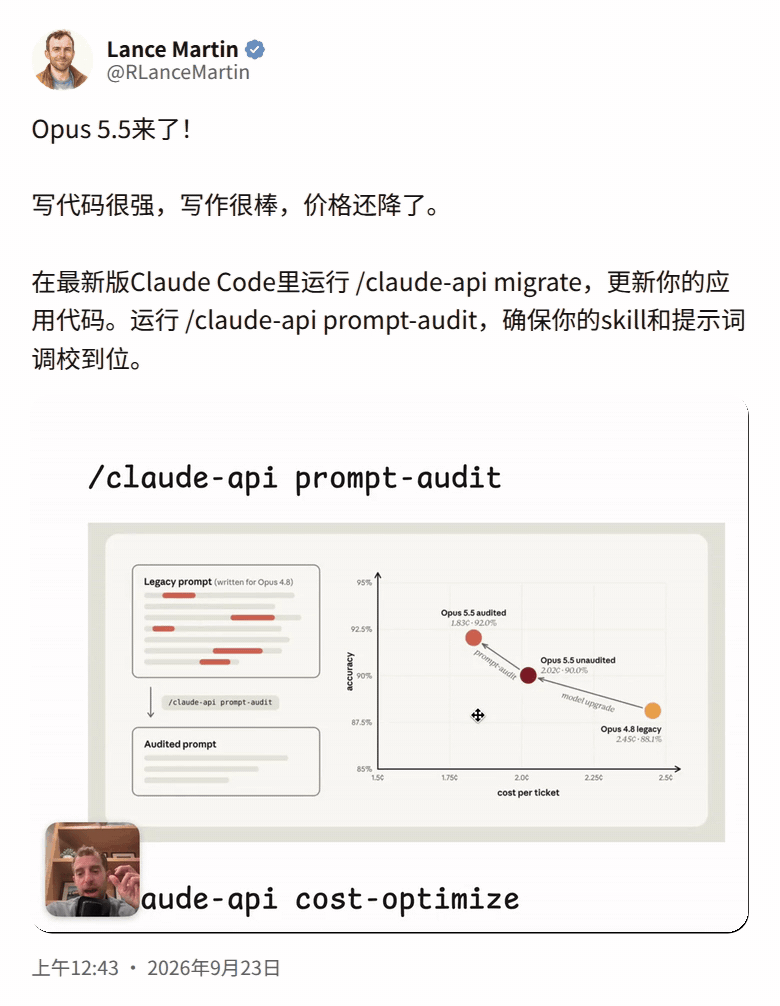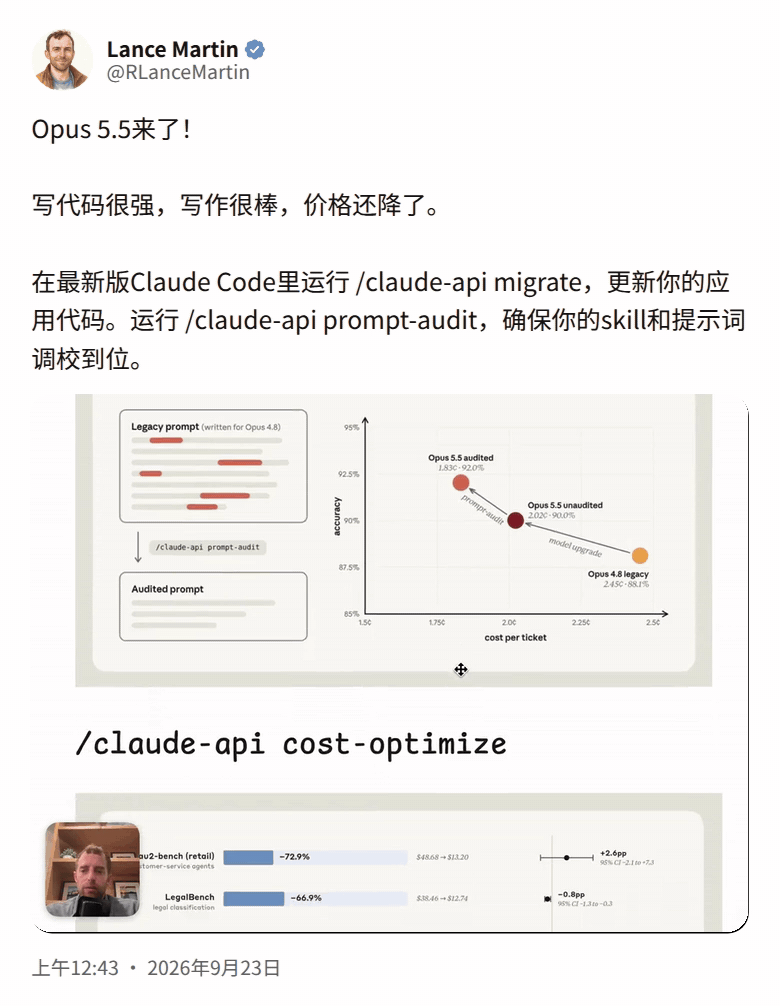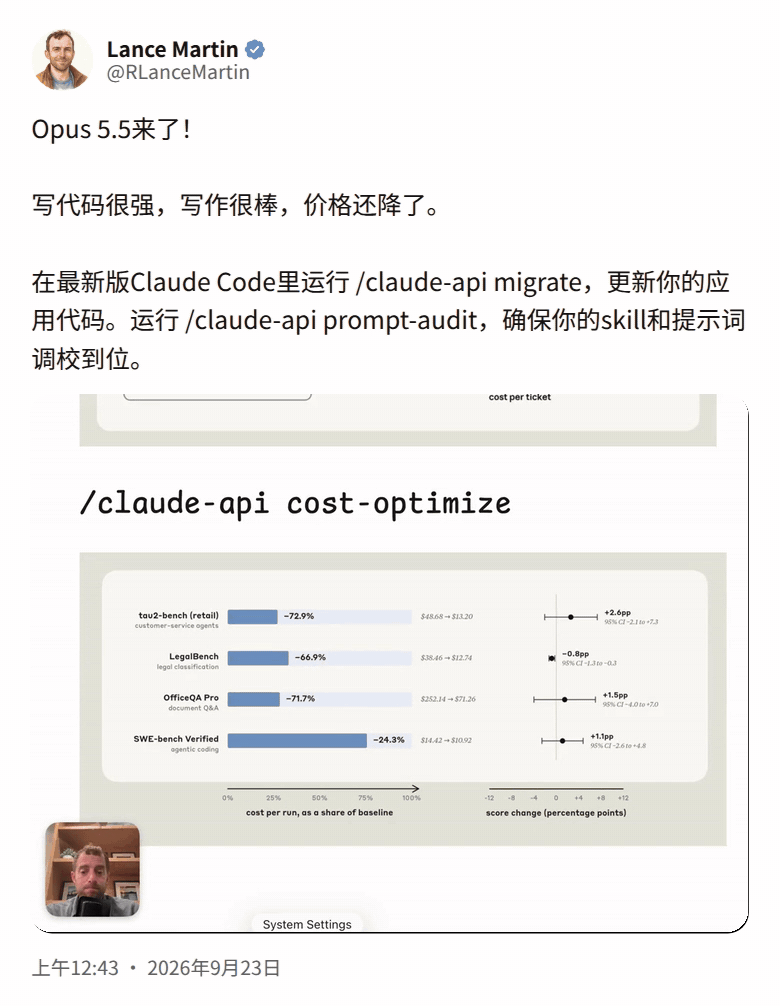
Lance Martin von Anthropic demonstrierte in dem Video, dass ein alter Prompt, der für Opus 4.8 geschrieben wurde, 2,45 Cent pro Arbeitsauftrag kostete und dass es 2,02 Cent kostete, ihn direkt durch Opus 5.5 zu ersetzen. Nach erneutem Waschen mit den offiziellen Werkzeugen stieg die Genauigkeitsrate auf 92,0 % und die Kosten sanken auf 1,83 Cent.
Darüber hinaus verkürzt sich auch die Lebensdauer des Modells selbst.
OpenAI hat dieses Jahr 9 Ankündigungen zur Einstellung der Funktion veröffentlicht, die mehr als 40 Modelle und Funktionen betreffen.
Dazu gehört GPT-5.5, das erst am 23. April veröffentlicht wurde, am 14. Oktober aus ChatGPT und Codex entfernt wird und weniger als ein halbes Jahr überlebt hat.
Auch die Evals-Evaluierungsplattform von OpenAI wird Ende November geschlossen.
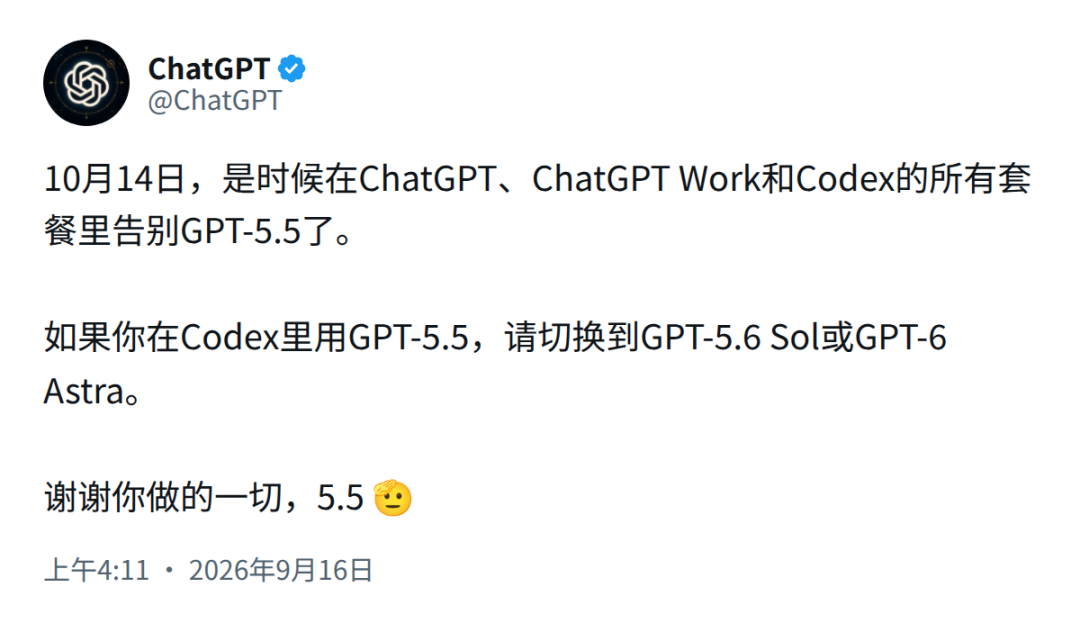
Die Liste bürsten? Innerhalb eines halben Jahres wurde ein neuer Satz Testfragen ausgearbeitet
Es macht nichts, wenn die Leute nicht mithalten können, jetzt reichen selbst die „Prüfungsunterlagen“ nicht mehr aus.
Im März dieses Jahres wurde ARC-AGI-3 eingeführt, das angeblich auf KI spezialisiert ist und den IQ ohne Auswendiglernen von Fragen testet. Gemini 3.1 Pro, das damals den ersten Platz belegte, erreichte nur 0,37 %, während Menschen 100 % erreichten.
Am 3. September betrat GPT-6 Astra den Prüfungsraum, erzielte im Standardtest eine Punktzahl von 62,7 % und erreichte bei Verwendung eines bestimmten Frameworks direkt 99,9 %. In 96 % der Level benötigte es weniger Schritte als ein Mensch.
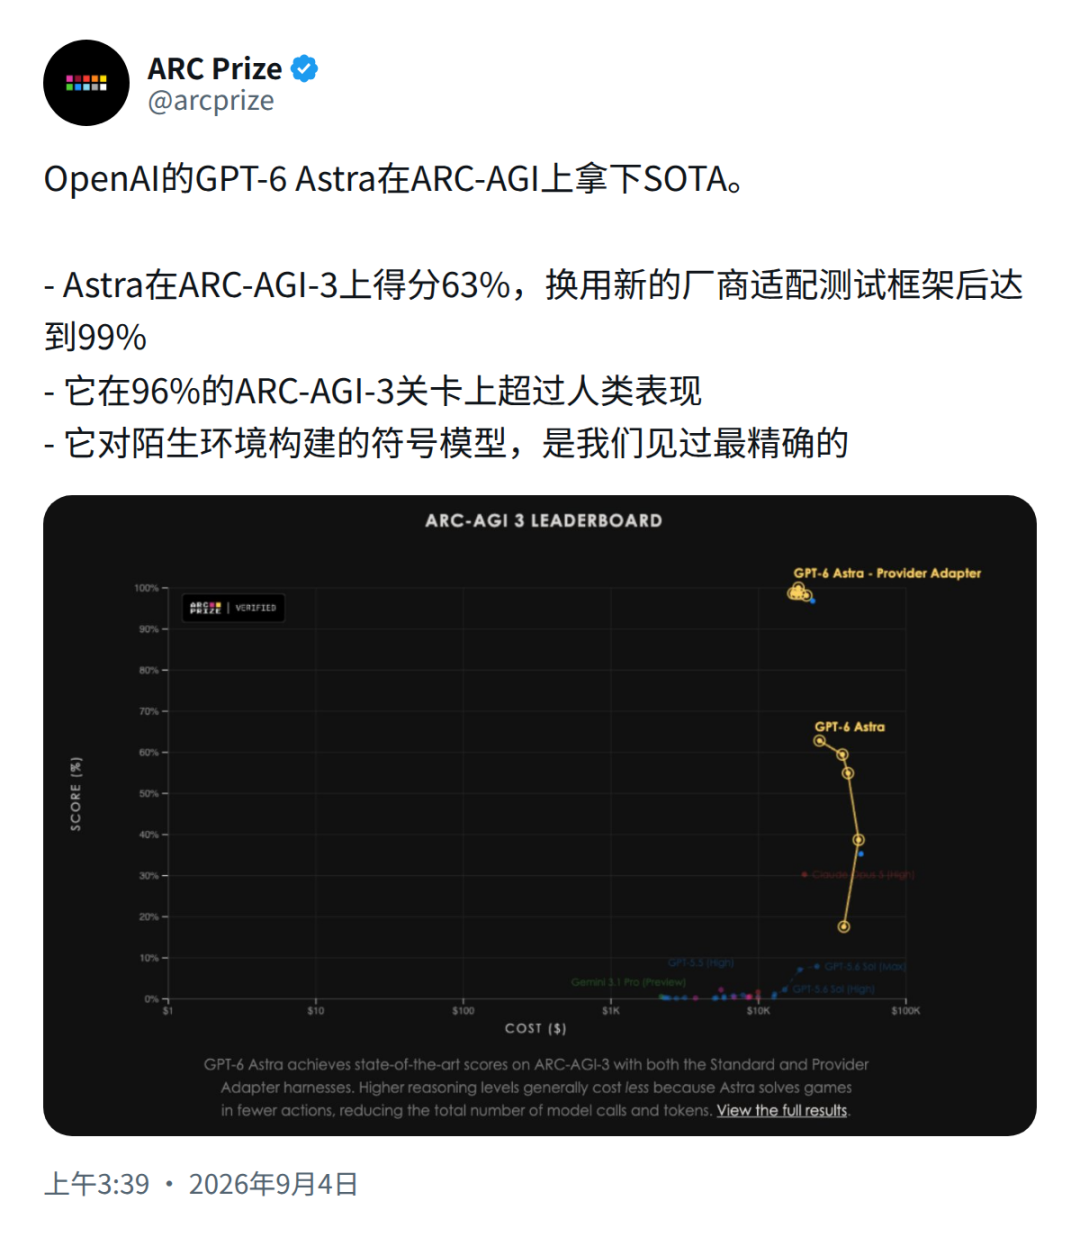
Eine neue Reihe von Testfragen wurde innerhalb eines halben Jahres erstellt, und die ARC-Beamten haben begonnen, darüber nachzudenken, wie sie die nächste Generation von Bewertungen erstellen könnten.
Auf der Codierungsliste (Next.js) erreichten Sol, Opus 5.5 und Fable 5.1 alle 97 % und belegten damit den ersten Platz; Auf der Schreibliste führt Opus 5.5 Fault mit 307 Punkten den zweiten Platz an.
Dieser Wert ist der größte Einzelsprung in der Geschichte der Liste. Nachdem er es gelesen hatte, meinte der Blogger, es sei ungeheuerlich, und dachte fast, es gäbe einen Fehler in seinem eigenen Benchmark!
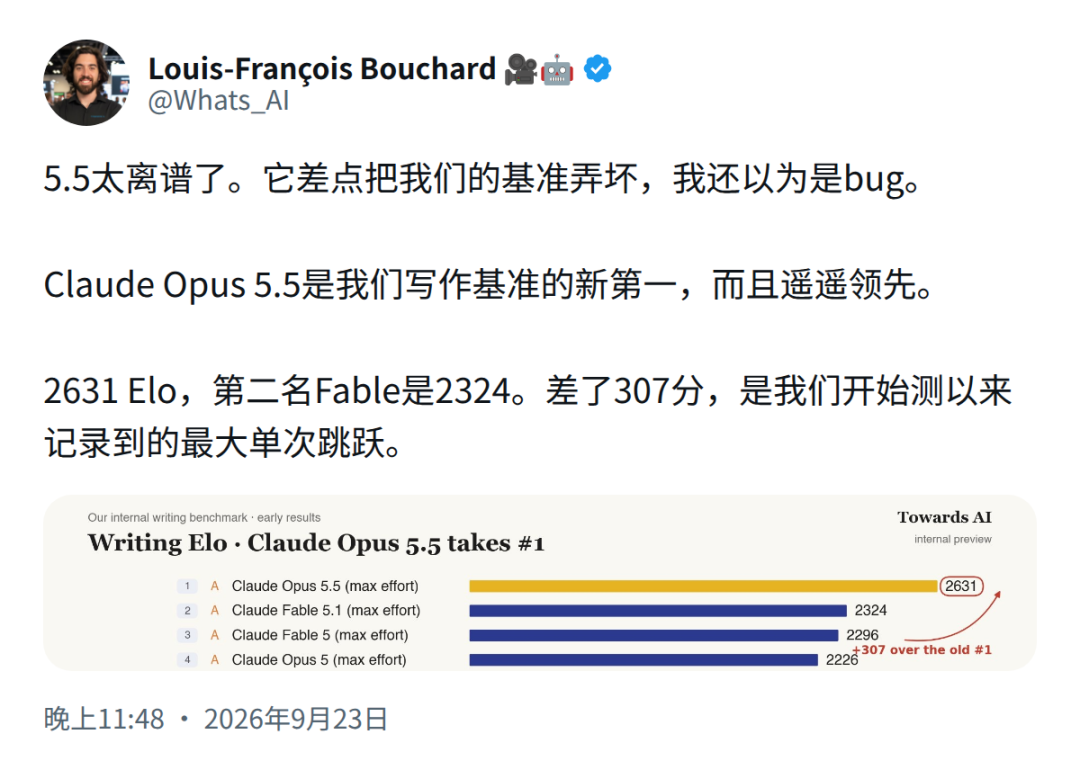
Jedes Mal, wenn ein neues Modell auf den Markt kommt, müssen Entwickler den Testprozess wie ein Sisyphos von vorne beginnen.
Wenn es im nächsten Jahr tatsächlich den Punkt „ein Update pro Tag“ erreicht, werden die von Ihnen heute angepassten Aufforderungswörter und Agent-Links nach dem aktuellen Tempo möglicherweise nicht länger als eine Woche halten.
Zum ersten Mal hat die Geschwindigkeit des Modellaustauschs die Geschwindigkeit der menschlichen Anpassung daran vollständig übertroffen.
Die langsamsten Läufer heutzutage sind tatsächlich diejenigen, die KI nutzen.
Kommentare