
Zusammenfassung:
Microsoft gab die vorläufigen Untersuchungsergebnisse des weit verbreiteten Ausfalls von Microsoft 365 vom 12. bis 13. November bekannt und gab an, dass der Ausfall durch einen Windows-Serverfehler verursacht wurde, der seit mehreren Monaten inaktiv war, Teams-Verkehrsumschaltung und eine Verringerung der verfügbaren Kapazität des Gateways. Der Unfall dauerte von 16:20 UTC am 12. November bis 16:10 UTC am nächsten Tag, also fast 24 Stunden.
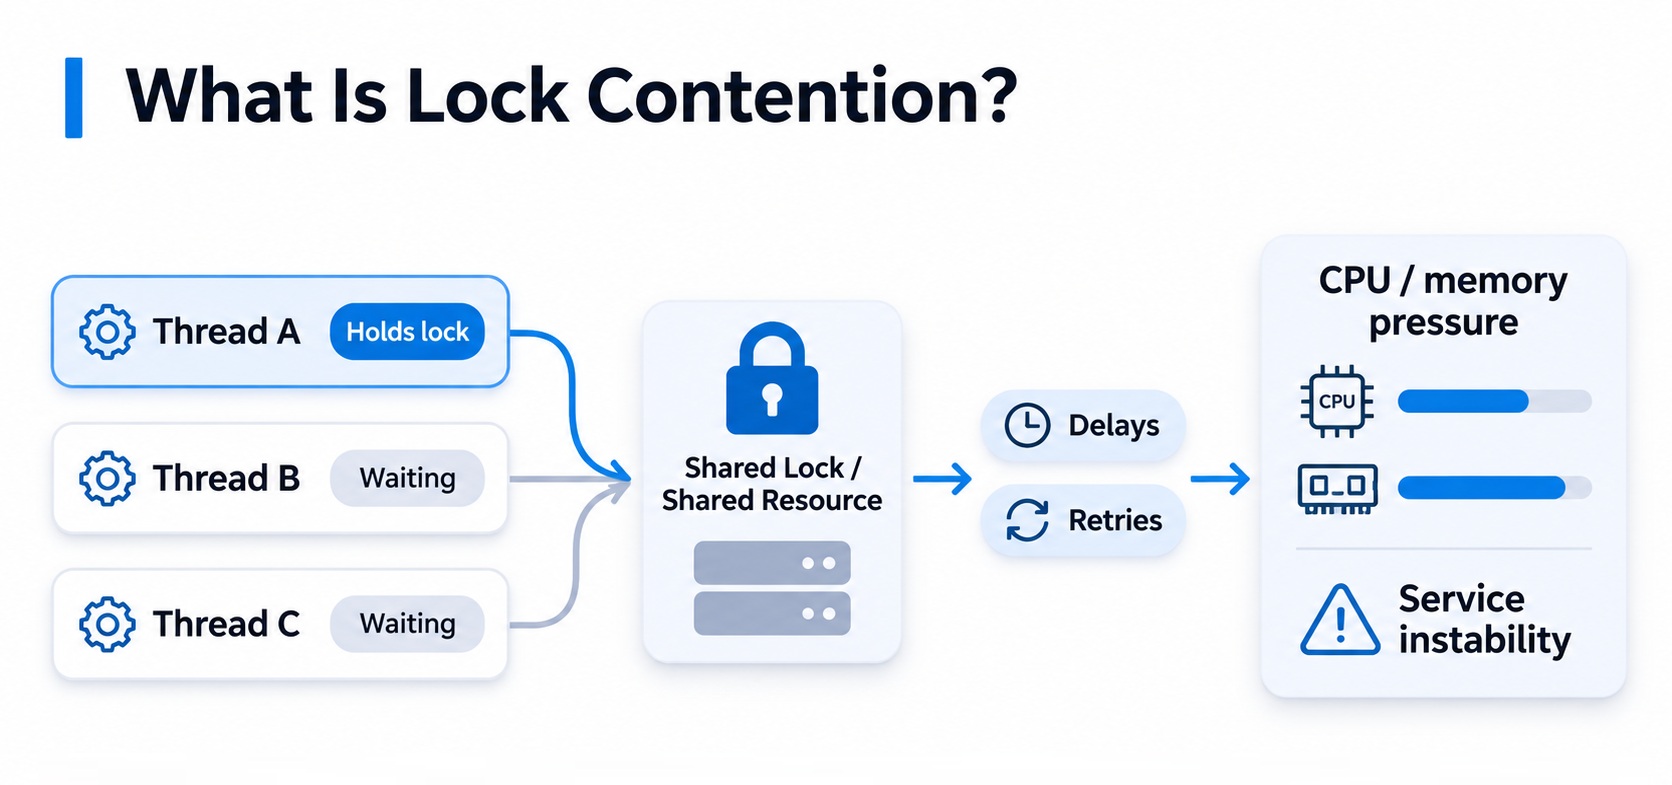
Microsoft sagte, der Fehler sei auf einen Fix zurückzuführen, der im Juli dieses Jahres für Microsoft 365 Network Gateway Server bereitgestellt wurde. Unter einer bestimmten Last kommt es in Windows-internen Prozessen zu Sperrenkonkurrenz, wodurch die CPU- und Speicherressourcen des Servers allmählich erschöpft werden und schließlich nicht mehr reagieren. Das Problem war zuvor unentdeckt geblieben, unter anderem weil die Testumgebung von Microsoft Hardware mit weniger Kernen verwendete; Die Untersuchung ergab, dass Sperrenkonflikte auf neueren Servern mit mehr Kernen eher zunehmen. Microsoft betonte, dass dieser Fehler und die damit verbundenen Korrekturen nur die Gateway-Infrastruktur von Microsoft 365 betreffen und keine Auswirkungen auf andere Windows-Bereitstellungen haben.
Ungefähr 15 Stunden vor dem Ausfall wechselte der Teams-Verkehr vom Backup-Netzwerk-Gateway zum primären Gateway, das mit Exchange Online geteilt wurde, wodurch sich die Verkehrsmuster änderten und die Last zunahm. Gleichzeitig waren etwa 14 % der Serverkapazität des Gateways aufgrund eines anderen Problems am Vortag vorübergehend nicht verfügbar. Microsoft sagte, dass diese beiden Faktoren allein keine Auswirkungen hatten, aber in Kombination mit latenten Fehlern lösten sie eine Serverüberlastung aus.
Nachdem der Server die Antwort verloren hat, leitet das Verkehrsmanagementsystem die Anfrage an andere normale Knoten weiter, was die verbleibenden Server stärker unter Druck setzt und der Fehler sich nach und nach ausbreitet. In weniger als zwei Stunden antworteten mehr als 80 % der Gateway-Server nicht; Die ursprünglich eingesetzten Schutzmaßnahmen zur Eingrenzung von Fehlern in verschiedenen Regionen konnten eine Ausbreitung des Problems über Regionen hinweg nicht verhindern. Laut Microsoft war der schwerwiegendste Vorfall während des Vorfalls Exchange Online, bei dem viele Benutzer nicht auf ihre Postfächer zugreifen oder E-Mails nicht normal senden und empfangen konnten; Auch Dienste, die auf Exchange-Funktionen angewiesen waren, wie Teams, Copilot, SharePoint und OneDrive, waren in unterschiedlichem Maße betroffen, und Chat- und Konferenzfunktionen einiger Dienste konnten weiterhin genutzt werden.
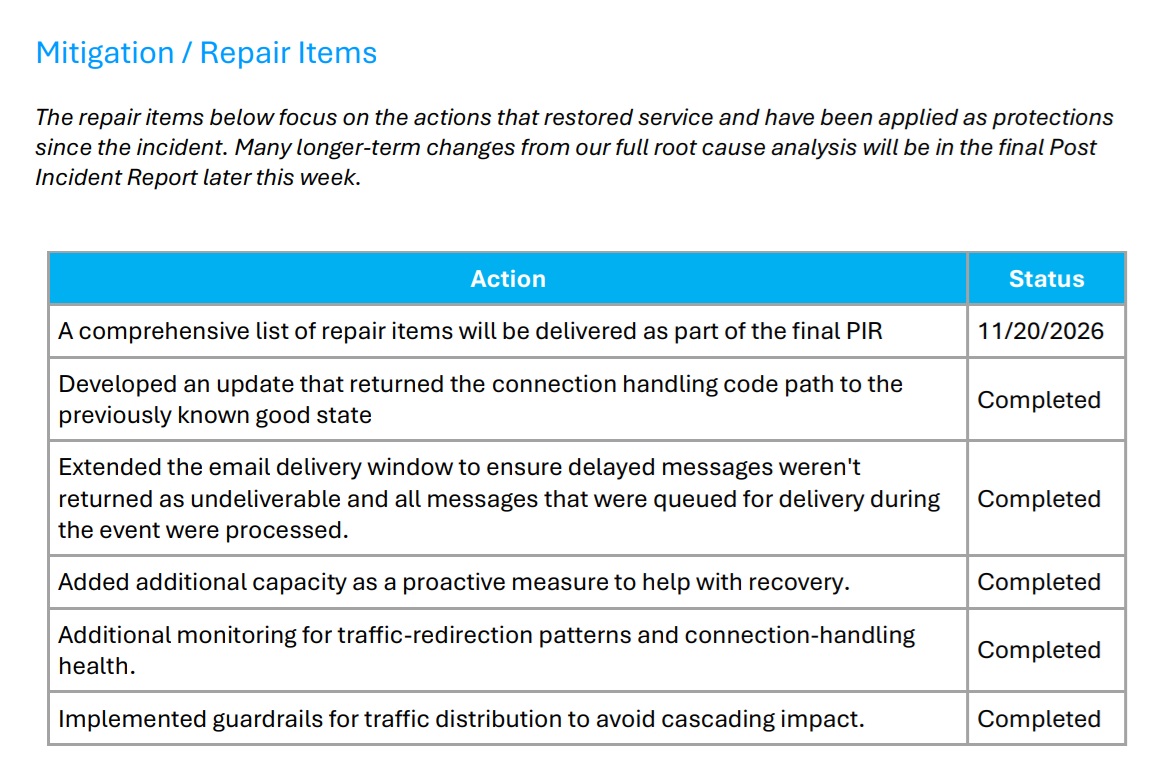
Der Wiederherstellungsprozess zog sich in die Länge, da der neu gestartete Server möglicherweise wieder nicht mehr reagierte, sobald er den zurückgebliebenen Datenverkehr empfing, und da der Fehler schon vor Monaten bekannt wurde, konnten regelmäßige Rollbacks und Funktionsumschaltungen nicht schnell rückgängig gemacht werden. Die Techniker stellten schließlich den Verbindungsverarbeitungscode auf die vorherige stabile Version wieder her, reparierten ihn dann stapelweise, starteten den Server neu und stellten den Datenverkehr nach und nach wieder her. Microsoft gab an, dass die globalen Webmail-Dienste am 13. November um 14:17 Uhr wieder auf das erwartete Niveau zurückgesetzt wurden, und um 16:10 Uhr an diesem Tag wurde bestätigt, dass Benutzer nicht mehr direkt von dem Vorfall betroffen waren; Verspätete E-Mails wurden anschließend bearbeitet.
Microsoft hat die Serverkapazität und -überwachung erhöht, Maßnahmen zum Schutz der Datenverkehrsverteilung hinzugefügt und die Wartezeiten für die E-Mail-Zustellung verlängert, um zu verhindern, dass zurückgebliebene E-Mails fälschlicherweise als Zustellungsfehler interpretiert werden. Das Unternehmen sagte, es gebe derzeit keine Hinweise darauf, dass der Vorfall böswillige Aktivitäten oder Agenten der künstlichen Intelligenz beinhaltete, und plant, vor dem 20. November einen Abschlussbericht nach dem Vorfall zu veröffentlichen, um langfristige Korrekturmaßnahmen zu ergänzen.
Kommentare